Google 发布 Gemini 3.8 Live 双模型,实时语音可边聊边异步调用工具丨日报
本期编辑:@三水、@鲍勃
01 有话题的技术
1、Google 发布 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 双模型:实时语音可边聊边跑异步 Tool Call,Extended Thinking 支持后台多步推理
Google 推出 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款实时语音模型。相比上一代 Gemini 3.1 Flash Live,最大的工作流变化是:3.8 Live 开始支持异步函数调用,工具执行期间无需暂停整场语音对话;Extended Thinking 则进一步把可配置的多步推理放到后台,让模型在持续说话的同时完成复杂分析和工具任务。
Gemini 3.8 Live 可以「边聊边跑工具」: 上一代 3.1 Flash Live 的函数调用仍是顺序执行,模型要等工具返回后才能继续响应;3.8 Live 新增异步函数调用,API、搜索或其他工具可以在后台运行,语音会话本身继续进行。模型同时支持视觉输入和 97 种语言,并可在对话中自动切换语言。
Extended Thinking 把深度推理放进实时语音后台: 开发者可设置
low / medium / high三档推理强度。模型处理复杂问题或多工具任务时,可以先用「我正在查……」之类的自然语音回应用户,再继续在后台推理、调用工具,并通过语音持续汇报任务进展,而不是出现长时间沉默。实时 Agent 的会话状态也因此发生变化: 在 Extended Thinking 中,
turnComplete: true只表示当前一句话说完,并不代表整个任务结束;开发者需要通过新的interaction_status判断模型仍处于IN_PROGRESS,还是已经真正回到IDLE。这让一个用户请求可以横跨多次语音输出、推理和工具调用。Extended Thinking 更明显地面向 Agent 任务完成: Google 公布的数据中,该模型在 Artificial Analysis Speech-to-Speech Quality Index 得分 82.6,在 τ-Voice 智能体任务上达到 68.6%,Sierra τ-Voice-banking 为 35.1%,Big Bench Audio 为 97.7%。
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/
2、TTS Arena 联合 LAION 上线 Voice Acting Arena:同场景盲测两款 TTS,开始评「演得像不像」而不只是「说得像不像」
TTS Arena 与 LAION 推出 Voice Acting Arena,把 TTS 人类偏好评测从传统的自然度、音色质量进一步扩展到配音表演能力。用户会听到两个匿名模型演绎同一段场景和剧本,再从整体表演、是否遵循导演指令、情感是否真实等维度进行比较;部分任务还包含笑声、倒吸气、抽泣等非语言声音。团队希望通过持续收集这种 A/B 偏好数据,建立面向 Voice Acting 模型的长期评测,而不是只比较「哪个声音更像真人」。
https://huggingface.co/spaces/TTS-AGI/voice-acting-arena
3、NVIDIA 为全双工 Speech-to-Speech 模型补上实时转录:并行加一个轻量 ASR Head,边听边说时也能输出用户文字
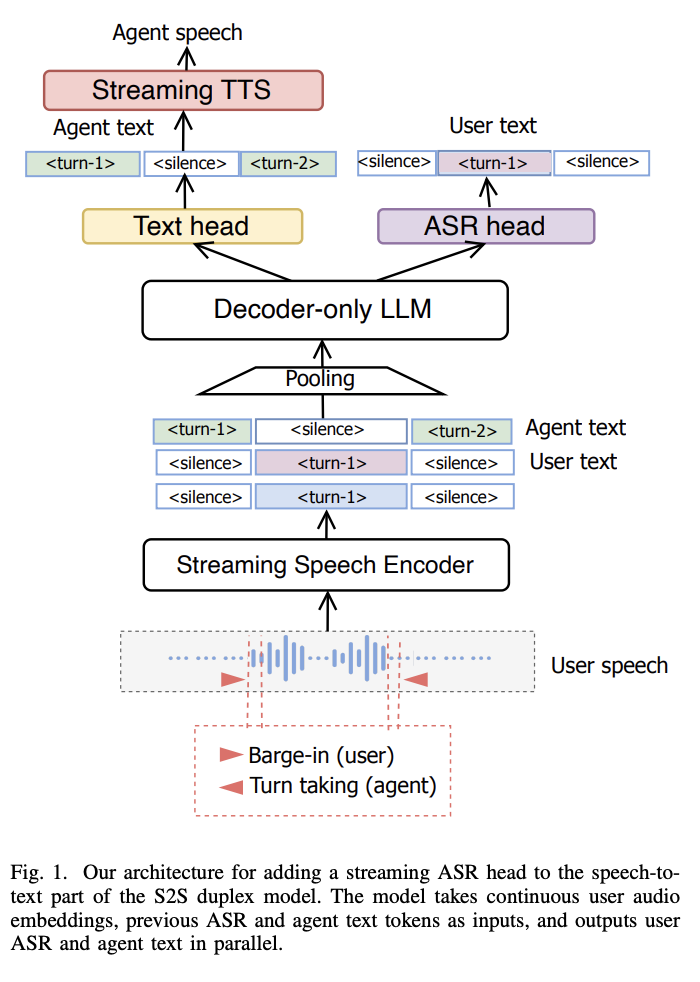
NVIDIA 研究团队提出一种给现有全双工 Speech-to-Speech 模型增加流式用户转录的方法:在原有 Agent 文本输出 Head 旁边并行加入一个轻量级 ASR Head,无需大改基础架构,就能一边维持同时听说、话轮切换和打断处理,一边持续输出用户语音的文字转录。对于 Voice Agent,这意味着原生 S2S 不再只是「听懂后直接说回来」,还可以同时留下可用于日志、字幕、质检和后续工具调用的文本轨迹。
不是再外挂一套独立 ASR: 新 ASR Head 与 Agent 文本 Head 并行工作,复用全双工模型已有的语音表示,只增加少量参数,也不需要显著修改原有 S2S 架构。
转录不会打断全双工能力: 论文强调加入流式 ASR 后,模型仍保留 turn-taking 和 barge-in 等实时对话能力,不需要在「自然全双工」与「拿到文字稿」之间二选一。
在全双工框架内,流式 ASR 平均 WER 为 10.21%: 同一架构单独训练成流式 ASR 后达到 7.73% WER,说明这套并行 Head 本身也具备较强的转录能力。
解决的是 Voice Agent 的可观测性问题: 直接 S2S 虽然减少了 ASR→LLM→TTS 级联,但也容易失去明确的用户文本中间结果;把实时转录重新并入模型后,开发者可以更方便地做会话记录、无障碍字幕和质量监控。
https://arxiv.org/abs/2609.15759
4、Lemn Lab × EleutherAI 开源 BuzzASR:不给一个模型塞 102 种语言,而是为每种语言单独训练 Whisper 专家
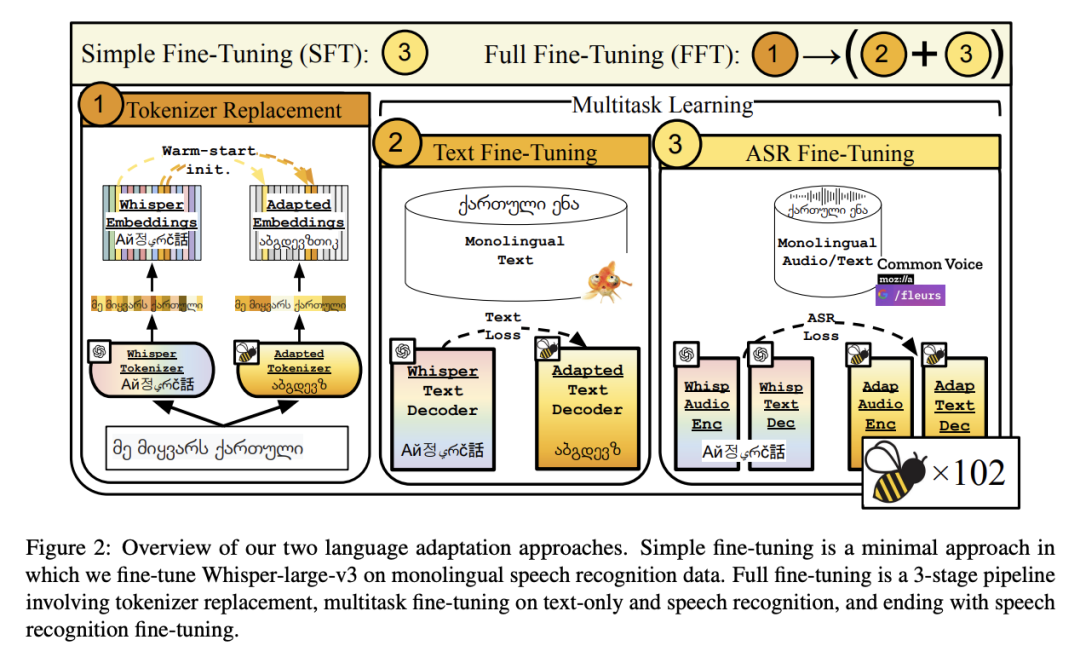
加州大学圣地亚哥分校的 Lemn Lab 联合 EleutherAI 发布 BuzzASR,一次开源 102 个单语 ASR 模型。每个模型都从 Whisper-large-v3 单独微调,只负责一种语言,试图解决大型多语言 ASR 在低资源语言上「什么都会一点、但很多语言都不够准」的问题;该工作已被 EMNLP 2026 接收。
核心思路是「一个语言一个模型」: BuzzASR 不是一个支持 102 种语言的统一模型,而是一组 102 个约 1.55B 参数的 Whisper-large-v3 专家模型。论文报告,在 102 种语言中有 77 种优于原始 Whisper-large-v3,平均字符错误率降低超过 2.8 倍。
27 种语言达到开源系统最佳结果: 在 FLEURS + Common Voice 综合测试上,BuzzASR 在 27 种语言上超过论文比较的 Whisper、Omnilingual 1B/7B、MMS、Qwen3-ASR、Cohere Transcribe 等开放系统。粤语、旁遮普语、蒙古语、韩语等都有明显提升。
不只是普通单语微调,还针对部分语言换掉 Whisper 的多语言 Tokenizer: 团队为部分语言采用本地语言词表,并加入纯文本多任务训练,再进行 ASR 微调;相比 Whisper 的多语言 BPE,论文报告 Token 压缩率平均提升 3.3 倍,最高达到 21.7 倍。
102 个模型已经全部开放: 开发者可以直接通过 Transformers 加载对应语言模型,各模型采用 MIT License。但它们是单语专家,并不适合需要在同一次输入里自动处理多语言或语言混说的场景。
https://lemn-lab.github.io/buzz-asr/
02 有亮点的产品
1、实时视觉交互平台 Flam 完成 4000 万美元 B 轮:让视频、3D 与视觉 Agent 在播放中实时响应用户
Flam 完成 4000 万美元 B 轮融资,由 QED Investors 领投,Claypond Capital、Datadog CEO Olivier Pomel、Martin Chavez、Venky Harinarayan 等参投,累计融资达到 6200 万美元。相比传统生成式内容先生成、再播放,Flam 更强调低延迟互动内容:视频、3D 场景和视觉 Agent 可以在展示过程中根据点击、语音或摄像头输入实时变化。
Flicks 把「视频」变成可动态切换的内容: 同一段视频中的人物、商品或场景可在播放过程中切换。Flam 官网目前标注切换延迟 <10 ms;报道中的 50 ms 指的是视频首次缓冲时间,两者不是同一个指标。
Airboards 把 3D 内容直接流进手机摄像头: 用户无需安装 App,即可在摄像头界面中加载高保真 3D 内容,并通过触控、语音和触觉反馈进行交互,首次缓冲时间约 300 ms。
Visual Agents 把实时对话做成「视频通话式」角色: Flam 可从单张图片生成高拟真视觉角色,并结合自研 LLM、TTS 和人脸动画模型进行实时对话。官网目前给出的延迟指标为约 800 ms,支持 60+ 语言。
底层不是单一模型,而是一套互动内容模型栈: 包括 26B MoE 语言模型 Falcon、60+ 语言 TTS 引擎 Finesse、身份保持视频模型 Fantom,以及面向对象、人物和环境替换的 Forge 等。
https://flamapp.ai/
2、DeepL Voice 推出跨 Zoom、Teams、Meet 的语音翻译桌面应用:实时翻译时可保留说话人的音色、语气与节奏
DeepL 更新 DeepL Voice,推出适用于 Windows 和 Mac 的统一桌面应用,不再依赖单个平台插件,即可跨 Zoom、Microsoft Teams 和 Google Meet 提供实时字幕与语音对语音翻译。更重要的变化是,新一代 Voice 模型开始在跨语言转换时保留说话人的声音身份和表达方式:不同说话人仍可被区分,语气、节奏、语速、重音以及犹豫、兴奋、紧迫感等表达也会尽量随翻译保留下来。
「保留声音」不是预先做 Voice Clone: DeepL 表示,该能力会在实时翻译过程中匹配说话人的声音和表达,不需要保存语音样本,也不会建立供后续使用的长期声音档案;目前首先支持 12 种语言。
一套桌面应用覆盖三大会议平台: DeepL Voice 会检测当前 Zoom、Teams 或 Meet 会议,用户可以在实时翻译字幕与翻译语音之间切换,不需要为每个平台单独部署一套体验。
语音对语音翻译从测试进入正式可用: 在线会议中的 voice-to-voice translation 现已 GA,和此前的实时字幕一起通过桌面应用提供;浏览器端给外部参会者使用的语音对语音功能仍处于 Beta。
https://www.deepl.com/en/blog/deepl-voice-preserves-your-voice-across-languages
03 有态度的观点
1、黄仁勋活动现场免提接听特朗普电话,双方隔空探讨 AI
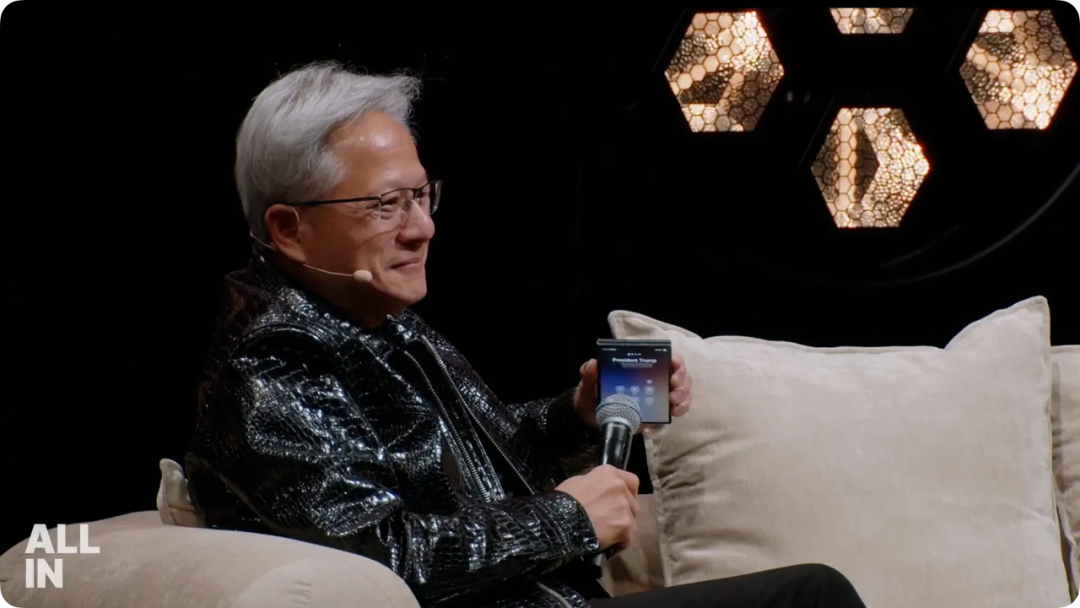
9 月 14 日在洛杉矶举行的 All-in Summit 峰会上,英伟达 CEO 黄仁勋在演讲期间接听了美国总统特朗普打来的免提电话。
通话中,特朗普将 AI 末日论称为「骗局」,表示机器人绝不可能统治世界,并批评了放缓 AI 发展速度的主张,认为此类呼吁出于政治动机。
特朗普还提到自己在麻省理工学院任教四十余年的叔叔约翰·乔治·特朗普,称自己凭借家族基因遗传也具备相应天赋,因而深谙 AI 领域;
黄仁勋在现场回应称「难怪你对 AI 这么懂」。
另据《金融时报》报道,黄仁勋在 Salesforce 年度 Dreamforce 大会上就 AI 安全与监管议题表达了不同路径。
针对此前 Anthropic CEO Dario Amodei 呼吁行业放缓新模型开发速度,以及马斯克和 OpenAI CEO Sam Altman 公开支持控制研发节奏的提议,黄仁勋表示不同意将减速作为行业通用方案。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、Happy prompting!
( @aquavoice@X)
2、各位 RTE 社区的开发者朋友  我们在做一份语音 Agent 开发生态的调研
想了解大家在落地 Voice Agent 时,实际都在用哪些 Skill?几道选择题,2-3 分钟搞定。欢迎来填,也欢迎转给身边做语音的开发者~
https://rcnxnwjad4la.feishu.cn/share/base/form/shrcn49HlEu1ZWeLIw6OLfYPgMg
3、 iRTE2026 定档啦!Voice Agent Builder 们,10 月北京集合~
今年从对话式 AI 一路聊到实时智能,现场有 15+ 论坛、100+ 场深度演讲,汇聚 150+ 全球技术领袖和行业专家,全双工+交互式模型、实时互动世界模型、AI 硬件、AI Coding 工具等方向都会集中开聊。
 贾扬清也将返场 iRTE 大会,带来对 AI 行业前沿趋势和技术演进的最新观察~
 目前大会门票限时免费开放!
想来现场听技术、认识同行的开发者,可以先把票薅上
 时间:10 月 23–24 日
 地点:北京悠唐皇冠假日酒店
限免结束后将恢复收费,建议先报名占位 
定档!从对话式 AI 到实时智能,Voice Agent Builder 的年度春晚 iRTE2026 来了丨 10 月 23-24 日,北京见!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考