Lokutor 发布 CPU 原生 Voice Agent 栈,可部署在本地丨日报
本期编辑:@三水、@鲍勃
01 有话题的技术
1、Voice AI 公司 Lokutor 推出 CPU 原生 Voice Agent 技术栈:转写、轮次判断与语音合成无需 GPU,可部署到本地和设备端
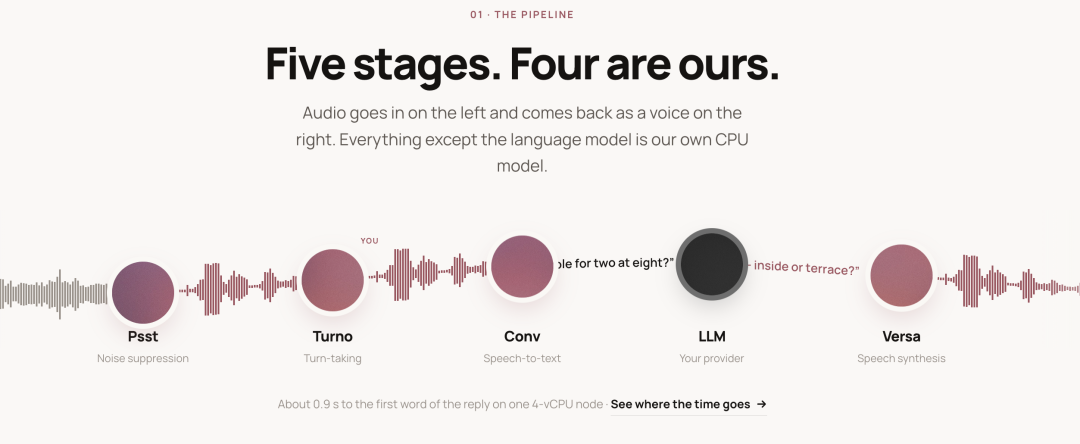
马德里的 Voice AI 公司 Lokutor 正在把整套语音智能体链路重做到普通 CPU 上。其五段式语音链路中,降噪 Psst、轮次判断 Turno、语音转写 Conv 和语音合成 Versa 都由 Lokutor 自研,只有 LLM 接第三方模型;整条链路不依赖 GPU,可运行在云端、本地服务器或设备端。
整条实时语音链路可在 CPU 上运行: Lokutor 将降噪、Turn-taking、STT 和 TTS 都针对 CPU 推理设计。官网数据显示,在单个 4-vCPU 节点上,从用户说完到回复首个语音约 0.9 秒;加入轮次检测后约 1.3 秒,流式 TTS 首段音频约 120 ms。
Turn-taking 不再主要依赖静音超时: Turno 直接分析原始音频,区分真正的打断和类似 「mhm」 的附和,因此可以决定智能体应该继续说还是让出话轮。
同一套模型可以下沉到本地和设备端: 因为不依赖加速卡,Lokutor 支持 x86、ARM64 本地部署,也可以直接运行在机器人、车载等设备已有算力上,并支持离线运行。
开发者可以直接接入完整 Voice Agent 或单独调用语音模块: Lokutor 提供 JavaScript、Python SDK、REST 接口和 Pipecat 集成,也把 Conv 转写、Psst 降噪等能力作为独立接口开放。
https://lokutor.com/
2、SpaceXAI 发布语音转写模型 Grok Voice Transcribe 2.0:多语言短指令 WER 从 20.6% 降至 6.8%,旧版 API 无需改代码
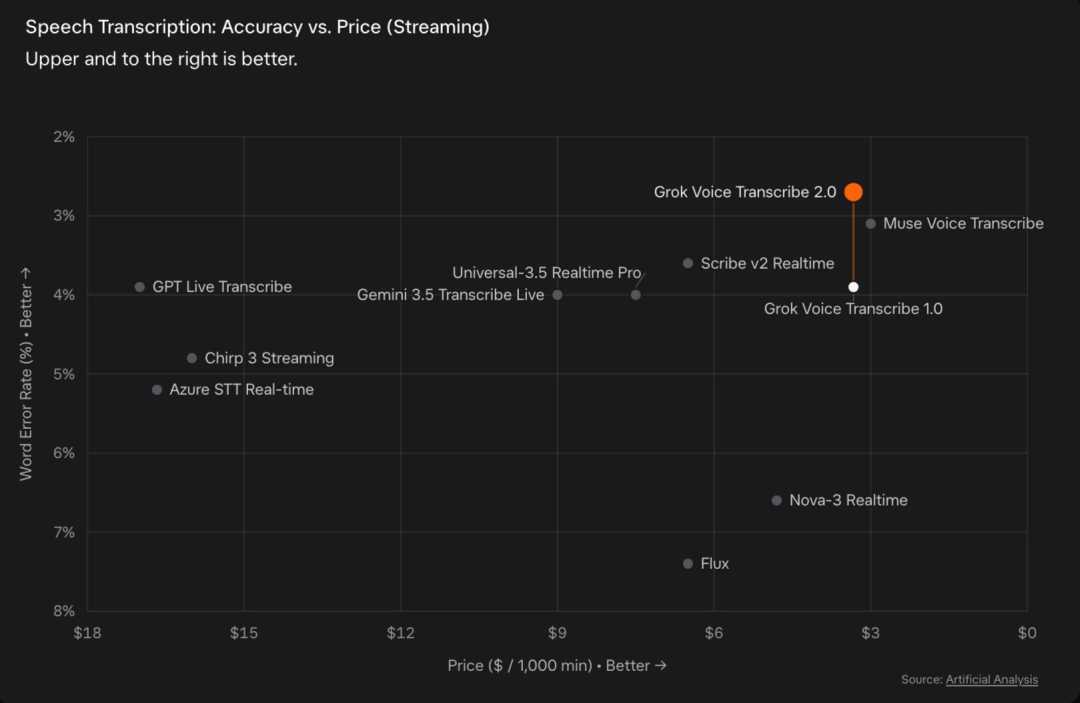
SpaceXAI 发布 Grok Voice Transcribe 2.0,重点提升电话、对话、账号信息和多语言短指令等真实语音场景的转写准确率,其中多语言是相比 1.0 提升最大的部分。现有 Speech-to-Text API 接入无需修改代码即可获得新版准确率提升。
多语言短指令 WER 从 20.6% 降至 6.8%: 模型可自动识别数十种语言,并在同一段录音中跟随语言切换;在涵盖 19 种语言的短语音指令测试中,WER 相比 1.0 明显下降。
真实场景准确率全面提升: SpaceXAI 在客服电话、Grok 对话、电话号码/邮箱/地址等口述信息,以及多语言短指令四组内部生产数据上测试,2.0 均优于 1.0;在 Artificial Analysis 的 32 个流式转写模型榜单中,官方称其准确率排名第一。
价格不变,原有 API 可直接升级: 批量转写仍为 0.10 美元/小时,流式转写为 0.20 美元/小时;说话人分离、词级时间戳、关键词偏置等能力继续包含在价格内。
https://x.ai/news/grok-voice-transcribe-2
3、Rust WebRTC 栈 webrtc.rs 发布 v0.21.0:进入 1.0 RC,公共 API 基本冻结并补齐拥塞控制、抖动缓冲与 FlexFEC
webrtc.rs 发布 webrtc 和 rtc v0.21.0,官方将其视为事实上的 1.0.0-rc.1:下一版本计划直接进入 1.0,期间两个 crate 的公共 API 原则上不再做破坏性修改,除非遇到无法兼容修复的重大 bug。
1.0 API 冻结前的核心工作已经完成: v0.21.0 完成 API 可扩展性审查,并在 CI 中加入
cargo-semver-checks;从 0.21.x 到 1.0.0,允许 bug 修复和增量能力,但默认不再接受破坏性 API 变更。此前列为候选项的媒体能力大多已落地: 新增 GCC 带宽估计与 pacer、RFC 8888 反馈、抖动缓冲,以及端到端 FlexFEC 恢复;拥塞控制仍为可选开启,避免默认引入排队延迟。
WebRTC 底层传输对象正式暴露给开发者:
SctpTransport、DtlsTransport和IceTransport已进入两个 crate,可读取当前 ICE candidate pair 等底层连接状态,API 设计基本对齐 W3C WebRTC。0.20 → 0.21 仍包含最后一批破坏性改动: 包括
SettingEngineBuilder、新的 Crypto Provider、Interceptor 链结构调整、RTCDataChannelId类型变化,以及部分 enum 改为#[non_exhaustive];这些也是项目选择先发 0.21 而不是直接进 1.0 的原因。
https://webrtc.rs/blog/2026/09/19/announcing-webrtc-v0.21.0.html
02 有亮点的产品
1、TypeSafe AI 决策模型 Jev 实时语音案例:实时判断用户是在和 AI 说话,还是在和身边的人交流
开发者 Ashutosh Purohit 基于 Jev 做了一个名为 Toothless 的常驻语音 AI Demo:它持续监听环境中的语音,但不会把听到的每句话都当成对 AI 的指令,而是让 Jev 实时判断当前这句话究竟是说给 AI,还是说给旁边的人。Jev 本身不生成回复,而是作为低成本决策层,根据当前对话上下文和多个判断条件给出结构化决策。TypeSafe AI 将 Jev 定位为一种不生成自由文本、而是返回带概率的类型化决策模型。
常驻语音 AI 不再依赖每次唤醒: Toothless 的目标是让 AI 始终在线,同时判断一段话是否真的在呼叫 AI,减少 Siri、Alexa 这类依赖唤醒词的交互。
判断重点从「有没有人在说话」变成「这句话是不是对我说的」: Demo 会结合当前话题是否延续、请求是否需要联网、是否属于 AI 可以帮助完成的事情等多个因素,让 Jev 判断当前语音的指向对象。
Jev 被放在实时语音链路的决策层: 它不负责生成回答,而是返回结构化判断,再由系统决定 AI 是否应该介入。这和此前用 Jev 判断浏览器操作、提前触发工具调用的案例属于同一种用法:把模型用于实时分流和动作决策。
https://x.com/ashutoshpuro97/status/2101660362882085299
2、印度语音 AI 公司 Navana.ai 获 ₹4 千万(约 420 万美元)A 轮融资:自研语音模型覆盖 12 种印度语言,已处理超 1 亿分钟企业语音
Navana.ai 宣布完成 ₹4 千万 A 轮融资,由 Ronnie Screwvala 领投,Antler India、Sharad Sanghi、Sandeep Singhal、Paula Mariwala 等参投。相比融资金额本身,更值得关注的是它把资源继续押在 面向印度企业的自研语音栈:官方称其 Bodhi 语音模型覆盖 12 种印度语言和 40+ 种方言,并已在真实企业环境中处理超过 1 亿分钟 Voice AI。
核心不是通用 Voice Agent,而是印度本地语言与真实通话环境: Bodhi 面向噪声、重叠语音、代码切换和地区口音等场景训练,Navana.ai 将其用于银行、金融服务和保险等企业语音应用。
企业部署强调受监管场景: 第三方融资报道显示,Navana.ai 提供本地部署选项,面向对数据隐私和合规要求更高的 BFSI 客户;公司官网则将产品定位为端到端企业 Voice AI 栈。
融资信息已经可以核验: Navana.ai 官方 LinkedIn 已确认获得 ₹4 千万融资,投资方名单与多家融资数据库一致;但「45 种方言」的口径在官网目前写作 40+ dialects,因此正文更适合按官方最新口径写。
https://navana.ai/
3、AI 助听器公司 Fortell 获 1.63 亿美元融资:自研 AI 芯片实时分离语音与噪声,而不是把环境声一起放大
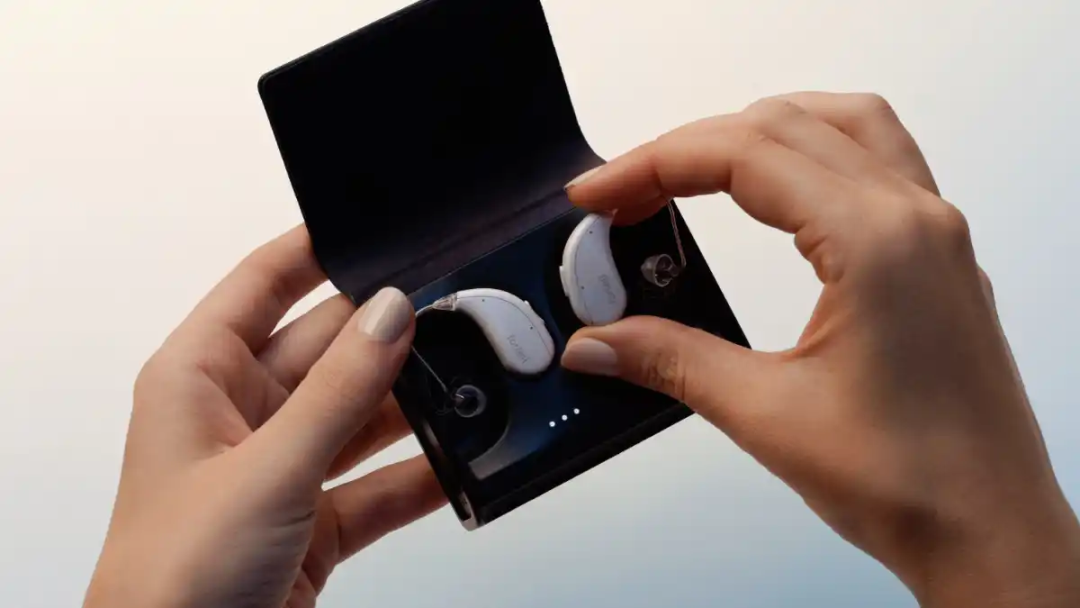
Fortell 是一家做 AI 助听器的创业公司,近期获得 1.63 亿美元融资,投资方包括 Founders Fund、Thrive Capital,以及 Valor Equity Partners CEO Antonio Gracias。它的核心思路不是传统助听器式地把所有声音一起放大,而是在设备端实时判断哪些声音更重要,把目标语音增强、其余声音压低。
把「鸡尾酒会问题」作为核心 AI 任务: Fortell 用神经网络区分用户想听的语音和背景噪声,再选择性增强目标声音。公司称,这套方案针对的是传统助听器在餐厅、聚会等多人噪声环境中难以分离重叠语音的问题。
为实时 AI 推理自研专用芯片: Fortell 没有沿用传统 DSP 架构,而是重新设计处理器,让更大的神经网络能直接在助听器里运行,同时控制延迟和功耗。
最新 AI 2.0 是上市后的最大模型更新: Fortell 在 2026 年 8 月发布 AI 2.0,称这是产品推出以来最大的一次 AI 模型升级,继续提升噪声环境中的语音分离能力。
独立测试给出了新的性能数据: 9 月 15 日,Fortell 宣布其助听器在 HearAdvisor 测试中获得 6.0 的综合 SoundScore 和 6.4 的噪声语音得分;该实验室此前最高记录为 4.5。
(@Techcrunch)
4、AI 教育公司 Aristotle 获 500 万美元种子轮:语音优先 AI 辅导结束内测,面向全美学生开放
Aristotle 宣布完成 500 万美元种子轮融资,由 True Ventures 领投,Wicklow Capital 及来自 Anthropic、OpenAI、Sierra、Ramp、Cognition 等公司的个人投资者参投。更值得关注的是产品从封闭测试进入全国开放:在此之前,超过 1000 名学生已经完成 1500 多小时一对一 AI 辅导。
产品从聊天框转向持续语音辅导: Aristotle 把交互设计成类似和真人老师进行 Zoom 通话,系统会记住过去的辅导内容,并根据学生的学习方式决定什么时候追问、什么时候等待,而不是直接给答案。
目标用户是 13–18 岁学生: 目前覆盖 STEM、标准化考试、语言学习等场景,产品定位不是一次性问答,而是高频、持续的一对一 AI 辅导。
此次变化重点是从内测进入规模化使用: Aristotle 在完成 1500+ 小时封闭测试后正式向全美开放,融资将用于继续扩展产品和团队。
https://www.heyaristotle.com/
(@Aristotle)
03 有态度的观点
1、黄仁勋:AI 在 2030 年毁灭世界的概率为 0%
英伟达创始人兼 CEO 黄仁勋在接受 CBS News 采访时表示,他完全不认同 AI 会在 2030 年毁灭世界的说法,并把这种情况的概率定为「0%」。
这是 CBS 已公开的专访片段中最明确的结论。面对「AI 研发是否应该减速」的问题,黄仁勋回答:「无论别人如何,我们都应该尽可能快地前进。」
他说,他的底线是不能在产品尚未准备好或不安全时发布。这个判断回应了 AI 行业近期的减速争论。
Anthropic CEO Dario Amodei 警告,AI 能力以「指数级」速度发展,行业应协调放慢前沿模型的开发节奏;黄仁勋则明确反对这一主张。
黄仁勋给出的边界集中在产品发布环节:继续加快研发,但不把尚未准备好的产品推向市场,也不交付不安全的产品。CBS 将于 9 月 20 日播出完整专访,目前公开的文字稿与视频片段尚未展开更多执行方案。
(@APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考