Nuance Labs 发布全双工视听模型 Nuplex 与 AI 角色 Emma丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、Nuance Labs 发布全双工视听模型 Nuplex 与 AI 角色 Emma:边听边生成表情,开放实时交互 Beta API
11 月 9 日,实时 AI 交互公司 Nuance Labs 发布基于全双工视听基础模型 Nuplex 1.0 构建的 AI 角色 Emma,并开放 Nuplex Beta API。经过 18 个月研发,Emma 能够在用户讲话时持续聆听,通过眼神、表情及细微动作作出非语言回应,并根据对话节奏决定何时开口,尝试实现更接近面对面交流的实时互动体验。
全双工视听交互结合非语言反馈: Nuplex 支持持续感知语音与视频,在聆听过程中驱动角色的眼神、眨眼、表情和头部动作。Emma 的形象与声音来自获得授权的真人演员,并经过角色化设计,以保持互动表现的一致性。
对话时机接近真人交流节奏: 团队基于 1785 个真实对话问题进行自建测试,Nuplex 的回应时机有 89% 落在原始真人回答的时间区间内,其他参测系统最高为 35%。该结果来自团队测试,尚非通用行业基准。
开放在线体验与 Nuplex Beta API: 开发者可通过 Prompt 定义角色、接入外部工具,并让角色在后台执行较长任务时继续交谈。目前仅支持英语,API 不提供自行上传人脸或声音进行克隆的功能,且服务存在地区和使用场景限制。
https://home.nuancelabs.ai/research/meet-emma-the-first-nuplex-persona
https://platform.nuancelabs.ai
2、AI 初创公司 Underdog 发布 32MB 本地语音合成模型 Woof:支持浏览器离线运行,单核 CPU 推理最高快于实时 18 倍
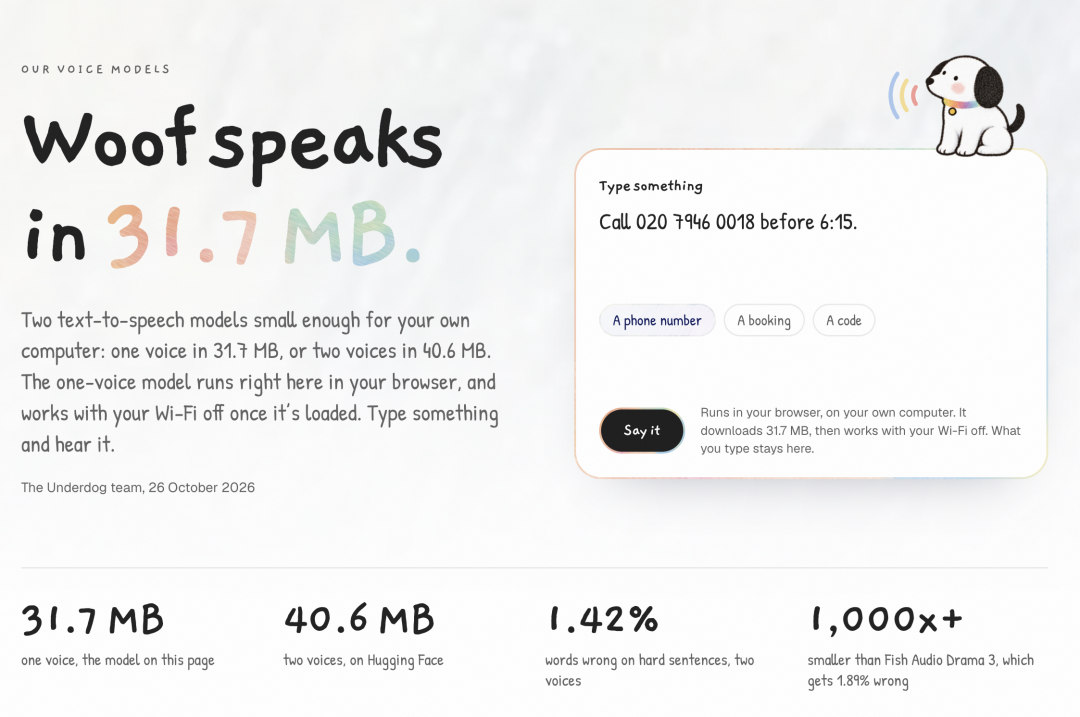
11 月 5 日,AI 初创公司 Underdog 发布轻量级英语 TTS 模型 Woof,单音色版本仅 31.7MB,可在浏览器中本地运行,无需依赖云端语音生成 API。团队同时推出交互式游戏 Underdog Escape 展示模型效果,并开放包含两种音色的 40.6MB 版本,支持开发者通过 CPU 运行语音合成。
提供 31.7MB 与 40.6MB 两个版本: 单音色模型可在浏览器中运行;双音色版本包含 Juno、Mira 两种声音,总参数量约 3824 万,能够通过 NumPy 在 CPU 上生成 24kHz 语音。
单核 CPU 推理最高达实时 18 倍: 团队在 Apple M5 Max 单个 CPU 核心上的测试显示,31.7MB 版本生成速度约为实时的 18 倍;40.6MB 版本的 Juno 音色达到 13.8 倍,峰值内存占用约 402MB。
针对数字与复杂文本优化发音: 内置规则式文本规范化功能,可处理日期、电话号码、金额和代码。团队在 500 条英语困难文本测试中测得,双音色版本最低词错误率为 1.42%,单音色版本为 2.06%。模型权重已公开,非商业用途免费,商业使用需另行授权。
https://underdog.ai/woof
3、生数科技等团队提出实时视频音效生成模型 LiveFoley:156ms 端到端延迟,支持游戏与 AR/VR 画面同步配音
莫纳什大学、南京大学、生数科技、阿里巴巴及清华大学等机构研究人员提出实时视频生成音频模型 LiveFoley,面向游戏、AR/VR 和交互式虚拟世界中的动态音效合成。模型可直接根据持续输入的视频画面生成同步声音,无需依赖特定视频生成模型。在单张 NVIDIA A800 GPU 上,LiveFoley 实现了 156ms 端到端延迟,并保持接近离线模型的声画时间对齐精度。
156ms 延迟实现实时视频配音: LiveFoley 采用流式自回归扩散架构,根据不断更新的视频帧连续生成音频。单张 A800 GPU 测试中,端到端延迟为 156ms,适用于需要声音随画面动作变化的实时交互场景。
滑动窗口兼顾低延迟与声画同步: 提出 Trailing Sliding Window,将非因果视频编码器转换为流式处理模块,无需重新训练。仅需 80ms 前瞻时间,DeSync 时间对齐指标达到 0.48,接近离线模型的 0.47。
动态调整计算预算与音频生成质量: Unified Varhop Framework 支持根据场景调整处理步长,视频前端计算量最多降低 4 倍。音频端通过 History LocDiT 利用历史片段改善生成质量,并提供 Future-Warmup LocDiT 进一步增强音频连续性。目前论文与项目演示已公开,GitHub 仓库尚未发布完整代码。
https://dalision.github.io/livefoley-page/
4、网易有道开源流式语音识别模型 Confucius4-R2T2:160ms 分块识别,已输出文字无需回改
网易有道研究团队发布并开源实时流式 ASR 模型 Confucius4-R2T2 以及技术报告,针对实时字幕、同声传译和 Voice Agent 中识别结果反复修改的问题,提出稳定前缀(Stable Prefix)输出机制。模型基于 Qwen3-ASR-1.7B,通过约 1500 小时中英语音数据后训练,使识别文本能够持续增量输出,已确认的文字不会被后续音频改写,同时尽量保持离线识别的准确率。
稳定前缀机制避免识别结果反复修改: 提出 Longest Stable Prefix(LSP)训练方法,让模型判断哪些文字可以永久确认、哪些内容需要等待更多音频。通过 SFT 与 GRPO 两阶段训练,只更新语言解码器,冻结音频编码器与投影层,无需修改原模型架构。
160ms 分块下识别错误率降至 5.76%: 团队在 13 个中英文测试集上的评测显示,R2T2 在 160ms 分块、保留一个内部候选 Token 的设置下,平均识别错误率为 5.76%,相比基础模型相同设置的 21.01% 明显降低,接近基础模型完整音频识别的 5.15%。
开放模型权重与实时接入接口: 支持 80ms–2s 可配置分块、热词与上下文提示,并提供 vLLM、llama.cpp 推理方案及多客户端 WebSocket 服务。模型已在 Hugging Face、ModelScope 开放下载,同时提供在线演示,便于开发者集成到实时字幕和 Voice Agent 流程中。
https://arxiv.org/abs/2611.06043
https://github.com/netease-youdao/Confucius4-R2T2
https://r2t2.youdao.com/demo
02 有亮点的产品
1、AI 互动娱乐公司飞拓星驰获数千万美元融资:布局端侧 AI 体感游戏,首款硬件计划面向北美市场 CES 2027 亮相
据 Z Potentials 11 月 10 日报道,AI 互动娱乐公司飞拓星驰完成数千万美元天使轮融资,由元生资本、江远投资领投,日初资本、锋领资本等老股东跟投。公司围绕 AI 游戏引擎、端侧模型和家庭娱乐硬件展开布局,计划打造无需传统手柄、能够感知玩家动作并支持多人互动的家庭 AI 游戏系统,首款硬件预计于 2027 年 CES 首次公开亮相。
端侧模型支持无手柄体感交互: 团队将人体姿态估计和空间感知技术应用于游戏场景。据公司披露,系统无需手柄或 VR 设备,可将人体三维动作以超过 120fps 的速度映射到游戏中,姿态估计误差低于 3cm。
AI 游戏引擎加速内容创作: 公司通过 AI 辅助游戏原型、资产、场景与交互逻辑制作,并结合玩家实际试玩反馈优化玩法。硬件、模型和内容共同开发,以提升实时反馈与多人互动体验。
首款 AI 游戏机计划面向北美市场: 产品定位家庭体感互动娱乐,规划支持单人游玩、同屏多人互动及跨家庭线上联机,预计在 CES 2027 首次展示。目前尚未公布具体硬件配置、售价及上市时间。
( @Z Potentials)
2、fal 上线 Decart 实时视频模型 Lucy 2.6:支持 WebRTC 视频流实时编辑,API 定价每秒 0.02 美元
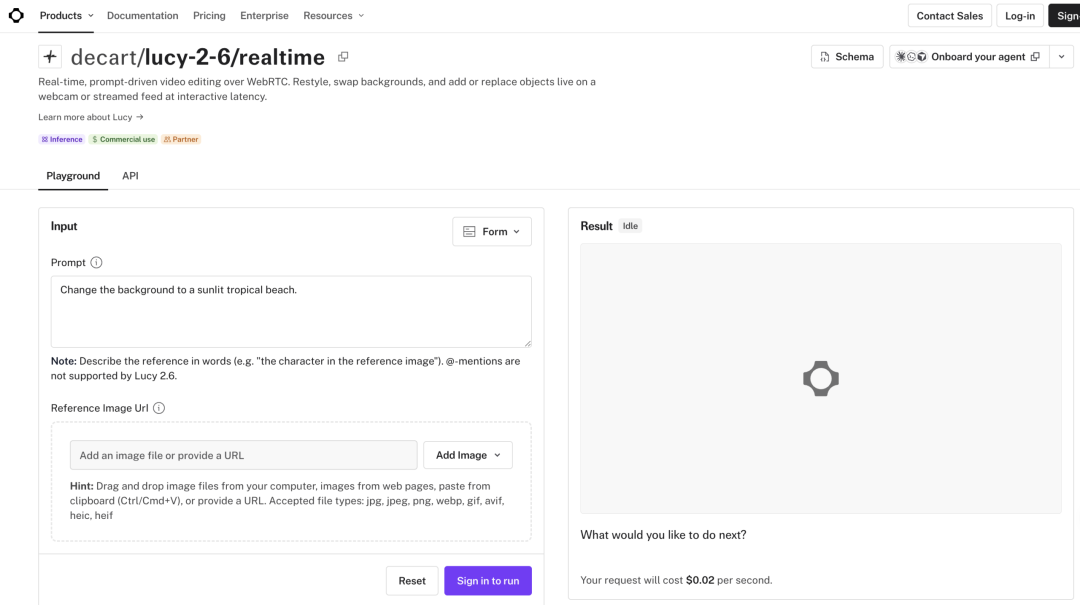
实时视频生成公司 Decart 发布 Lucy 2.6,并通过 AI 推理平台 fal 提供实时 Video-to-Video API。开发者可将摄像头或直播视频流接入模型,通过文字指令实时修改人物外观、服装、背景及画面物体,无需预先生成完整视频。新版本重点提升参考图像还原能力与动态画面一致性,面向直播带货、虚拟角色和实时互动应用。
WebRTC 支持实时视频到视频编辑: 可在持续输入的视频流中通过 Prompt 切换画面风格、替换背景、添加或移除物体,也可结合参考图片进行角色替换和虚拟试穿,适用于摄像头直播及互动视频场景。
提升角色、服装与商品细节一致性: 相比 Lucy 2.5,新版本重点改善参考人物的面部与身材还原、服装形状及材质保持,以及商品和配饰在连续画面中的细节表现,同时优化角色动作、口型与光照效果。
开放 API,按视频处理时长计费: fal 已提供在线 Playground 和 JavaScript SDK 接入,实时视频传输采用 WebRTC,媒体流在浏览器与 Decart 之间传输。当前标价为每秒 0.02 美元,支持商业使用。
https://fal.ai/models/decart/lucy-2-6/realtime
3、AI 交互智能公司 SYNAPUFF 完成数百万元种子轮融资:研发机器人交互基座,让 AI 判断何时行动、如何回应
面向 AI Native 终端的交互智能公司 SYNAPUFF(共栖未来)近期完成数百万元种子轮融资,投资方为 FIRST RULE VENTURES 和浦东创投。公司联合创始人兼 CEO 李诗淼表示,团队希望构建面向 AI 终端和机器人的交互智能基座,使智能体能够持续理解人与环境的变化,自主判断何时行动、采用何种反馈方式,并根据用户反应动态调整行为。
聚焦实时交互决策能力: SYNAPUFF 希望解决 AI 终端从理解指令到自然互动之间的问题,让智能体不仅执行任务,还能根据用户状态、交互时机和环境反馈,判断何时主动回应、何时保持等待,以及如何调整动作。
研发多模态交互与非语言行为模型: 团队提出人机共栖交互框架,围绕 Robot 原生 Non-Verbal Behavior 动作生成模型、AMI 非对称多模态交互模型及数据管线展开研发,探索将语言、视觉与动作反馈结合,支持机器人在真实场景中的连续交互。
面向 AI Native 终端与机器人应用: SYNAPUFF 的技术定位是为不同智能终端提供可复用的交互能力,重点关注长期陪伴和人机协作场景。目前尚未披露公开模型权重、API 接入方式或具体性能指标。
(@硬氪)
03 有态度的观点
1、瑞银 CEO:AI 股回调前,市场一直按「完美情景」定价
据路透社报道,瑞银首席执行官塞尔吉奥·埃尔莫蒂 11 月 9 日在悉尼出席瑞银会议时表示,过去数周 AI 股票的明显回调,反映出投资者此前对行业的预期过高。
他仍看好 AI 带来的经济收益,但认为市场高估了这些收益兑现的速度。直到不久前,市场一直按完美情景定价。当然,过去几周我们看到了一些回调。
埃尔莫蒂提到,美国中期选举结果,以及全球围绕 AI 基础设施建设影响的争论,都可能拖慢行业取得成果的进度。他也以瑞银为例说明企业落地的速度。
瑞银在 2023 年同意收购瑞信,埃尔莫蒂表示,随后的整合工作拖慢了瑞银内部部分 AI 应用的落地。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考