Google DeepMind 发布世界模型 Genie 4:实时生成可交互世界丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、Liquid AI 开源 LFM3 系列:六款 2B 级模型覆盖文本、语音、视觉与决策,支持单 GPU 微调和端侧部署
Liquid AI 发布新一代基础模型系列 LFM3,一次推出 6 款开放权重模型,覆盖文本、视觉、语音、全模态理解和决策任务。所有模型均基于全新的三混合架构(Tri-Hybrid) 构建,针对手机、PC 和边缘设备优化。官方称,LFM3-1.7B 在参数减少 35% 的情况下超越上一代 2.6B 模型;视觉模型仅约 1.9B 参数,在多项评测中达到 Gemma 4 12B 级别的表现。
三混合架构提升端侧效率: 将门控短卷积、滑动窗口注意力和全局注意力结合,基于 22T Token 预训练。文本模型支持 256K 上下文,4-bit 量化后约占 1GB 内存,适合本地 Agent、工具调用及长上下文任务。
语音、视觉与全模态统一:LFM3-VL-2B 支持图像、视频理解;LFM3-Audio-2B 支持 18 种语言的语音对话、识别、合成和工具调用,官方报告首 Token 延迟最低 50ms。LFM3-Omni-2B 则将视觉、音频和语言整合到单个模型,支持边看、边听、边生成语音回复。
新增决策模型,支持单 GPU 微调:d1-2B 和 d1-Omni-2B 可一次输出结构化决策及对应置信概率,用于目标定位、信息提取和数值判断。全系列已在 Hugging Face 开放权重,采用 LFM Open License v1.0,支持 Transformers、llama.cpp、MLX 和 vLLM 等推理框架。
https://www.liquid.ai/blog/lfm3
https://huggingface.co/blog/LiquidAI/lfm3
2、Google DeepMind 发布 Genie 4 世界模型:实时生成可交互世界,原生音频与 Gemini 推理支持多步骤事件模拟,可通过自然语言改变天气、增加人物或物体
Google DeepMind 于 10 月 27 日发布新一代世界模型 Genie 4,支持实时生成和操控高拟真虚拟环境。用户可以在场景运行过程中随时改变环境、镜头和角色行为,模型会持续生成后续画面及匹配的音效。相比此前版本,Genie 4 首次加入原生实时音频生成与角色对话,并结合 Gemini 的推理能力,让虚拟世界能够执行更连贯的多步骤事件。
实时修改场景,模拟物理交互: 用户可以通过自然语言改变天气、增加人物或物体,也能通过键盘操控角色和镜头。模型可模拟空气动力学、碰撞及人物运动,让场景根据用户操作持续变化。
原生生成环境音效与角色语音: Genie 4 在生成画面的同时,同步生成风声、水声、音乐等环境声音。虚拟角色能够根据用户输入和场景事件实时对话、移动和作出反应,无需额外接入独立的音频生成模型。
Gemini 负责规划复杂事件: 系统利用 Gemini Omni 增强场景生成,并由 Gemini 3.8 Flash 持续观察画面、拆解任务、检查执行进度和动态调整后续事件。目前 Genie 4 已向受邀测试者开放研究预览,后续将通过 Project Genie 向 Google AI Ultra 用户开放,并向 Gemini API、Google AI Studio 的早期合作伙伴提供接入。
https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
3、Fish Audio 发布 Realtime STT(预览版):不仅识别语音,还能判断对话轮次,Cekura 转写错误率仅 2.21%
Fish Audio 推出 Realtime STT(预览版),面向实时语音 Agent,将语音转写与对话轮次判断结合,让系统能够区分用户真正想要打断、只是回应一句「嗯」,还是尚未说完。Fish Audio 宣称,新模型在 Cekura 20 款 STT 模型评测中排名第一,整体词错误率(WER)为 2.21%。
理解对话轮次,减少误打断: 模型不仅输出文字,还能判断用户何时说完、是否正在接管对话,并区分「嗯」「对」等简单附和与真正的打断请求。背景噪声、电视声或旁人对话也可被标记为非用户发言。
支持提前结束检测,缩短响应等待: 官方测试中,首段转写文本约在语音开始后 500ms 返回;用户停止说话后约 600ms 发出提前结束信号,最终转写约 1.1 秒返回。语音 Agent 可利用提前结束信号启动 LLM 推理。
已开放 WebSocket API: 开发者可通过
transcribe-stream-1接入,支持 29 种语言的转写标签、对话历史和自定义词汇。服务价格为每会话小时 0.36 美元,按连接时长计费,单次会话最长 60 分钟。
https://docs.fish.audio/features/speech-to-text/realtime
4、印度语音 AI 团队 Maya Research 开源 Maya-2:2.5B 参数支持 11 种印度语言,20 种音色与跨语言声音克隆
印度语音 AI 团队 Maya Research 正式开放 Maya 2 Native 模型权重及推理代码,采用 Apache 2.0 许可证。模型拥有 2.5B 参数,支持 11 种印度语言及英语的流式语音合成,内置 20 种音色,并能通过短音频克隆说话人声音。在 VoiceArena 印地语实时 TTS 榜单中,Maya-2 排名第二,领先于 Cartesia Sonic 3.5 和 Sarvam Bulbul v3。
覆盖 12 种语言,支持跨语言音色克隆: 包括印地语、泰米尔语、泰卢固语、孟加拉语等 11 种印度语言及英语。模型预置 20 种合成音色,也可使用 3–10 秒参考音频克隆声音,例如用印地语录音生成泰米尔语语音。
H100 单路首音约 14ms: 模型基于 Qwen3-1.7B 构建,使用 Mimi 音频编解码器,以 80ms 音频帧流式生成 24kHz 语音。官方测试中,单路 H100 推理首音约 14ms;一张 H100 NVL 同时处理 224 路语音时,首音延迟中位数为 111ms。
开放权重与完整推理服务: 提供 Python SDK、兼容 OpenAI 的
/v1/audio/speech接口和 WebSocket 流式服务,支持连续批处理与 CUDA Graph 加速。BF16 权重约 5GB,单路部署时模型加载峰值显存约 9.2GB,目前主要面向 NVIDIA GPU 本地部署。
https://github.com/MayaResearch/maya2-native
02 有亮点的产品
1、印度语音 AI Karta AI 完成 300 万美元种子轮融资:语音 Agent 每月处理 200 万次对话,覆盖 25 种以上语言
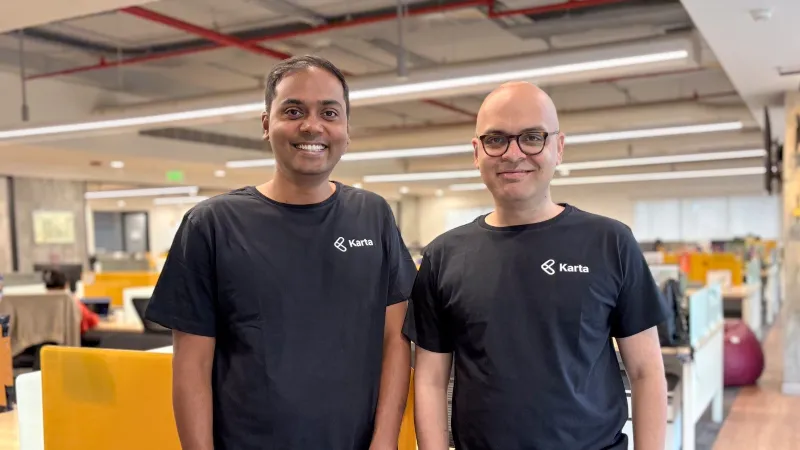
印度班加罗尔语音 AI 公司 Karta AI 完成 300 万美元种子轮融资,由 PeerCapital 和 Cedar Hill Capital 联合领投,Wyser VC、CDM Capital 和 Seedstars 参投。公司专注为银行、贷款机构、金融科技及保险企业提供智能语音客服,能够处理涉及多个业务系统的复杂来电。目前平台每月处理约 200 万次客户对话,覆盖 25 种以上语言。
专攻复杂来电与多意图理解: AI Agent 不仅回答常见问题,还能在一次通话中识别多个客户诉求,调用企业内部系统执行贷款查询、支付处理、账单获取等操作,并在必要时转交人工客服。
约 70% 贷款客户问题实现自动解决: 据公司披露,在一家住房贷款机构的实际部署中,AI Agent 可独立解决约 70% 的借款人咨询,将单次客服处理成本降低约 50%。公司客户包括 PhonePe、Pine Labs 和 Aavas 等金融机构。
持续优化业务上下文与自动化能力: Karta AI 通过自研的预测式上下文引擎,结合历史对话、企业知识库和业务流程改善任务处理。新融资将用于增强多语言能力、扩大金融机构部署规模,并扩充工程及商业团队。
( @Entrepreneaur)
2、智元机器人开源 AGIBOT WORLD 2026 第四期:九类具身推理任务,让机器人根据环境变化自主决策
智元机器人于 10 月 22 日正式开源 AGIBOT WORLD 2026 第四期「具身推理」(Physical Reasoning)数据集。此次发布将训练重点从机械操作转向任务理解、推理决策与动作执行,让机器人能够根据物品数量、位置和任务进度等实际条件,决定下一步该做什么。数据来自智元 G2 机器人在真实场景中的操作过程。
九类推理任务,覆盖不同环境状态: 包括物品属性选择、条件判断、前置条件推理、目标搜索、长程规划和状态记忆等能力,并设置简单、中等、困难三级难度。例如执行「补货到 3 瓶」时,机器人需要先清点数量、区分空瓶与满瓶,再决定回收或补充哪些物品,而不是重复固定动作。
同时提供推理标注与真机动作轨迹: 数据集包含任务目标、子任务划分、动作步骤、双臂分工、物体空间位置及成功、错误样本,将高层任务决策与底层机器人控制数据关联,可用于训练任务规划、过程记忆和决策执行模型。
已用于智元下一代模型训练: 数据集已应用于智元新一代具身基座模型和 Agent 框架的训练,并在 Hugging Face 开放下载,兼容 LeRobot 数据格式。数据采用 CC BY-NC-SA 4.0 许可证,允许符合条款的非商业研究使用。
https://agibot-world.com
3、Google Meet 实时语音翻译扩至 63 种语言:自动识别语种,每位参会者可独立控制翻译
Google 宣布升级 Google Meet 实时语音翻译,基于 Gemini 3.5 Live Translate,将支持范围扩大至 63 种语言。同一场会议中,不同语言的参与者可以直接交流,系统会自动识别说话语言,并将语音实时翻译成每位听众选择的语言,无需提前设置全会议统一的翻译语言对。
自动识别语言,支持会议中途切换: 即使参会者在讲话过程中切换语言,系统也能自动检测并继续翻译。翻译语音还会配合同步字幕,让用户同时听到和看到译文。
翻译开关交给每位参会者: 用户可以自行开启或关闭翻译、设置偏好的接收语言,还能指定自己已经理解的语言,避免不必要的翻译。系统会尽量保留原说话人的声音特征。
覆盖网页、移动端及会议室设备: 支持 Google Meet 网页版、Android 和 iOS。符合条件的 Workspace 和 Google AI 订阅用户可使用,基础套餐每场最多翻译 90 分钟,高级套餐最长 8 小时。功能自 10 月 22 日开始分批推送。
( @Google)
4、Soul 推出 Loxinity AI 音视频平台:自研语音合成与实时数字人模型,支持音色克隆和 API 接入
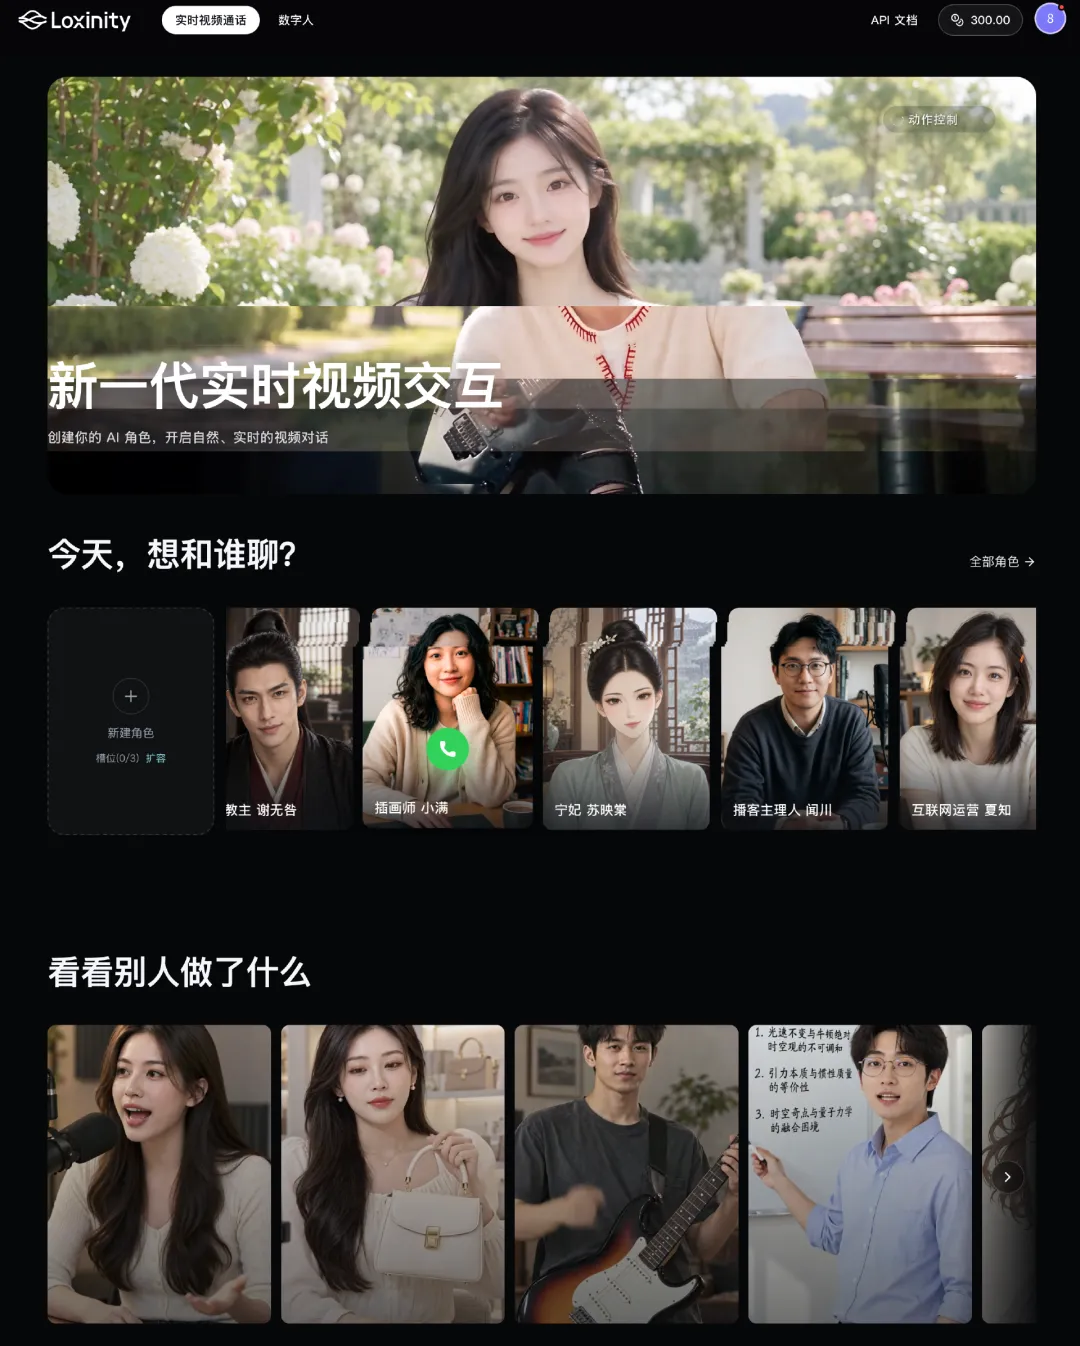
社交平台 Soul 推出 AI 音视频交互产品 Loxinity(洛希无限),整合自研语音合成模型 Loxi Speech 和视频生成模型 Loxi Avatar,面向 AI 陪伴、语音客服、数字人直播等实时交互场景。平台重点优化真人对话中的语气、停顿和情绪变化,并提供语音生成、数字人创作及实时视频互动能力。
Loxi Speech 强调自然对话与情绪表达: 支持单人配音、多人对话、音色克隆和音色设计。开发者可以添加情绪、副语言和拼音标记,控制语气与发音,让合成语音呈现更自然的停顿和情绪起伏。
Loxi Avatar 支持实时数字人交互: 用户可以上传图片创建数字人,或选用真人、二次元、奇幻等预设角色。模型支持根据文本或音频生成视频,并协调语音、口型、表情与动作,用于实时视频通话及虚拟角色互动。
已开放体验与 API 接入: Loxinity 官网显示,平台于 10 月 15 日正式上线,面向个人用户、开发者及企业开放,提供创作工具、API 和企业级部署服务。产品采用积分及订阅套餐计费。
https://www.loxinity.com/
03 有态度的观点
1、邓煜:AI 公司应公开证明思路,让用户决定数据是否用于训练
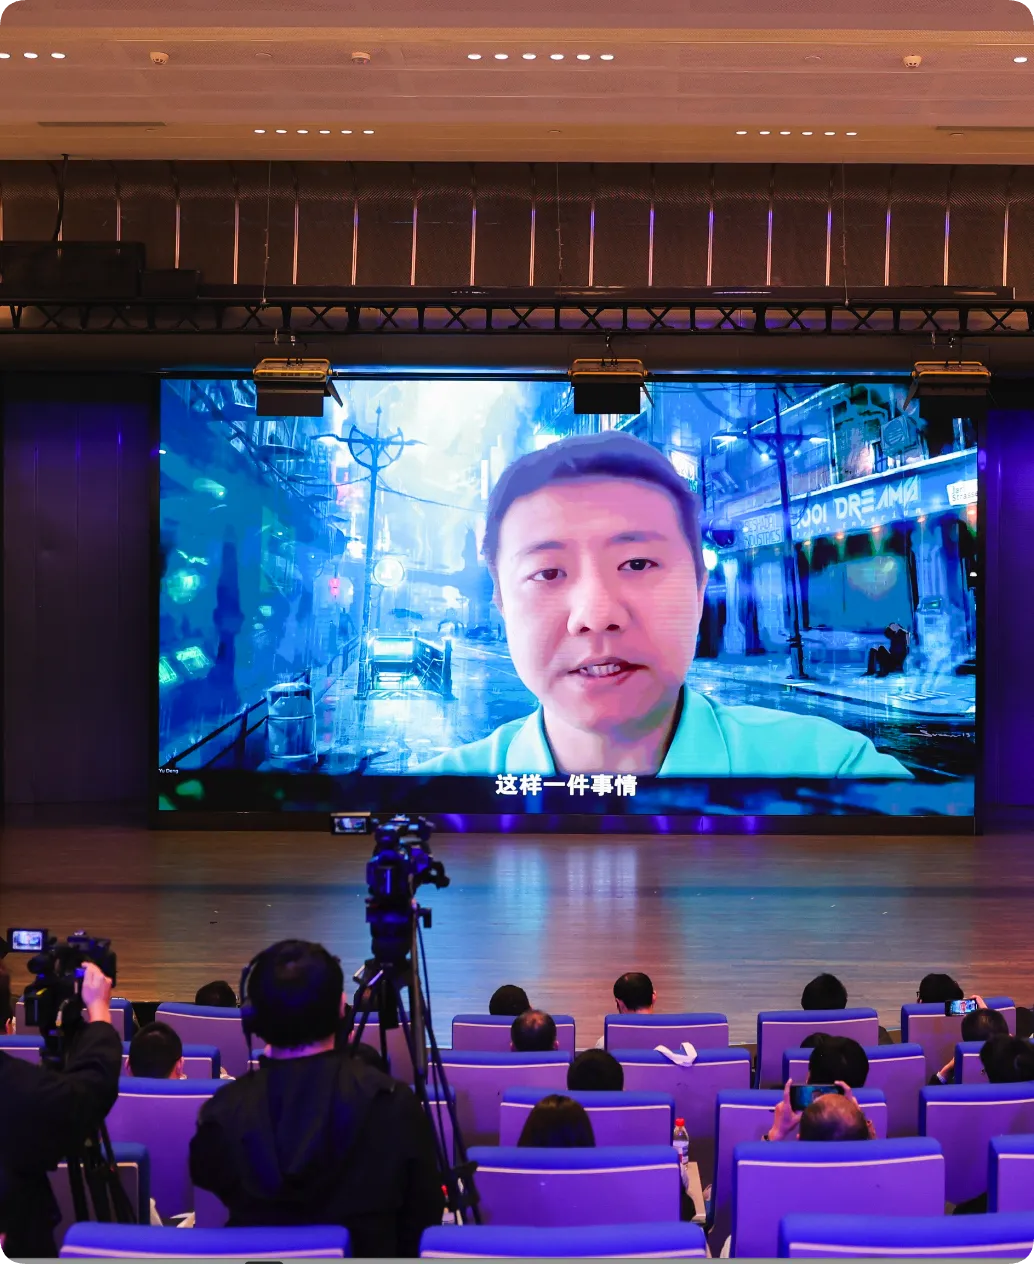
数学家邓煜在 10 月 25 日由《知识分子》《赛先生》联合举办的论坛演讲中谈到,AI 对数学研究有很大促进作用,但提供模型的公司同样需要面对学术规范、思想来源和用户权益问题。他认为,如果把 AI 当作发表研究成果的研究者,就应解释重大证明是如何得到的,说明其中沿用了哪些人的思路。
数学家报告成果时需要回答这些问题,AI 公司也应公开相应思维链,不能仅以防止蒸馏为由拒绝。从商业关系看,邓煜质疑:数学家付费使用工具、输入研究思路后,模型提供方再利用这些思路训练产品并发布成果,用户的贡献应如何得到承认?
他主张,是否允许输入数据参与训练,应由用户自行选择。他同时强调,数学家不应拒绝使用 AI,而应把它作为推进研究的工具,由人提出问题、把握方向。他提出的方案包括建立思路和贡献的追溯机制,让成果能够说明某个想法最初由谁提出。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考