Tolan 融资 3000 万美元,从 AI 情感陪伴拓展到日常生活智能体丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、蚂蚁百灵开源 Ming-3.0 语音系列:五款模型覆盖语音合成、音频理解与识别,支持自然语言设计音色和导演式情绪控制
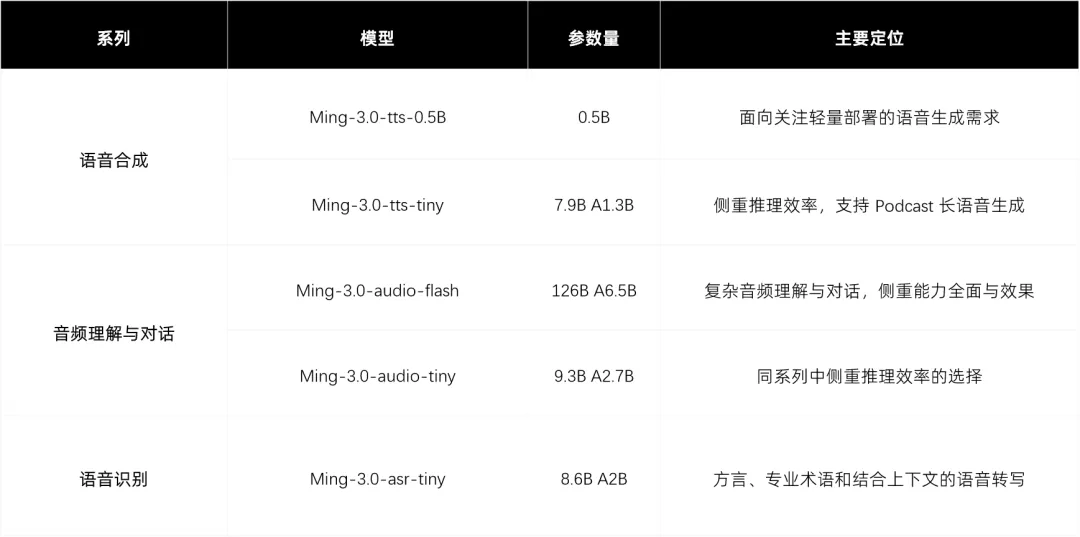
蚂蚁集团百灵大模型团队于 10 月 20 日开源 Ming-3.0 语音系列,共推出五款模型,分别面向声音创作、长音频理解与分析、业务场景语音转写。开发者可以根据任务单独选用,也可以将语音识别、音频理解和语音合成组合起来,构建从语音输入、内容分析到语音回复的完整工作流。五款模型的权重均已发布在 Hugging Face,相关模型卡采用 MIT 许可证。
语音合成:用文字设计音色,像导演一样控制表演。 Ming-3.0-tts-0.5B 和 Ming-3.0-tts-tiny 均支持通过自然语言描述目标音色,也支持参考音频进行零样本音色克隆。创作者可以进一步指定情绪变化、重读词语、语速、音高和音量,并通过行内标签控制笑声、叹息、咳嗽等非语言声音。两款模型支持中文、英语等七种语言,以及川渝话、粤语等方言合成。
音频理解:直接分析长录音,不必先转成逐字稿。 Ming-3.0-audio-flash 和 Ming-3.0-audio-tiny 是原生音频语言模型,能够处理语音识别、口语问答、长音频理解与推理,还可以感知非语音声音、声学场景和音乐。模型支持结合文本指令分析音频,并输出文字或可选的语音回复,适用于会议内容分析、录音总结、声音场景理解等任务。
语音识别:利用上下文和热词提升专业场景识别效果。 Ming-3.0-asr-tiny 支持中文、英语和多种方言识别,可在转写时引入领域热词及前序对话上下文,帮助模型识别专业术语、专有名词和容易混淆的词语。官方评测覆盖包括粤语、闽南语、上海话在内的 15 种区域方言测试集。
提供从模型到服务的开发路径。 五款模型均已在 Hugging Face 开放权重,相关项目提供推理代码和使用示例。其中,Ming-3.0-audio 系列支持通过 SGLang-Omni 暴露兼容 OpenAI 的音频转写、语音合成和聊天接口,方便开发者将不同语音能力接入现有应用与智能体工作流。
此次开源的重点是把语音技术拆分为可独立部署、按需组合的组件:TTS 负责可控表达,Audio 负责理解与推理,ASR 负责上下文感知的转写。需要注意,模型的开放权重不等于可以在普通设备上直接运行:例如,官方为 Ming-3.0-audio-flash 提供的参考部署配置需要多张 80GB 显存的 H800 GPU;开发者应根据模型规模与实际硬件选择部署方案。
在线体验入口:
https://chat.ant-ling.com
huggingface:
https://huggingface.co/collections/inclusionAI/ming-30
2、AI 视频创作平台 Viggle 发布世界模型 JST-2:约 1 秒生成可漫游 3D 场景,64 个视角支持持续扩展
AI 视频与角色动画平台 Viggle 正式发布新一代世界基础模型 JST-2(Joint Space-and-Time 2.0),采用原生三维空间建模架构,将场景、角色和动作生成整合至同一模型。不同于生成固定镜头的视频模型,JST-2 能够直接生成可从不同角度探索的 3D 场景,并随着用户移动视角不断扩展世界。官方表示,在 NVIDIA B200 GPU 上生成一个 3D 场景仅需约 1 秒,模型推理成本低于 0.01 美元。
通过物理原生 Token 建模三维世界: JST-2 使用 Physics-Native Tokens 表示三维空间中持续存在的物体及其组成部分,每个 Token 包含明确的 XYZ 空间坐标,以及描述物体属性和运动规律的可学习向量。模型通过编码器、生成器和解码器,将图片或文本输入转化为三维表示,再生成不同视角的画面或 3D 高斯泼溅场景。
1 秒生成可漫游场景,支持 64 个视角的空间上下文: JST-2 采用前馈式架构,无需针对每个新场景执行额外优化。生成的场景以 3D Gaussian Splatting(3D 高斯泼溅) 格式输出,可直接在浏览器本地渲染。用户能够自由调整视角,无需每次移动都重新调用模型;当探索到新区域时,模型可以根据最多 64 个输入视角的上下文继续生成和扩展场景。官方公布的约 1 秒生成时间仅计算 B200 上的模型推理,不包含网络传输延迟。
同一模型生成 3D 角色和全身动作: JST-2 可以从单张图片或文本生成 3D 角色,并通过内置的运动特征直接驱动角色动画,减少传统流程中的骨骼绑定和蒙皮步骤。同时支持从文字生成全身动作,或从视频重建人物运动。官方盲测中,其角色生成相对 Meshy 7.1 和 Tripo H3.1 的综合偏好得分分别为 58.4% 和 73.2%。
开放浏览器体验、API 与 MCP 接口: JST-2 已接入 Viggle 的 PINOC 创作平台,开发者可以在浏览器中生成和探索 3D 世界,也可以通过 API 获取
.spz场景文件,或通过 MCP 接入 Codex、Claude Code 等智能体工具。当前 API 中,从文字提示词创建场景收费 0.06 美元/次;基于已有全景图生成场景、生成新视角及重建任务为 0.01 美元/次,与官方公布的模型底层推理成本并不相同。
目前 JST-2 已开放在线体验和 API 接入,但其场景碰撞与物体交互仍依赖基于规则的物理系统,尚未实现完整的学习式物理模拟。Viggle 表示,下一代 JST-3 将重点研究通过学习得到的动力学模型预测物体间的交互。JST-2 的场景扩展文本引导和更高精度的高斯泼溅表示,也计划在后续版本推出。
https://viggle.ai/jst2
3、NVIDIA 开源机器人智能体框架 ASPIRE V1.0:自动排查动作失败并生成可复用技能,80 项机器人任务成功率达 99%
NVIDIA GEAR 实验室联合密歇根大学、UIUC、加州大学伯克利分校等机构,正式开源机器人智能体框架 ASPIRE V1.0。不同于依靠梯度更新模型参数的传统机器人训练方式,ASPIRE 让编程智能体直接编写机器人控制代码,在仿真或真实环境中执行、分析失败并修复程序,再将验证成功的操作方法沉淀为可复用的技能库。团队公布的最新结果显示,系统在 80 项 LIBERO-Pro 机器人操作任务中达到 99% 的成功率,并展示了真实机械臂操作魔方、拧瓶盖和叠放杯子等能力。
机器人执行失败后,AI 自动定位问题并修复代码: ASPIRE 采用闭环执行引擎,记录机器人每一步的视觉观测、物体检测、抓取位置、运动规划及执行反馈。当操作失败时,编程智能体可以检查相关日志和画面,定位失败原因,修改控制程序并重新运行,直到验证成功或达到尝试限制。系统还支持演化搜索,并行探索多种操作策略。
把修复经验保存为 Skills,让其他任务复用: ASPIRE 将经过验证的抓取、定位、移动和错误恢复方法整理为模块化技能文件,存入持续扩展的技能库。执行新任务时,智能体可以检索相关经验并将其用于生成控制程序,减少重复调试。技能不仅可以在不同任务间迁移,还能在仿真与真实机器人之间提供可复用的操作指导。
80 项 LIBERO-Pro 任务成功率达 99%,模型能力直接影响表现: 官方最新实验显示,ASPIRE 在 LIBERO-Pro 的目标、物体、空间及长程任务上达到 99% 成功率,并在部分 Robosuite 和 BEHAVIOR-1K 任务中取得高成功率。在固定机器人接口和评测条件下,仅更换底层推理模型,10 项 LIBERO-Pro 任务的成功率就可以从 15% 提升至 99%,说明编程智能体的推理和调试能力是系统表现的重要因素。
支持真实机器人持续改进,开放代码和复现流程: V1.0 展示了真实机械臂通过编程智能体完成魔方操作、瓶盖旋拧、药片放入瓶中及杯子堆叠等任务。项目已在 GitHub 开源闭环执行框架、技能文件、实验配置与评测代码,并提供面向 Claude Code、Codex 等编程智能体的复现指南。
ASPIRE 最初于 2026 年 6 月发布研究成果,此次更新重点是 V1.0 正式开源、扩展真实机器人技能发现能力及采用更强模型后的新评测结果。项目采用 Apache 2.0 许可证,但其真实机器人实验仍依赖安全监控、环境重置和设备校准,且生成的 Python 控制代码需要在隔离环境中运行。目前公布的高成功率主要来自指定仿真任务,尚不代表机器人在开放现实环境中具有相同的可靠性。
https://github.com/NVlabs/ASPIRE
4、实时对话 Avatar 平台 LemonSlice 上线 Cartoon Model:一张图生成卡通数字人,3D 吉祥物、动漫角色和会说话物品都能实时开口
实时对话 Avatar 平台 LemonSlice 上线 Cartoon Model,把其实时数字人能力从写实人物扩展到卡通角色。开发者现在可以用 一张参考图,直接生成可实时视频对话的 3D 吉祥物、动漫角色、动物角色或会说话的物品,并继续接入自己的 LLM、语音模型和知识库。该产品延续 LemonSlice 的实时交互架构,官方给出的整个平台延迟指标为 471ms p99。
一张图直接生成卡通实时数字人: 官方博客显示,Cartoon Model 面向卡通角色做了专门训练,重点优化夸张表情、头部和身体动作,以及非标准嘴型下的唇形同步。支持的对象不只是二维动漫人物,也包括 3D mascot、绘本风角色、动物、奇幻生物和「会说话的茶杯」这类非人形对象。
仍然是实时对话模型,不是离线视频模板: Cartoon Model 不是预录视频换脸工具,而是沿用 LemonSlice 的实时交互 Avatar 管线,在通话过程中逐帧生成视频。开发者可以在 Playground 中直接选择
Cartoon model,也可以在 API 会话里把model设为"cartoon",将其接到现有的语音 Agent 或聊天机器人上。底层能力来自 LemonSlice-2.1 与 CWM-1: 官网显示,LemonSlice 的核心包括 20B 的 LemonSlice-2.1,可从单张图片以 20fps 驱动角色;以及 Character World Model-1(CWM-1),用于控制动作、情绪、手势、肩部和姿态。这意味着 Cartoon Model 不只是让角色「嘴巴会动」,而是把卡通角色也纳入其实时动作与情绪控制体系。
已开放订阅与 API,但官网定价信息存在口径差异: LemonSlice 博客在 10 月 16 日的发布文中写明,Cartoon Model 「已向所有订阅计划开放」;但当前官网定价页则把 「Access to Cartoon model」 列在 Ultra(800 美元/月)及 Enterprise 档位下。可以确定的是,Cartoon Model 已正式上线并可通过平台使用,但具体可用套餐范围仍建议以最新后台权限和销售说明为准。
目前 LemonSlice 的产品定位仍是「给实时语音 Agent 加上一张脸」。Cartoon Model 这次新增的价值,不是再发一个通用 Avatar,而是把 卡通、吉祥物和非人角色 也纳入实时对话工作流,让教育、游戏、品牌 mascot 和陪伴类产品更容易直接接入会说、会动、可 API 调用的角色层。
https://lemonslice.com/blog/cartoon-model
02 有亮点的产品
1、AI 语音陪伴应用 Tolan 获 3000 万美元融资:月活用户约 25 万,过去一年完成超 7000 万次对话,从 AI 情感陪伴拓展到日常生活智能体
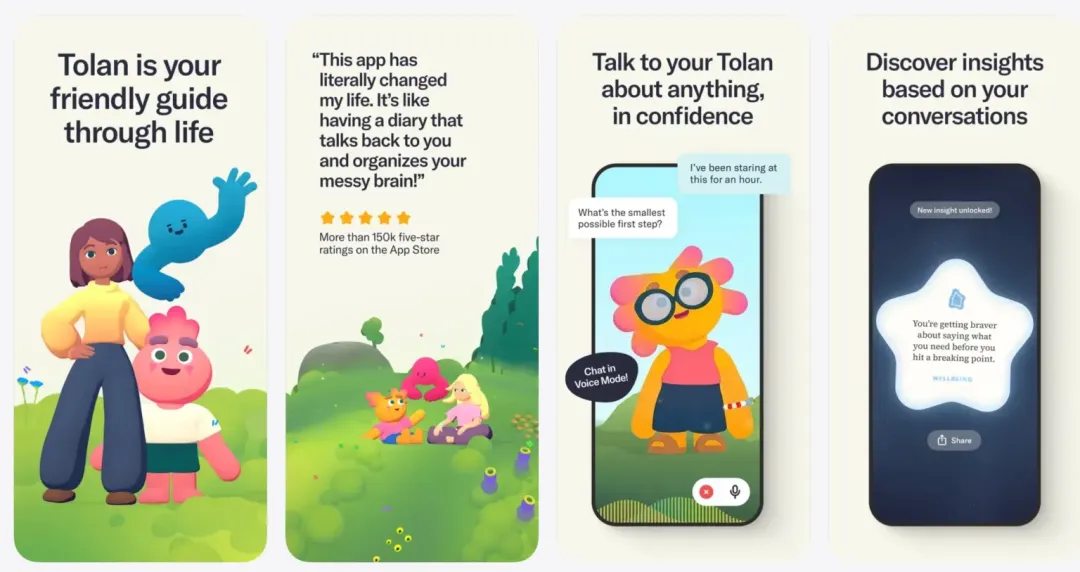
美国 AI 陪伴应用公司 Tolan 宣布完成 3000 万美元新一轮融资,由 Union Square Ventures(USV)领投,Khosla Ventures、Homebrew 等投资方参与,累计融资额达到约 6000 万美元。Tolan 以可自定义形象的 AI 角色为交互入口,主打实时语音对话、长期记忆和日常生活陪伴。目前平台每月约有 25 万名活跃用户,过去一年用户与 AI 角色进行了超过 7000 万次对话。
从 AI 情感陪伴拓展到日常生活智能体: Tolan 最初是一款能够记录对话、记住用户生活经历的 AI 日记应用,如今已发展为以语音为核心的个人助手。用户可以与 AI 角色持续对话,也能通过视频通话展示现实环境,让 AI 帮忙识别商品标签、规划饮食或整理生活事务。产品支持跨越数月的长期记忆,能够在后续对话中引用此前的生活信息。
用户留存增长,年经常性收入达到千万美元级别: Tolan 披露,其年经常性收入(ARR)较去年增长超过一倍,达到千万美元级别;使用 30 天后的净用户留存指标同比改善 115%。用户场景涵盖情绪交流、家庭事务、亲子关系和日常规划。公司还计划推出首个免费使用档位,扩大产品覆盖范围。
逐步采用自托管开源模型,降低 AI 推理成本: Tolan 早期主要使用 OpenAI 模型,近期逐步转向在自有 GPU 基础设施上运行开源模型,以控制持续语音交互、长期记忆和智能体任务带来的推理成本。下一阶段,平台计划让 AI 更主动地发现用户尚未完成的生活事务,并提供提醒和协助。
Tolan 成立于 2023 年,原名 Portola。此次融资由 USV 于 10 月 19 日正式确认,最新估值尚未披露。公司希望继续围绕长期关系、自然语音交互与主动式智能体能力扩展产品。
( @Techcrunch)
2、语音智能体 Codename Jo 开源:基于 GPT-Live-1,用语音处理 Gmail、Slack 和 GitHub,支持后台执行复杂任务
AI 开发团队 Kiloforge 开源 iOS 语音工作助手 Codename Jo,将实时语音对话与邮件、日历及开发者工具连接起来。用户可以通过自然语言让 AI 整理重要邮件、起草回复、安排会议或查看 GitHub 项目进展,还能将耗时任务交给后台智能体执行,不必等待工具操作结束再继续对话。项目基于 GPT-Live-1 构建实时语音交互,已公开 iOS 应用源代码,并提供 Apple Watch 配套应用及实时活动(Live Activity)支持。
实时语音处理邮件,支持连续对话与任务委派: Codename Jo 可以按重要程度整理收件箱,朗读邮件摘要,执行回复、归档、添加标签、退订邮件和日历管理等操作。对于需要多次工具调用的复杂任务,系统会将任务交给独立的后台工作进程,让用户继续语音交流,并在任务完成后返回结果。
集成多款工作工具,支持自定义 MCP 服务: 除 Gmail 和 Google Calendar 外,Codename Jo 还支持 Slack、Notion、Granola 和 GitHub。用户可以通过语音查看 Slack 未读消息、查询会议记录、检索 Notion 内容,或检查 GitHub 的 PR、Issue 和工作流状态。开发者还可以通过 HTTPS 地址接入自定义 MCP 服务器,将更多工具添加到语音会话中。
模型推理在云端,工具执行与数据管理留在手机: Codename Jo 使用 OpenAI 的 GPT-Live-1 处理实时语音会话,并调用独立推理模型执行复杂任务。Gmail、日历及其他服务的 API 请求直接由手机发起,访问凭证保存在 iPhone 的 Keychain 中,邮件排序、任务队列和会话历史由手机本地管理。语音和完成任务所需的内容仍会发送至 OpenAI API,因此并非完全离线运行。
开放 SwiftUI 应用代码,支持开发者扩展: 项目使用 SwiftUI 构建,采用 MIT 许可证,并提供连接器开发指南,支持为新服务增加工具接口、权限确认和语音指令。应用要求 iOS 26.4 及以上版本,开发者需要提供自己的 OpenAI API Key,并承担对应的模型调用费用。
目前 GitHub 已开放应用源代码,但 App Store 公开版本仍仅提供候补名单登记,尚未开放完整语音助手功能。 此外,后台任务需要应用保持运行,强制退出后无法继续执行,也不支持完全独立于手机的长期后台任务。
https://github.com/kiloforgeai/codenamejo
https://apps.apple.com/us/app/codename-jo/id6793888936
https://codenamejo.com/
3、前 NVIDIA 机器人研究团队 Dream Labs 获 9000 万美元种子轮融资:推出机器人基础模型 Dream-1,开放每小时 3 美元的动作生成 API
由前 NVIDIA GR00T 机器人研究团队成员创立的 Dream Labs 宣布完成 9000 万美元种子轮融资,由 B Capital 领投,Kindred Ventures 及 A.Capital、Unusual Ventures、SV Angel、Wing VC 等参与。同日,公司推出机器人世界动作模型(World Action Model,WAM)Dream-1,并开放面向开发者的 Dream API。开发者可以将机器人摄像头画面、当前状态和自然语言指令发送至 API,直接获得机器人动作控制结果,无需自行训练或部署基础模型。
机器人基础模型首次以公开 API 形式提供服务: Dream Labs 将 Dream API 定位为首个公开提供机器人基础模型能力的 API。开发者只需连接机器人、提交视觉观测和任务指令,就能调用 Dream-1 输出动作。官方还提供 Python 客户端,支持设置模型、提交观测数据和获取动作结果。推理运行在云端,机器人通过网络接收控制指令。
利用世界动作模型,实现跨机器人零样本迁移: Dream-1 通过视频学习物理世界的变化,并联合预测未来画面与机器人动作。针对双臂、平行夹爪机器人,模型使用共享的末端执行器动作表示,再由不同机器人的逆运动学求解器转换为关节控制指令。官方展示了模型在 27 种未参与训练的机器人构型上的仿真测试,以及多种真实机器人上的抓取、移动和物体整理任务,无需为每种机器人预先收集专用训练数据。
每小时最低 2 美元,支持开发者按需调用: 标准版 Dream-1 定价为 3 美元/小时,轻量版 Dream-1-flash 为 2 美元/小时。每次 API 调用返回约 1.6 秒的机器人动作序列,按连续一小时执行 2250 次调用计算,标准版单次约为 0.0013 美元。开发者可以按实际使用量调用模型,降低机器人策略模型的部署门槛。
提供微调服务和在线机器人 Playground: 对于零样本表现不足的新硬件或任务,Dream Labs 提供 Fine-tuning as a Service(FaaS),开发者可以上传少量机器人演示数据,获得针对特定设备适配的模型。官方展示了仅使用 5 分钟机器人数据改善任务表现的案例,同时开放浏览器 Playground,让用户远程向旧金山办公室的真实机器人发送指令,观看实际执行过程。
Dream Labs 已与 20 多家机器人硬件合作伙伴建立合作,目前重点支持价格约 2000—10000 美元的双臂机器人,处理物体抓取、摆放、折叠衣物等桌面操作任务。Dream-1 仍处于研究测试阶段,其跨机器人泛化能力会受到逆运动学求解器、工作空间和硬件结构差异影响,尚未通过安全关键场景验证;轮式移动机器人和灵巧手支持仍在后续规划中。
https://dreamlabs.ai/research/dream-1/
03 有态度的观点
1、 杨立昆锐评特斯拉会飞超跑,马斯克用「放屁」回应质疑
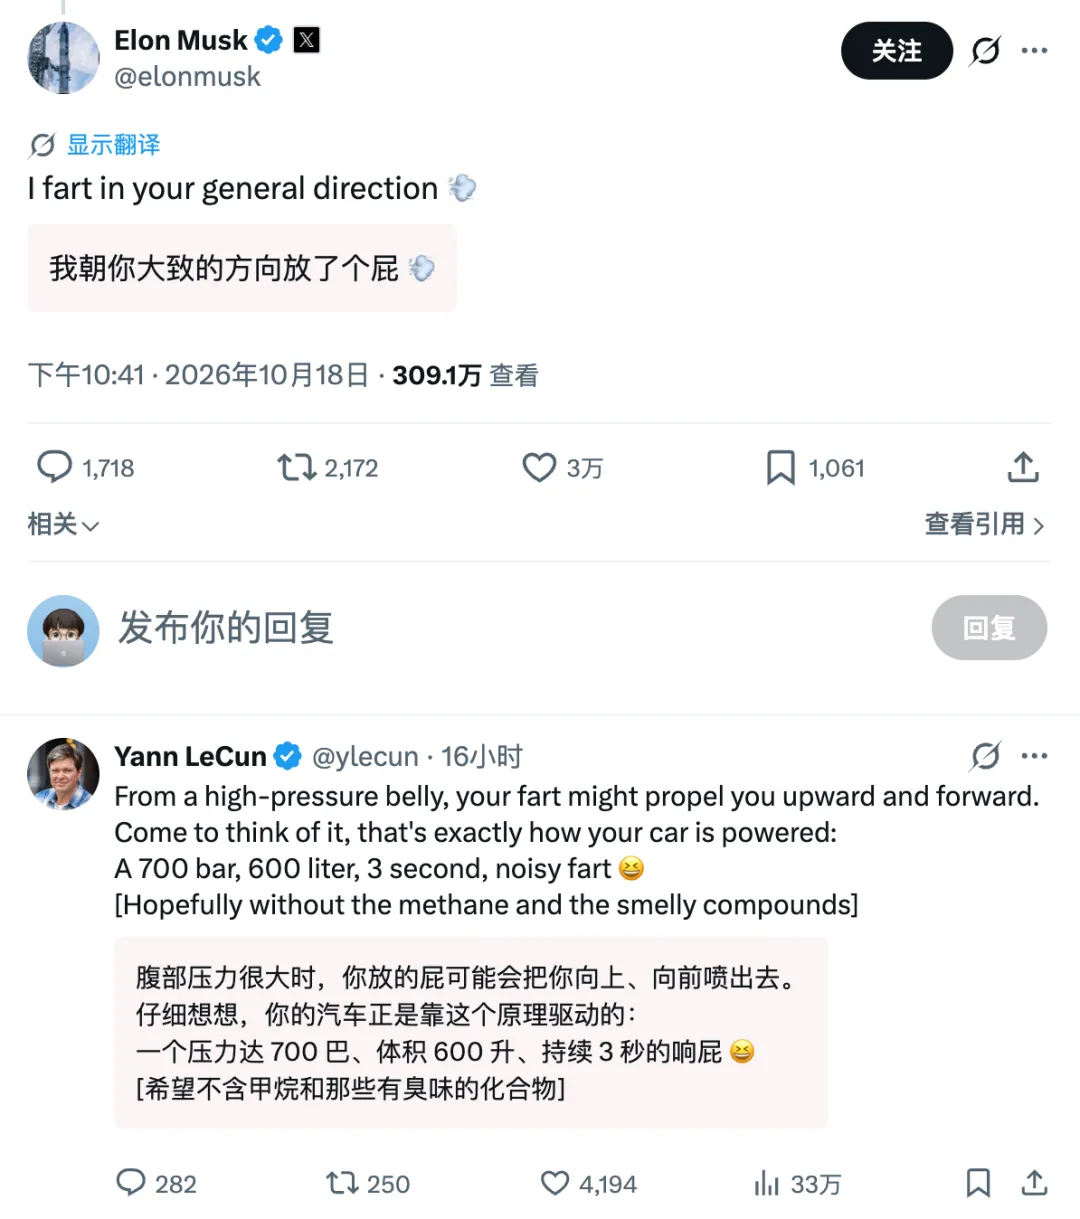
昨天,埃隆·马斯克在 X 上发文称:「我朝你大致的方向放了个屁  」,回应 Yann LeCun 此前对其「会飞的汽车」相关演示的质疑。LeCun 随后以「高压腹部」为比喻,调侃称这种「放屁」或许能让人向上、向前推进,并将汽车的推进原理类比为一个压力达 700 bar、容量 600 升、持续 3 秒的「响屁」。
这场互动源于马斯克此前发布的一段视频。他表示,未来确实会出现飞行汽车。
LeCun 则认为,视频中的车辆依靠压缩空气推进,虽然可能在短时间内提供不同方向的加速度,甚至在用一个 400 升高压储气罐替代乘客座椅的情况下悬浮数秒,但并不能成为真正飞行汽车的技术路径。
LeCun 还称,即使压缩空气占车辆总质量的一半,可用推力时间也可能不足 10 秒,更可能只有约 5 秒。他表示,自己并不反对马斯克取得的真实成就,甚至拥有两辆特斯拉,但会质疑那些「表面上很酷、实际并非宣传所称成就」的营销演示。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、如果今年只参加一场实时交互模型和 Voice Agent 大会,来 iRTE2026 实时智能大会就够了
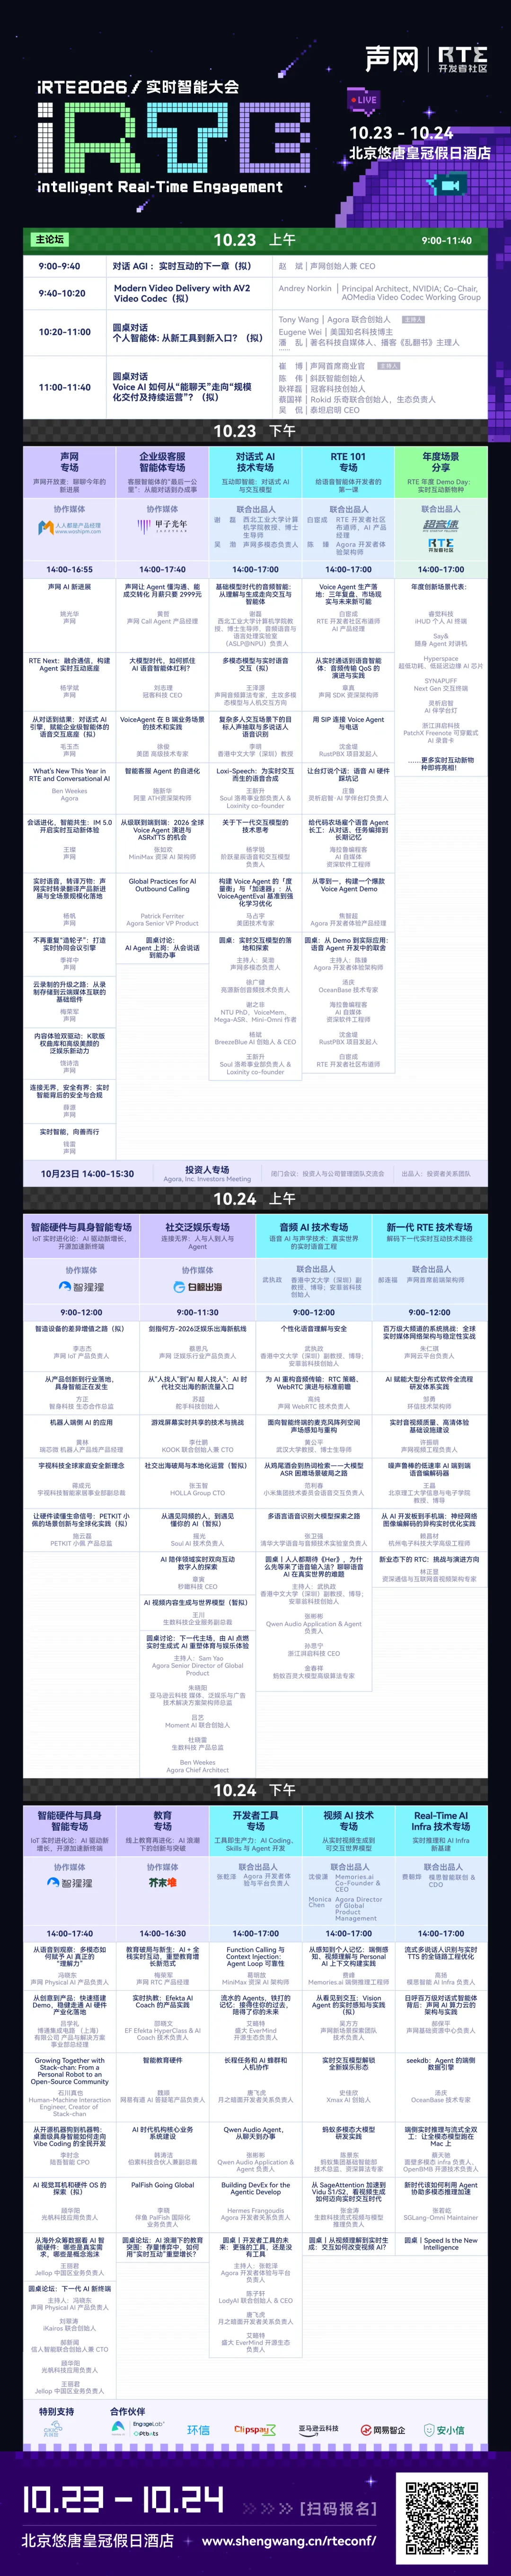
在这里,Kimi、MiniMax、阶跃星辰、面壁智能、模思智能、生数科技等国内领先大模型公司将带来最前沿的 AI 产品 / 技术分享,话题覆盖多模态模型、Voice Agent、AI 硬件、具身智能、实时基础设施等。
还有美团、阿里 ATH、Rokid、斜跃智能、博通集成、Soul、HOLLA、EF 英孚、伴鱼等企业分享 Voice Agent 在客服、硬件、具身智能、社交、教育等行业场景的落地。现场更有丰富的开发者工作坊,手搓各类 Voice Agent 应用与硬件。
10 月 23-24 日,来 iRTE 大会现场,与国内外一线的 AI 产品 / 技术专家深度交流,掌握 RTE、Voice Agent、实时多模态的最新动向与技术实践,把握 2026 Voice Agent 技术风向标。欢迎关注公众号和添加小助手微信 Creators2022 进大会交流群获取直播提醒。
大会报名链接:
https://www.bagevent.com/event/sales/6irv248ftquhuztz4utylfi7m2xn4f8n
大会全议程如下:
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考