Meta 提出全双工语音架构 RUBATO:答案生成提速 6.5 倍丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、Meta 提出全双工语音模型新架构 RUBATO:让 AI 边听边说边思考,推理回答速度提升 6.5 倍
Meta FAIR 与得克萨斯大学奥斯汀分校的研究团队提出 RUBATO,一种面向全双工语音模型的多流位置编码方法。该方法将实时语音交互与内部推理分配到独立的时间轴,使 AI 能够持续听取用户输入、生成语音回复,同时按照硬件允许的速度进行推理。论文显示,在保持首次语音响应时间不变的情况下,RUBATO 可将最终答案的生成时间缩短至原来的 1/6.5,并显著提升用户中途插话时的推理准确率。
为语音和推理设置独立时钟,打破固定解码速度限制: 传统全双工架构通常将语音输入、输出和内部思考放在同一条时间轴上,推理 Token 的生成速度必须服从固定的语音节奏。RUBATO 则为实时交互流和思考流设置独立的位置计数器,让语音按照固定节奏持续处理,推理部分根据 GPU 算力动态加速或减速。模型采用改进的旋转位置编码(RoPE),并通过独立 KV 缓存维持不同数据流的时间关系。
只需训练两种极端速度,即可适应不同硬件: RUBATO 在训练时仅使用两种推理配置:每个音频帧生成一个思考 Token,以及在一个音频帧内完成全部推理。部署时,模型无需针对不同 GPU 或解码速度重新训练,就能适应两者之间的推理速度。在语音数学推理测试 Spoken GSM8K 中,传统单时钟模型在部分未见过的速度下准确率跌至 1.7%,而 RUBATO-Full 在不同速度下保持 48.7%–51.1% 的准确率。
支持用户中途插话,同时处理新旧问题: 团队还设计了重叠对话测试:AI 正在思考并回答第一个问题时,用户突然提出第二个问题,模型需要同时完成语音输入、输出和推理。在这一场景下,RUBATO-Full 对插入问题的回答准确率达到 40.0%–45.1%,而传统单时钟基线在相应测试配置下几乎完全失效。在更高推理预算下,RUBATO 还可以将最终答案的生成时间缩短约 6 倍。
基于 Gemma 4 验证,不需要额外推理模型: 实验基于 Gemma-4 E4B-IT 构建,将用户音频、系统音频、用户文本、系统文本和内部思考组织为统一的自回归模型。音频使用 NanoCodec 编码,以 80ms 为一个处理帧。研究还证明,多时钟机制可以兼容现有 FlashAttention 推理实现,无需专门开发新的注意力计算内核。
RUBATO 论文于 10 月 9 日公开,目前仍属于研究阶段的架构方法,并非 Meta 已上线的新语音产品。实验使用合成语音和指定的数学、逻辑推理任务,尚未验证真实复杂通话环境中的表现;工具调用、视觉输入及更多并行数据流的适配也有待进一步研究。
https://arxiv.org/abs/2610.14299v1
2、清华系千诀科技发布 Polibrain 预测式世界模型:预测机器人动作对环境的影响,支持跨机器人复用
清华大学类脑计算研究中心团队孵化的具身智能公司 千诀科技,正式发布 Polibrain 预测式世界模型。该模型面向机器人在真实物理环境中的自主作业,通过学习环境状态、历史信息与行动结果之间的关系,预测不同动作可能产生的变化,并将预测结果用于机器人任务规划与控制,使机器人能够根据环境反馈持续调整行动。
直接预测动作引发的状态变化: Polibrain 在潜在表征空间中学习物体位置、交互关系和任务进度等关键信息,预测机器人执行不同动作后环境将如何变化。与主要生成未来画面的世界模型相比,Polibrain 更关注影响任务结果的物理状态及其变化关系,为机器人选择下一步动作提供依据。
多项式表征与因果记忆,提升复杂环境中的决策能力: 模型采用千诀科技自研的多项式表征架构,重点提取与当前任务相关的环境特征,减少背景纹理、光照等无关信息的干扰。团队还研究了基于反事实推断的历史信息筛选机制,帮助机器人识别值得保留的操作记录,应对物体遮挡、延迟反馈和多步骤任务中的状态变化。当实际执行结果与预测不一致时,系统可根据新的环境状态重新规划后续行动。
融合人类视频与机器人数据,支持跨本体适配: Polibrain 支持结合机器人操作数据、第一视角视频和人类操作视频进行训练,通过松耦合架构,将环境理解、行动预测和任务决策能力与具体机器人的控制系统分离。官方称,这些能力可适配人形、轮式、单臂、双臂及四足等不同机器人,减少针对不同硬件重复开发智能系统的工作。
千诀科技表示,Polibrain 相关能力已在服务、物流、零售及家庭等场景中开展商业应用与验证,涉及物体操作、跨楼层移动、多步骤任务规划和异常处理。公司官网已介绍 API、Web 调试及端侧 SDK 等接入方式,但尚未披露模型参数规模、标准化评测成绩和推理延迟,也未公开可供独立复现的模型权重及完整代码。
https://www.donews.com/news/detail/1/6747366.html
3、上海 AI 实验室开源世界动作模型 InternW0-Δ:融合 2 万小时机器人与人类操作数据,无需生成未来视频即可预测动作
上海人工智能实验室具身智能团队发布世界动作模型 InternW0-Δ,将视频生成模型对物理世界变化的预测能力与机器人动作生成结合,让机器人根据当前视觉画面、任务指令和历史操作信息预测下一步动作。模型使用超过 2 万小时机器人与人类操作数据进行预训练,在 LIBERO-Plus 机器人操作基准上达到 92.8% 的任务成功率,并已开放模型权重及训练、评测和部署代码。
融合视频预测与动作生成,无需先生成未来画面: InternW0-Δ 采用混合 Transformer(Mixture-of-Transformers,MoT)架构,将基于 Wan2.2-TI2V-5B 的视频专家与动作专家连接起来。视频专家学习物体及环境随时间变化的规律,动作专家则结合任务指令、当前视觉信息和机器人自身状态生成控制动作。两者通过定向注意力机制交换信息,让视频模型学到的动态知识服务于机器人操作。
Causal Imprint 学习未来变化,降低在线控制开销: 团队提出 Causal Imprint(因果印记) 机制,在训练时利用未来视频监督模型学习与动作相关的场景变化,例如物体移动、接触和状态转换。实际推理时,模型仅根据已经观察到的画面提取预测性特征,直接生成机器人动作,不需要先推演或生成未来视频。此外,模型通过训练期的 4D 蒸馏引入三维几何和运动信息,正式执行动作时也无需运行额外的 4D 教师模型。
2 万多小时混合数据,统一不同机器人的动作表示: 预训练数据来自机器人操作示范、UMI 手持操作数据、第一人称人类操作视频,以及经过动作映射的人类示范。团队将不同设备的关节、机械臂、夹爪、灵巧手及底盘控制信息统一到 80 维状态与动作表示,通过掩码处理不同机器人缺失的控制维度,使模型能够利用来自不同机器人形态和人类操作的数据。
多项机器人操作基准取得领先成绩: 在包含光照、背景和物体位置变化的 LIBERO-Plus 基准上,InternW0-Δ 达到 92.8% 的任务成功率;在考察环境变化下泛化能力的 RoboTwin Clean2Random 测试中达到 71.9%,超过 Qwen-RobotManip-Context 的 69.4%。在 RoboTwin Clean2Clean 测试中,成功率达到 90.0%。团队还展示了模型在配备夹爪及灵巧手的真实机器人上完成物体操作任务。
开放预训练权重与完整开发流程: 项目 GitHub 已公开数据处理、预训练、4D 蒸馏、任务微调、评测及真机部署代码,并在 Hugging Face 提供基础模型以及面向 LIBERO、RoboTwin、RoboDojo 的任务权重。代码采用 MIT 许可证,官方发布的模型权重标注为 Apache 2.0。开发者可以在已有模型基础上针对不同机器人和任务继续训练。
InternW0-Δ 的研究论文于 9 月 25 日公开,目前代码及权重已可下载。需要注意,超过 2 万小时指团队整理使用的预训练数据规模,不代表所有原始数据均已完整公开;不同数据集仍需遵循各自的许可证。现阶段公布的成功率主要来自指定仿真基准,真实机器人上的表现还需结合具体设备与任务评估。
https://internrobotics.github.io/InternW0-Delta/
02 有亮点的产品
1、日本 AI 数字人平台 DigiSelf 开放全球服务:云端语音对话响应中位数 1.17 秒,支持全离线运行的实时 Avatar SDK
日本东京 AI 视频生成公司 EmbodyMe 宣布将实时数字人平台 DigiSelf 推向全球市场。用户只需提供一张照片和 10–30 秒语音,或一段 30 秒至 2 分钟的视频,即可创建能够复现人物面部表情、口型、声音和说话风格的数字人,用于实时语音对话、视频生成及线上会议。此次全球扩张的核心亮点,是在提供云端 API 的同时,推出可部署在用户自有硬件上的全离线 SDK,让数字人实时交互不再依赖云端推理。
云端语音对话响应中位数 1.17 秒: 根据 EmbodyMe 自行开展的竞品测试,DigiSelf 在用户说完话后,中位数 1.17 秒即可开始回答,测试中的下一快竞品为 1.94 秒;对于直接输入的音频,云端服务开始生成数字人说话画面的中位数时间为 0.33 秒,比测试中下一快的服务快约 47%。官网称,测试覆盖 13 款服务,采用统一输入与尽可能一致的低延迟配置。上述数据来自厂商自测,并非独立第三方评测。
从云端 API 延伸至全离线数字人: DigiSelf 提供两种接入方式:云端 API 适合快速集成和弹性扩容;本地 SDK 则可运行在企业自有服务器、个人电脑及智能手机等设备上。官方称,离线 SDK 从收到音频到开始生成数字人画面的延迟可低至 5 毫秒,运行期间无需向云端发送用户数据,也不收取按分钟计费的使用费。需要注意,这一指标针对数字人画面生成,不代表完整语音 Agent 从用户提问到回答的端到端延迟。
已进入日本广播及公共活动场景: DigiSelf 于 2026 年 3 月首先在日本推出。日本文化放送与电通曾使用搞笑艺人田村淳的 AI 数字人播报新闻,主持人砂山圭大郎也曾在奥运报道期间由数字人代班。静冈县还使用知事铃木康友的 AI 数字人参与 TECH BEAT Shizuoka 科技活动开幕。这些案例展示了数字人在广播、公共活动及内容制作中的应用潜力。
一张照片即可生成多语言数字人视频: 除实时对话外,DigiSelf 还支持输入新脚本生成数字人视频,无需本人重新拍摄;平台支持多语言语音与视频生成,也可将动漫角色、动物、绘画等图像制作成可说话的形象。应用场景覆盖客户服务、营销、员工培训、虚拟接待和线上会议,并支持 Zoom、Google Meet、Microsoft Teams 等平台。
DigiSelf 已开放免费体验,开发者可通过 API 接入实时数字人,流式 Avatar 服务起价为 0.10 美元/分钟;离线 SDK 一次性授权费用为 9,900 美元起。此次发布的重点并非新的语音基础模型,而是将实时数字人能力从云端服务扩展到企业本地部署,在响应速度、数据隐私与部署灵活性之间提供不同选择。
https://digiself.tech/
2、Anthropic 推出主动式 Agent Claude Duet:后台持续处理任务,连接 6000 多种工具与应用
Anthropic 于 10 月 21 日开放主动式智能体应用 Claude Duet 的研究预览,面向需要管理复杂工作流的专业人士和小企业主。该应用基于 Claude Opus 5.5,可以主动整理关联应用中的重要信息、发送每日工作简报,并在用户离开后继续执行任务。从安排会议、跟进邮件,到制作数据仪表盘、生成财务预测和构建 Web 应用,Claude Duet 希望将 AI 从等待指令的聊天工具转变为能够主动发现问题、持续推进工作的助手。
从被动问答转向主动发现待办事项: Claude Duet 每天早晨会汇总关联应用中的重要信息,并在白天每隔数小时检查一次账户,仅在判断有事项需要用户关注时发送通知。用户还可以指定希望关注的内容和通知频率,例如发现日程冲突、提醒逾期发票,或根据客户沟通记录准备跟进邮件。
借助云端虚拟机,用户离开后任务仍可继续: Claude Duet 拥有独立的云端虚拟机和浏览器,可以在用户的电脑或手机关闭后继续工作。用户只需通过文字或语音描述任务,Agent 就会自行选择需要使用的应用、规划执行步骤,并在任务完成或需要审核时通知用户。应用还继承 Claude 账户中的记忆、技能和已连接应用,减少重复配置。
连接 6000 多种工具,覆盖从办公到业务运营的工作流: Claude Duet 可调用 Claude Marketplace 中的 6000 多种连接器和插件,支持检索 Gmail、Slack 信息,处理 QuickBooks 或 Stripe 中的未付款发票,准备工资数据、起草招聘信息,以及在 Canva 中制作营销内容。它也支持通过 Stripe Link 和 Shopify Shop Pay 购买商品,但支付等敏感操作仍需用户确认。
重要操作需要审批,并增加敏感信息防护: Claude Duet 在发送消息、付款、签署文件或删除内容前,会向用户展示具体操作并等待批准。Anthropic 还为其增加了专门的敏感信息分类器与安全提示,限制信用卡号、政府身份证件等高敏感信息的外传;健康和个人财务等信息则只有在用户明确要求发送时才允许处理。用户也可以随时断开应用连接。
Claude Duet 目前处于研究预览阶段,通过候补名单向美国地区的 Claude Pro 和 Max 用户开放,可在 iOS、Android 独立应用及 claude.ai 网页端使用,暂不等同于独立的桌面客户端。预览期间不额外收费,但后台检查和复杂任务会消耗现有 Claude 使用额度。Anthropic 也承认,当前版本仍可能误判事项的重要程度,个人事务处理能力相对较弱,且暂时无法直接展示其浏览器操作过程。
https://claude.com/resources/articles/claude-duet
3、前豆包 PC 负责人创立的 Today AI 累计融资超 2 亿美元:腾讯、蚂蚁等参投,主打主动式个人 AI 助理
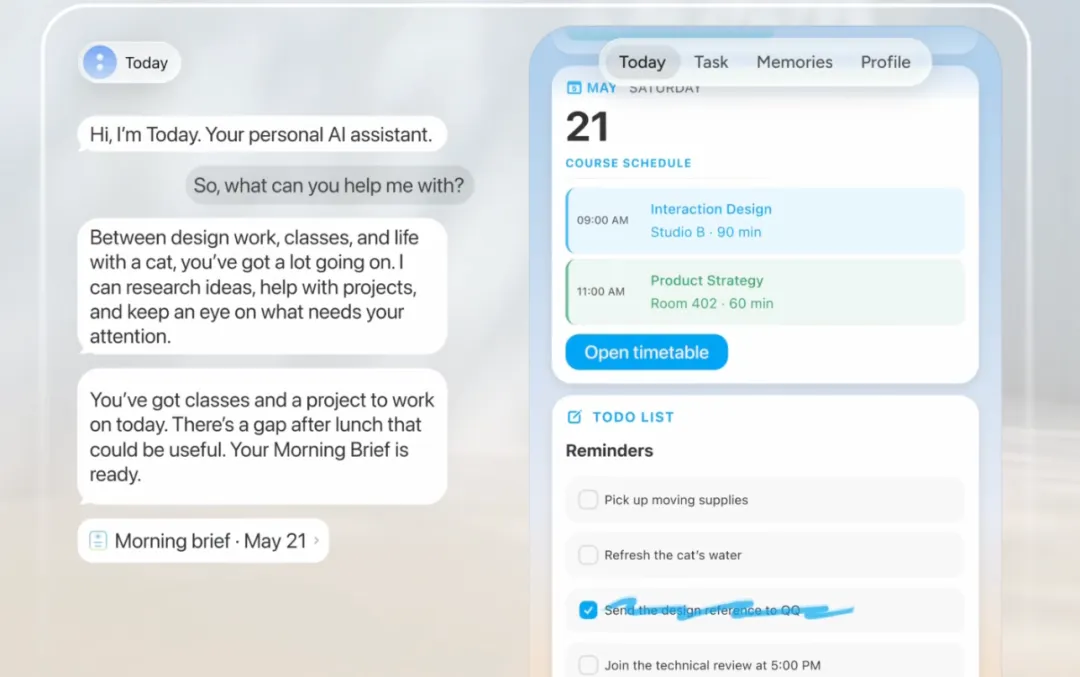
个人 AI 助理公司 Today AI(此间无限) 宣布累计完成超过 2 亿美元融资,投资方包括 IDG 资本、腾讯、五源资本、蚂蚁集团、红杉中国、传音控股、同歌创投及上海交大菡源资产。公司由 Teambition 创始人、前飞书产品副总裁及豆包 PC 端负责人齐俊元创立,核心产品 Today 于今年 9 月在国内上线,主打长期记忆、主动协助和跨设备任务执行。
从被动问答转向主动式个人助理: Today 通过持续交互积累用户的日程、人物、项目和个人偏好等信息,在用户提出需求前主动发现需要处理的事项,例如日程冲突、工作进度变化及待办任务,并提供晨间简报、资料研究、行程规划和工作协助等服务。其记忆系统支持用户查看、编辑和管理个人信息。
连接国内办公与生活应用,支持跨平台协作: Today 已支持 iOS、Android、Windows、Mac 和 Linux,并可连接企业微信、微信读书、百度网盘、金山文档、腾讯会议等应用。用户可以让 AI 整理工作群消息、记录读书笔记、检索网盘文件、跟进文档修改和生成会议纪要,减少在不同应用之间切换及重复输入信息的工作。
通过云端电脑持续执行复杂任务: Today 官网介绍,平台具备任务规划、工具调用与进度检查能力,并配有可操作浏览器、处理文件和运行代码的云端电脑,使任务不必完全依赖用户设备持续在线。产品还支持社区 Skills,供用户扩展不同场景的工作流。
Today AI 成立于 2026 年 3 月,此次披露的超过 2 亿美元为累计融资额,并非单轮融资金额。目前官方尚未公布具体活跃用户规模、任务执行成功率及端到端交互延迟等指标,也未披露其底层模型的完整技术架构。
https://todayai.cn/
03 有态度的观点
1、Codex 推出永久对话缓存
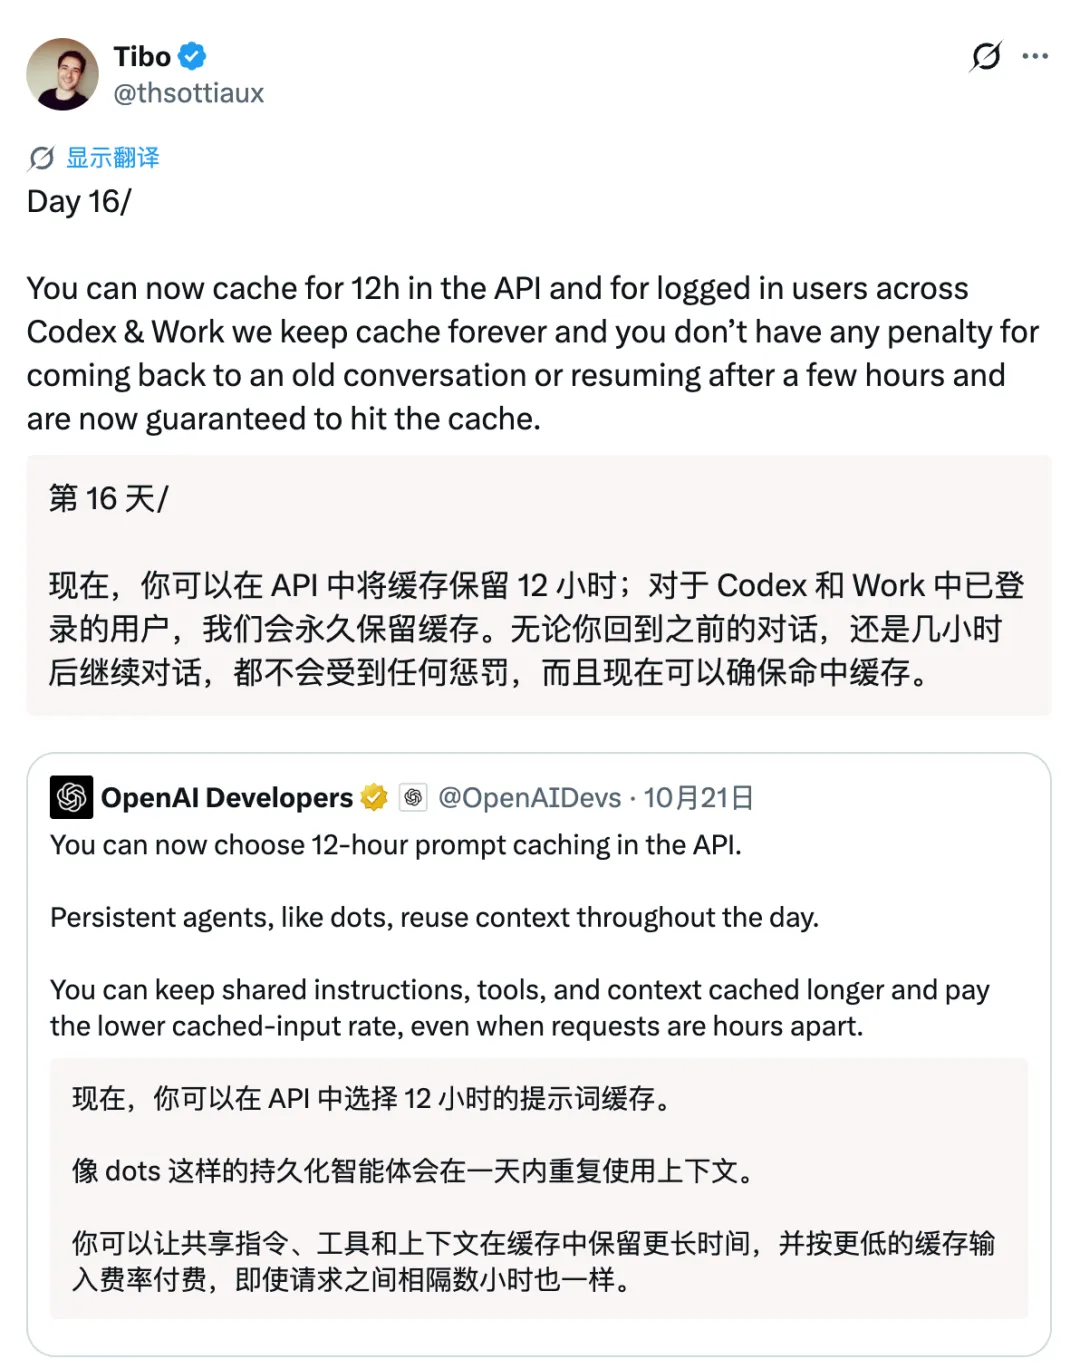
OpenAI 产品负责人 Tibo Sottiaux 宣布,API 现可选择 12 小时提示缓存;对 Codex 和 Work 的已登录用户,公司会永久保留缓存。用户回到旧对话,或中断数小时后继续,也可命中缓存。
OpenAI Developers 的公告解释,长期运行的智能体会在一天中反复使用相同上下文。
新选项可让共享指令、工具和上下文保留更久,即使两次请求间隔数小时,仍可按较低的缓存输入费率计费。Tibo 将这项变化列为「第 16 天」更新,并表示恢复旧会话不会受到额外惩罚。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、如果今年只参加一场实时交互模型和 Voice Agent 大会,来 iRTE2026 实时智能大会就够了
在这里,Kimi、MiniMax、阶跃星辰、面壁智能、模思智能、生数科技等国内领先大模型公司将带来最前沿的 AI 产品 / 技术分享,话题覆盖多模态模型、Voice Agent、AI 硬件、具身智能、实时基础设施等。
还有美团、阿里 ATH、Rokid、斜跃智能、博通集成、Soul、HOLLA、EF 英孚、伴鱼等企业分享 Voice Agent 在客服、硬件、具身智能、社交、教育等行业场景的落地。现场更有丰富的开发者工作坊,手搓各类 Voice Agent 应用与硬件。
10 月 23-24 日,来 iRTE 大会现场,与国内外一线的 AI 产品 / 技术专家深度交流,掌握 RTE、Voice Agent、实时多模态的最新动向与技术实践,把握 2026 Voice Agent 技术风向标。欢迎关注公众号和添加小助手微信 Creators2022 进大会交流群获取直播提醒。
大会报名:
https://www.bagevent.com/event/sales/6irv248ftquhuztz4utylfi7m2xn4f8n
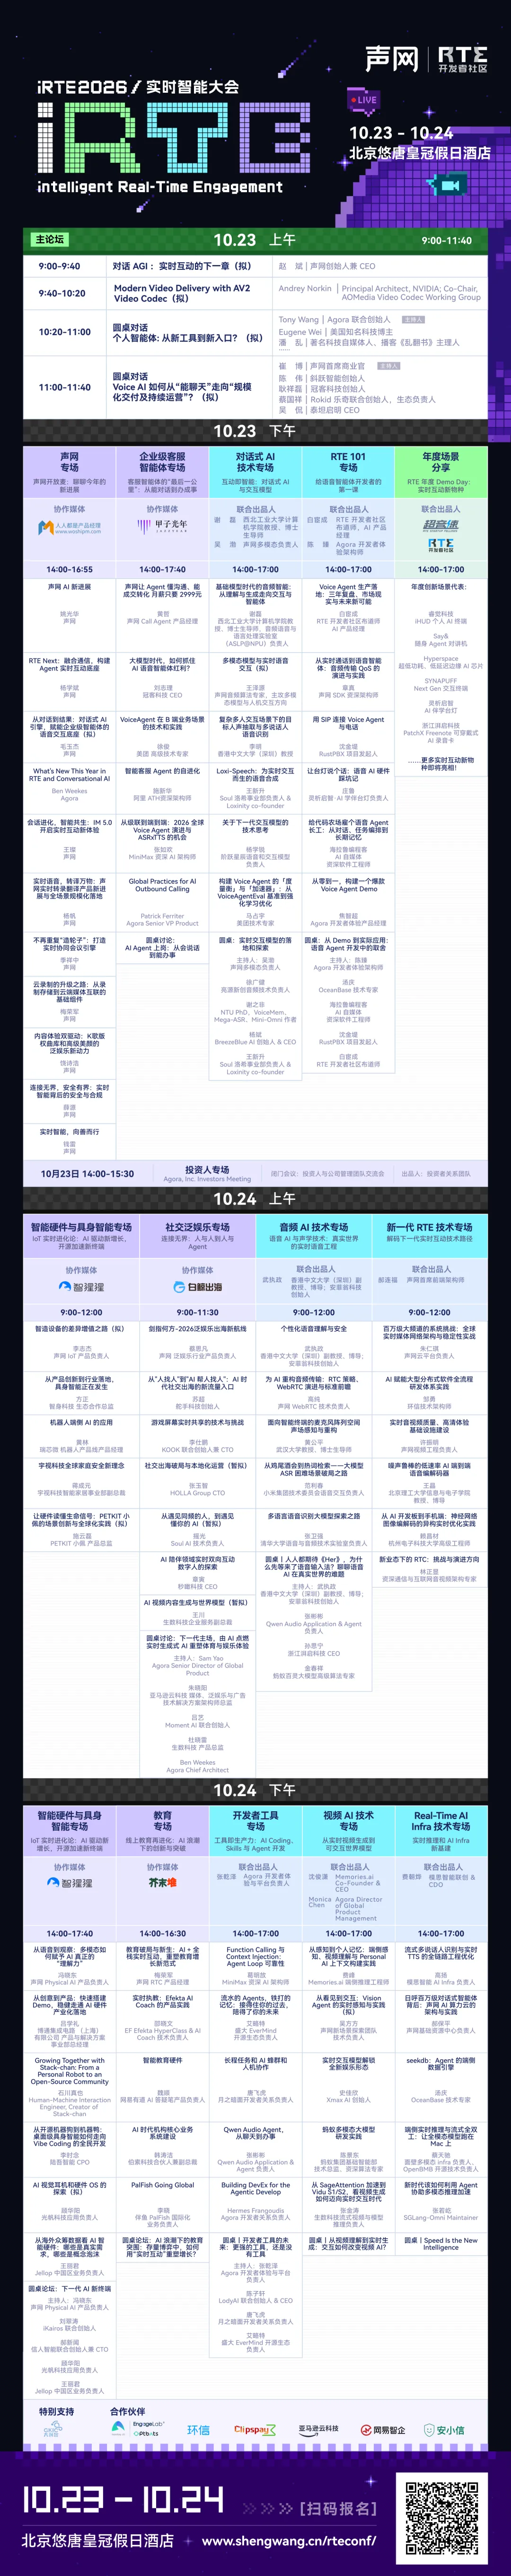
大会全议程如下:
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考