Pika 发布实时交互视频项目 Enact,支持实时指导 AI 演员与控制运镜丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、Inworld 开源语音降噪模型 Voice Isolator 与轮次检测模型 SAVA:发言结束检测中位延迟 71ms
语音 AI 公司 Inworld 开源 Voice Isolator 和 SAVA(Semantic-Acoustic Voice Activity)两款模型,并发布 Realtime TTS-2 技术报告。此次开放的模型分别面向实时语音交互中的音频降噪、语音活动检测与轮次判断,帮助 Voice Agent 在复杂声音环境下保留有效语音信息,并判断用户何时真正结束发言。
Voice Isolator 支持 48kHz 实时语音降噪: 提供离线与实时流式两个版本,实时版本采用 20ms 前瞻窗口,算法延迟为 63ms。在消除背景人声、音乐和环境噪声的同时,保留原始音色、呼吸、笑声及叹气等非语言声音,避免丢失对话中的交互信号。
SAVA 将 VAD 与语义轮次检测合并: 每 40ms 输出语音活动与发言结束两种概率,结合语义和声学上下文区分句中停顿与真正结束发言。在 AMI 会议数据集的 5043 个轮次结束事件测试中,检测延迟中位数为 71ms,对比 Pipecat Smart Turn v3.2 的 210ms,200ms 内检测率分别为 85.5% 和 30.8%。
公开 Realtime TTS-2 技术报告: 披露模型在自然语言表达指令遵循、跨语言声音克隆和流式语音生成方面的训练方法。此次发布的是技术报告,并非开放 TTS-2 模型权重。
两款模型均采用 Apache 2.0 许可证: Voice Isolator 和 SAVA 的代码及权重均已开放,允许商业使用。开发者可通过 GitHub、Hugging Face 下载模型,并通过 Python 进行本地部署。
https://inworld.ai/blog/introducing-voice-isolator
https://inworld.ai/blog/introducing-sava
2、AssemblyAI 发布 STT-3.7 系列语音识别模型:区分实时字幕与 Voice Agent 场景,最终转写延迟低至 86ms
语音识别公司 AssemblyAI 发布新一代 STT-3.7 系列模型,包括面向会议及实时字幕的 Realtime、面向语音智能体的 Realtime-Agent,以及录音转写版本。两款实时模型均支持在同一音频流中自动识别 32 种语言,但针对不同场景分别优化说话人区分、轮次检测、背景人声抑制及响应延迟。
Realtime 版面向实时字幕与会议: 支持在每段发言结束时直接确定说话人标签,无需等待后续标签修订。官方测试中,短句英语识别错误率(WER)为 3.23%,混合语言识别错误率为 6.67%,定价为每小时 0.30 美元。
Realtime-Agent 版面向语音智能体: 集成发言结束判断,最终转写延迟为 86ms,并针对简短确认语、姓名、电话号码及订单编号等关键实体优化识别能力。官方测试中,用户沉默期间因背景人声而额外转写的词数减少 47%,高噪声环境下 WER 为 5.32%,定价每小时 0.45 美元。
录音转写版支持最多 99 种语言: STT-3.7 基础版原生支持 32 种语言,并可通过可选的语言回退机制扩展至 99 种语言,面向录音文件转写及说话人区分,定价每小时 0.21 美元。
已通过现有 API 开放: 两款实时模型沿用原有实时语音识别接口及消息协议,开发者只需修改
speech_model参数即可切换。其中 Realtime 版不提供面向 Agent 的轮次判断能力,需要此功能的应用应选择 Realtime-Agent。
https://www.assemblyai.com/blog/introducing-assemblyai-stt-3-7
3、阿里 Qwen Audio 联合上海交大、上海创智学院的语音推理论文获 ACM MM 2026 杰出论文奖:中间文本 Token 开销减少 60%
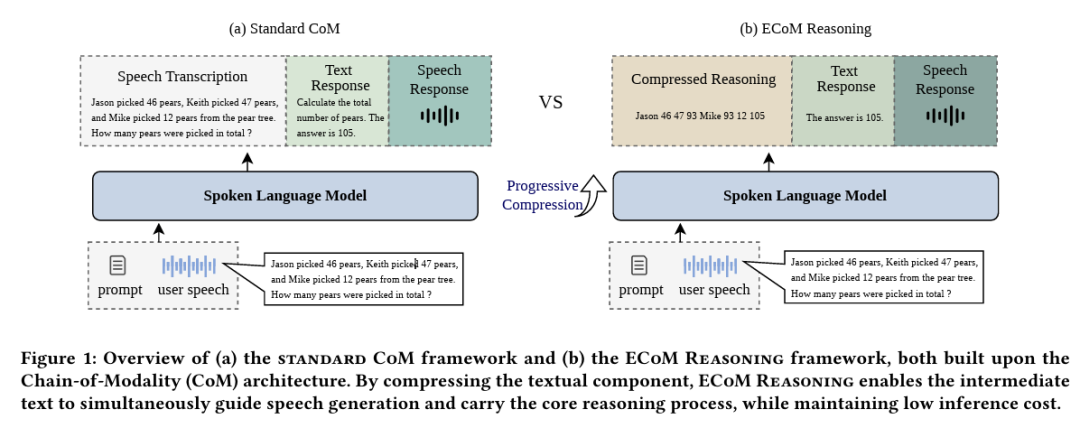
阿里巴巴 Qwen Audio 团队与上海交通大学、上海创智学院合作完成的 ECoM Reasoning 研究获得 ACM Multimedia 2026 主会 Multimedia Reasoning 方向杰出论文奖(Outstanding Paper Award)。该研究针对端到端语音大模型在数学等复杂推理任务中准确率低、中间文本推理开销高的问题,提出高效模态链推理框架,通过渐进式压缩减少推理 Token 数量,同时提升语音问答准确率。
压缩模态链中的中间文本: 传统 Chain-of-Modality(CoM)架构通常先生成中间文本,再生成语音。ECoM Reasoning 将中间文本压缩为同时承载推理信息和语音生成指导的表示,减少冗长推理过程带来的计算开销。
提出渐进式压缩训练策略: 采用课程学习方法,让模型先学习完整的推理过程,再逐步过渡至压缩推理,避免直接缩短推理链导致推理能力下降。
仅使用完整推理方案 40% 的文本 Token: 在口语数学问答基准测试中,论文报告 ECoM Reasoning 相比没有显式推理的标准 CoM 方案准确率提升约 21%,相比包含完整推理链的 CoM 方案提升约 3%,同时减少约 60% 的中间文本 Token 开销。
https://arxiv.org/abs/2607.19932
https://github.com/QwenAudio/FunResearch
4、独立开发者 uezo 发布多语言 TTS 模型 Maid K2-3481:使用合成语音训练,开放模型及训练数据集
独立开发者 uezo 发布基于 Style-Bert-VITS2 架构的角色语音合成模型 Maid K2-3481 Multilingual,支持日语、英语和中文。模型采用 Irodori-TTS 与 Qwen3-TTS 生成的合成语音作为训练数据,尝试减少角色音色开发对真人录音的依赖,并同步公开训练数据集,面向 AI 角色、虚拟伙伴及多语言语音应用。
基于 Style-Bert-VITS2 架构: 提供原创 AI 女仆角色音色,支持日语、英语及中文三种语言的语音合成。
使用合成语音构建训练数据: 通过 Irodori-TTS 和 Qwen3-TTS 生成训练音频,开发者强调训练数据的版权来源,并同步开放数据集,供其他开发者参考和复用。
支持多种语音合成工具与部署方式: 模型已发布至 Hugging Face 和 AivisHub,支持 Style-Bert-VITS2 推理,并提供适配 AivisSpeech 和 Aivis Cloud API 的日语版本及 JP-Extra 版本。
https://x.com/uezochan/status/2123240365037891631
02 有亮点的产品
1、AI 视频公司 Pika 发布实时交互视频研究项目 Enact:支持实时指导 AI 演员、调整场景与控制运镜
Pika 发布基于 Pika H3 Flex 的实时交互视频研究项目 Enact,将传统 AI 视频生成从输入提示词、等待成片的模式扩展为持续交互的创作过程。系统以亚秒级时间块生成视频与声音,在保留场景上下文的同时接收新的导演指令,使创作者能够在视频生成过程中与虚拟演员交流、调整场景布局及控制摄像机。
实时场景布置(Live Staging): 创作者可直接拖动场景中的人物及道具,模型根据位置变化持续生成后续画面,而无需重新生成整段视频。
实时演员指导(Live Actor Direction): 支持通过语音或文字指导虚拟演员的台词、动作及表演方式,在生成过程中进行排练和调整。
实时摄像机控制(Live Camera Control): 创作者可在场景持续生成时改变摄像机位置、视角及运动方式,探索更接近真实片场的导演工作流程。
基于 Pika H3 Flex 构建: 该项目复用此前发布的实时音视频生成模型,通过连续生成与交互控制维持场景一致性。目前属于研究预览阶段,已开放 Demo 申请,尚未全面上线或开放独立 API。
https://pika.art/blog/pika-enact
2、Agent 通信基础设施公司 Linq 获 a16z 领投 9000 万美元 B 轮融资:估值达 10 亿美元,新增高清语音通话能力
AI Agent 通信基础设施公司 Linq 宣布获得由 a16z 领投的 9000 万美元 B 轮融资,累计融资超过 1.2 亿美元,估值达到 10 亿美元,a16z 联合创始人 Ben Horowitz 加入董事会。Linq 此前主要为 AI Agent 提供即时通信基础设施,此次进一步扩展至高清语音通话与计算机操作,帮助 Agent 通过用户熟悉的通信渠道完成实际任务。
累计处理超过 10 亿条消息: Poke、DoorDash、Town 等 AI 应用已接入 Linq 的通信基础设施,支持 Apple Messages for Business、WhatsApp、RCS 和 SMS 等渠道。
推出 HD Calling for Agents: 新增面向 AI Agent 的高清电话通话服务,使开发者能够将语音通话纳入现有消息交互及任务执行流程,向用户提供更接近手机之间通话的音频体验。
扩展计算机操作基础设施: 为 Agent 提供实际计算资源,使其能够操作软件、处理表单和执行任务。浏览器操作基础设施公司 Kernel 是首批计算服务客户之一。
持续投入软硬件基础设施: Linq 最初于 2020 年从数字名片业务起步,随后转向销售软件、AI 销售智能体及 Agent 通信基础设施。本轮融资将用于扩展消息、语音和计算能力。
https://a16z.com/announcement/investing-in-linq/
3、OpenAI 为 ChatGPT 上线实时语音输入 Live Dictation:边说边转写,取消 10 分钟录音时长限制
OpenAI 宣布升级 ChatGPT 的语音输入功能,推出 Live Dictation。此前用户需要结束录音后等待语音转写,新版本支持在用户讲话过程中持续生成文本,支持实时流式语音转写,减少长段语音输入完成后的等待时间,并取消原有的 10 分钟单次录音时长限制。
https://help.openai.com/en/articles/6825453-chatgpt-release-notes
4、实时 AI 基础设施平台 uRun 发布多模态决策模型 Sense:支持自定义轮次判断、打断检测与 Agent 行为控制
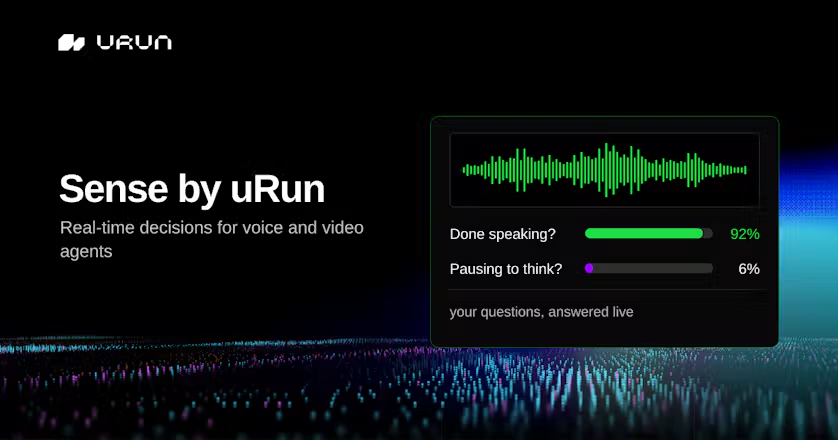
实时 AI 基础设施平台 uRun 推出面向语音及视频智能体的多模态实时决策模型 Sense。受 Jev 决策模型启发,Sense 被定位为 Agent 的 System 1(快速决策系统),通过持续接收音频、视频及文本输入,每秒多次回答开发者预设的问题,判断用户是否结束发言、是否正在打断 Agent,以及当前对话状态是否需要触发特定行为。
支持三类可编程决策任务: 提供 Nouls(二元判断)、Choices(多选项分类)和 Scores(有序等级评分),开发者可使用自然语言自定义判断条件,模型返回决策结果及置信度。
持续感知流式多模态输入: 支持实时音频、视频帧及文本上下文输入。SDK 示例采用 24kHz 单声道 PCM16 音频、40ms 音频分块,并持续返回批量决策结果,可用于区分用户附和与真正的发言打断。
通过条件组合触发 Agent 行为: SDK 支持组合多个判断条件及事件回调,例如在确认用户结束发言、且意图属于客户支持时触发 Agent 回应,使实时感知和行为决策独立于主语言模型运行。
开放 Python 与 TypeScript SDK: SDK 采用 Apache 2.0 许可证,提供麦克风输入、实时会话及语音 Agent 示例。新注册账户可获得 1000 免费积分,目前尚未公开 Sense 模型权重。
https://github.com/urun-sh/sense-sdk
03 有态度的观点
1、AMD 高管:AI 无法取代需要高精度计算的超级计算机
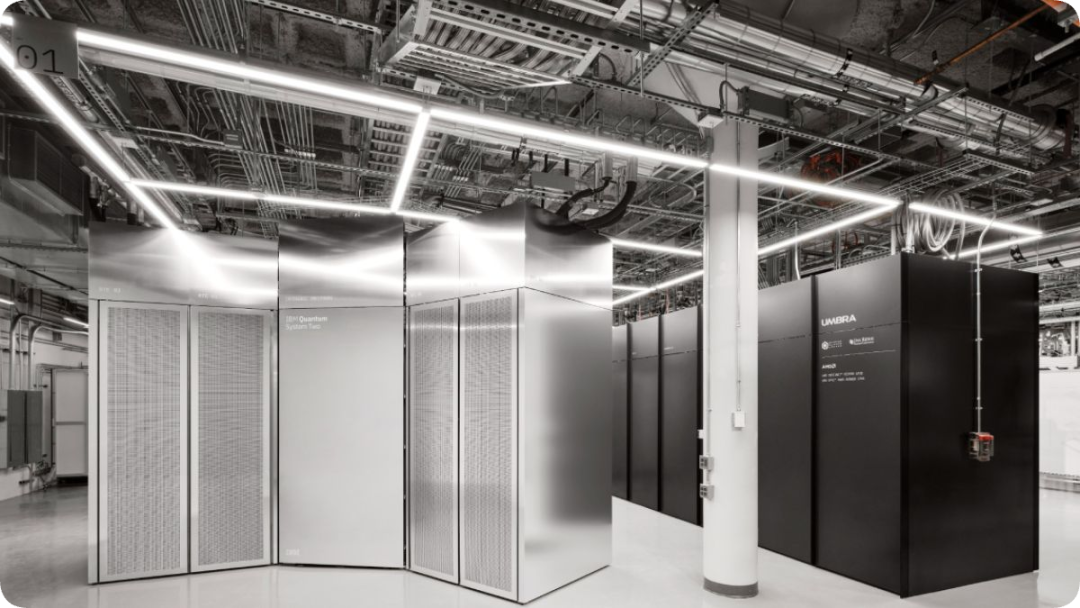
AMD 高性能计算与主权 AI 企业副总裁 Scott Tease 在接受 Tom's Hardware 采访时表示,多数高性能计算研究机构已经认识到,AI 不会取代传统 HPC;依赖双精度 FP64 的科学计算,还会存在很长时间。他认为,AI 已成为科学发现的重要组成部分,部署方式会影响它发挥作用的方式。
例如,可以让多个 AI 智能体探索不同研究路径,把复杂仿真留给传统高精度计算系统。彼此孤立、缺乏互联的 CPU 或 GPU 集群,难以跟上这种工作方式。Tease 提出的方向是将 AI、HPC 和量子计算连接为统一计算体系,判断每项任务何时适合 AI、GPU 加速或量子环境。
AMD 正与 IBM、橡树岭国家实验室合作,把经典计算、Umbra HPC 系统与 IBM 的 129 量子比特 Quantum Nighthawk 接入同一研究环境,探索混合系统的软件、架构和工作流。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 社区伙伴活动推荐|极客公园创新大会 IF 2027
关注 AI Agent、智能硬件和 AI 创作的小伙伴,可以留意这场活动~
本届大会以「Revaluation 价值,另有答案」为主题,嘉宾阵容包括 Manus、影视飓风、影石、OPPO 等团队。从人与 Agent 如何协作,到 AI 硬件的体验变化,再到创作者如何找到新价值,现场将分享各自的探索与思考。
 时间:2026 年 12 月 5—6 日
 地点:北京·798 艺术区
感兴趣的朋友可以看看完整嘉宾阵容和活动介绍,欢迎相约现场交流!
影视飓风、Manus、影石、OPPO...齐聚极客公园创新大会 2027|社区伙伴活动推荐
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考