OpenAI 社区热门作品 Dream Logger:基于 M5Stack 语音 AI 将梦境生成插画丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、字节跳动上线数字人视频生成模型 OmniHuman 2.0:理解音频语义与情绪,支持最长 5 分钟连续镜头,成本降低超 40%
字节跳动通过 BytePlus 正式推出 OmniHuman 2.0,将音频驱动的数字人视频生成能力从口型同步扩展至语义理解与全身动作生成。开发者只需提供一张人物图片和一段语音、音乐或对话音频,模型便可根据声音的语义内容、情绪和节奏,生成匹配的面部表情、肢体动作及镜头表现。相比此前版本,新模型支持最长 5 分钟的连续镜头生成,单秒视频生成价格从 0.12 美元降至 0.07 美元。
从口型同步扩展至音频语义驱动的动作生成: OmniHuman 2.0 能够结合音频中的语义、语调、节奏和情绪变化,生成对应的面部表情、手势及全身动作。例如,角色可以根据台词内容调整动作与情绪,也能跟随音乐节拍表现不同的舞蹈或演唱动作。模型支持普通讲话、歌唱和多人对话,并改善了快速语音、高音演唱等场景中的口型与动作同步效果。
最长生成 5 分钟连续镜头,减少长视频拼接: 新版本将单次视频生成时长从此前的不足 60 秒延长至最长 300 秒,支持以单张参考图片和音频生成完整连续表演,减少短片段拼接造成的人物外观、动作和背景不一致问题。模型支持 720p 视频输出,可用于数字人讲解、音乐视频、短剧及营销内容制作。
支持文本指令控制人物动作、场景与镜头: 除图片和音频外,开发者还可以添加可选文本提示词,指定人物动作、镜头移动、物体生成和场景交互。例如,让角色在讲话时走向指定位置、拿起物品,或让摄像机围绕人物移动。模型也支持卡通、动漫、动物及其他非真人形象。
API 已开放,视频生成成本下降约 42%: OmniHuman 2.0 已通过 BytePlus 提供在线体验和 API 服务,按生成视频时长计费,价格为 0.07 美元/秒,相比此前的 0.12 美元/秒降低约 41.7%。按标准单价计算,生成一段完整的 5 分钟视频约需 21 美元。
目前 OmniHuman 2.0 已正式上线,开发者可通过 BytePlus 接入。需要注意的是,该模型面向预先提供音频的视频生成任务,并非能够在视频通话中实时响应用户的交互式数字人模型。官方尚未公布生成速度、端到端延迟及独立量化评测数据。
https://www.byteplus.com/en/product/OmniHuman
https://x.com/BytePlusGlobal/status/2110643232363422074
2、AI 教育平台 StudyFetch 推出企业培训智能体 Honen:自动生成互动课程,支持语音 AI 导师,并与 NVIDIA 合作开展 AI 培训
美国 AI 教育公司 StudyFetch 推出企业学习与培训平台 Honen,能够将企业内部文档、知识库和操作流程自动转换为交互式课程,并通过语音 AI 导师、模拟练习和个性化反馈帮助员工掌握新技能。平台还与 NVIDIA 合作,将 Deep Learning Institute(DLI)和 NVIDIA Academy 的课程引入学校及职业培训体系,计划首先覆盖 25 万名美国高中生。
企业知识自动转化为互动课程: 用户上传培训文档、连接企业知识库或输入课程主题后,Honen 可自动完成资料整理、课程大纲、教学内容和考核设计。课程支持视频、播客、游戏、记忆卡片和互动项目等形式,并可通过现有学习管理系统(LMS)分发。当企业制度、产品或工作流程发生变化时,课程智能体可以检查相关资料,提出内容更新建议,再由管理员审核发布。
语音 AI 导师支持实时对话与场景模拟: 学员可以通过语音或文字向 AI 导师提问,获得基于课程资料的个性化讲解。平台还支持模拟客户会议、销售对话等角色扮演练习,以及屏幕共享辅导。例如,员工学习使用新软件时,可以共享操作界面,由 AI 导师实时提供步骤指导,并根据完成情况反馈。
与 NVIDIA 合作扩大 AI 教育覆盖: Honen 正在整合 NVIDIA DLI 和 NVIDIA Academy 课程,为高中生及在职人员提供 AI 技能培训。其母公司 StudyFetch 还将实时课堂转写系统迁移至 NVIDIA Riva、Parakeet ASR 和 NIM,据 NVIDIA 披露,该项转写工作负载的推理成本降低约 10 倍。双方还计划扩展 NVIDIA Riva TTS 语音辅导和 Nemotron 模型的应用。
Honen 已开放产品体验和企业演示申请。需要注意的是,Honen 并非本周新发布产品:其平台已于 2026 年 6 月正式推出,与 NVIDIA 的教育合作更早已公布;25 万名学生属于合作项目的初始覆盖计划,并非已确认的活跃用户规模。目前官方尚未公布语音 AI 导师的端到端响应延迟或底层语音模型评测数据。
https://honen.com/news/introducing-honen
3、MLX 开发者展示 Mac 端语音智能体 JOSIE-Voice:M4 Pro 实录 6 分钟语音通话,支持 100 多种工具调用
MLX 开源生态贡献者、独立开发者 Gökdeniz Gülmez 展示了其开发的 macOS 语音智能体 JOSIE-Voice,在搭载 M4 Pro 芯片的 MacBook Pro 上完成约 6 分钟连续语音通话,演示视频未进行加速或压缩处理。该系统采用端侧语音处理与云端大模型结合的架构,以本地 Qwen3-ASR、Qwen3-TTS 处理语音输入和输出,并通过 Ollama Cloud 调用 DeepSeek V4.1 Flash 进行推理,支持接入超过 100 种工具能力。
端侧完成语音识别与合成,云端负责复杂推理: 演示使用 0.6B 量级的 Qwen3-ASR 与 Qwen3-TTS,并采用 4-bit 量化配置,在 MacBook Pro M4 Pro 上执行语音转写与语音生成。DeepSeek V4.1 Flash 则通过 Ollama Cloud 提供语言理解、任务规划和工具调用能力。这种混合部署方式让语音前端留在本地,同时借助云端模型完成复杂任务。
支持自然轮次切换、语音打断与说话人识别: JOSIE-Voice 使用 Silero VAD 检测语音活动、Smart Turn v3 判断用户是否结束发言,并通过移植到 MLX 的 WeSpeaker 区分不同说话人。用户可以通过语音直接打断 AI 回复,也可以在语音通话与文字聊天之间切换,保留同一会话上下文。项目还支持选择 NVIDIA Parakeet、本地语音识别器及 Kokoro 等不同语音组件。
接入 100 多种工具能力,通过语音操作 macOS 应用: JOSIE-Voice 支持工具调用与 MCP 集成,可将自然语言请求转化为实际操作。项目文档列出的功能包括读取和创建日历事件、添加提醒、查询地图以及起草 Messages 消息等。开发者可以在系统设置中分别启用工具,并通过 macOS 权限机制控制应用访问;发送消息等敏感操作仍需用户确认。
JOSIE-Voice 使用 SwiftUI 与 MLX Swift 构建,面向 Apple Silicon Mac,支持本地 Ollama 模型及兼容 OpenAI API 的外部模型服务。目前开发者已公开项目介绍网站和演示资料,但 应用源代码仍未开源。此次展示属于个人开发者的实机演示,尚未公布独立测试的端到端延迟、工具调用成功率及不同硬件配置下的性能数据。
https://goekdeniz-guelmez.github.io/JOSIE-Voice/
4、法国 AI 实验室 Kyutai 开源 2.4B 机器人 VLA 模型 REKI:通过 32 个记忆 Token,将机械臂反复摇摆现象减少约 4 倍
法国 AI 研究实验室 Kyutai 联合 Inria、法国国立桥路学校发布并开源视觉-语言-动作模型(VLA)REKI,以 2.4B 参数实现机器人视觉理解、自然语言指令执行和动作生成。模型在动作生成模块中引入轻量级记忆机制,通过注册 Token(Register Tokens)保留最近几帧的环境信息,帮助机器人判断此前执行过的动作,减少机械臂在两个位置之间反复移动的问题。团队公布的 RoboTwin 测试显示,机器人动作来回摇摆的发生率从 18.6% 降至 4.1%。
32 个注册 Token 为动作模型加入短期记忆: REKI 基于 Qwen3.5-2B 视觉语言模型和约 200M 参数的流匹配(Flow Matching)动作生成模块构建。模型在动作生成模块中加入 32 个可学习的注册 Token,提取当前画面的环境信息,并通过 KV Cache 保留前两帧的特征。后续生成动作时可以直接读取历史信息,判断机械臂此前的位置和运动状态,无需反复编码历史画面,也不需要额外的记忆模型。
机械臂反复摇摆减少约 4 倍,记忆开销仅 0.1ms: 在 RoboTwin Clean 测试中,不具备历史记忆的模型容易在两个动作位置间反复切换,加入记忆后,这类现象的发生率从 18.6% 降至 4.1%。在单张 NVIDIA H100 GPU 上,模型根据两个 256×256 摄像头画面预测一组动作仅需 21.8ms,读取历史记忆额外增加约 0.1ms 延迟,每帧缓存约占用 2MiB 显存。
LIBERO-Plus 成功率达 90.4%,提升复杂环境下的动作泛化能力: REKI 在 LIBERO 基础任务中取得 97.6% 的平均成功率,在包含摄像头视角、机器人初始位置、光照、背景和物体布局变化的 LIBERO-Plus 测试中达到 90.4%。在 RoboTwin Clean2Rand 测试中,模型仅使用干净场景微调数据,就在随机扰动环境下取得 65.8% 的平均成功率;在 RoboCasa365 厨房操作任务中达到 38.4%。
仅使用公开数据预训练,开放模型权重与机器人部署代码: REKI 使用公开机器人遥操作、仿真、人类第一视角视频和视觉语言数据进行预训练,涵盖约 10 亿帧数据。项目提供基础预训练模型,以及针对 LIBERO、RoboTwin 和 RoboCasa 等任务微调的模型权重,同时开放推理、微调、评估和基于 LeRobot 的机器人部署接口,支持开发者针对自己的机器人继续训练。
目前 REKI 的模型权重已在 Hugging Face 开放,代码采用 MIT 许可证,模型权重采用 CC BY-NC-SA 4.0 许可证,不允许直接用于商业用途。官方仓库已提供微调和评估代码,完整预训练代码与数据处理流水线仍计划在后续更新中发布。
https://kyutai.org/reki/
02 有亮点的产品
1、OpenAI 硬件创作社区本周热门作品 Dream Logger:醒来对着设备讲述梦境,AI 自动生成四幅插画
OpenAI Developers 近期推出硬件创作展示平台 You Can Just Build Things,其中开发者 Fede Sarquis 制作的 Dream Logger(梦境记录器) 跻身本周点赞榜前列,位列第二。这个床头小设备可以在用户刚醒来时,通过语音记录容易遗忘的梦境,再调用 OpenAI 的语音识别与图像生成 API,将梦境转化为四幅连续插画,并保存到日历中,方便日后回顾。
语音记录梦境,自动生成四幕插画: 设备使用 M5Stack CoreS3 SE 开发板,通过内置麦克风录制语音,并调用 OpenAI 语音转写 API 获取文字内容。随后根据梦境的开头、发展、转折和结尾生成四张 1024×1024 插画,在触摸屏上浏览。
通过语音修改图片,保留梦境的细节: 如果生成的某张图片与实际梦境不符,用户可以重新录制一段语音描述需要修改的内容。设备通过 OpenAI 图像编辑 API 更新对应画面,无需重新生成整个故事。
独立联网运行,支持梦境日历: 设备搭载 ESP32-S3 芯片、320×240 触摸屏和 Wi-Fi,首次烧录程序后无需连接电脑即可运行。生成的插画和转写文本会先保存在设备本地,再同步至配套网站,按日期形成个人梦境日历,帮助用户回顾过去的梦境并发现重复出现的主题。
项目使用 Codex 辅助开发固件,基于 C++、Arduino ESP32、M5Unified 和 M5GFX 构建。语音识别与图像生成依赖云端 API,设备本身负责录音、显示、存储和网络通信。
https://x.com/i/status/2110414012903038993
2、OpenAI 展示黑客松硬件作品 Reflect:M5Stack CoreS3 接入 Realtime API,用实时语音控制智能灯光
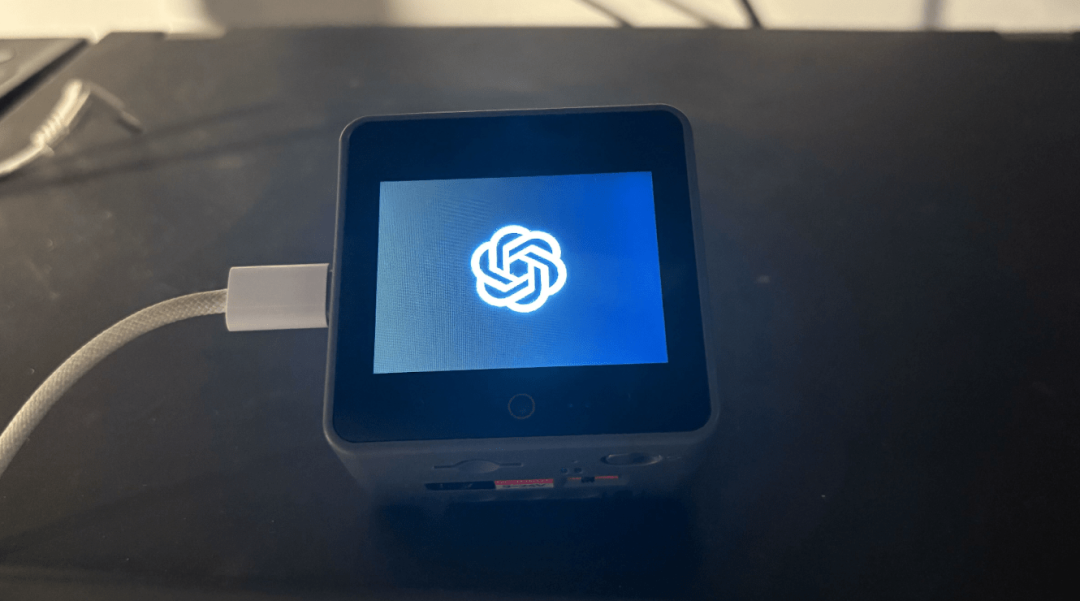
OpenAI 硬件创作平台 You Can Just Build Things 收录了黑客松作品 Reflect。这是一款基于 M5Stack CoreS3(ESP32-S3) 制作的实体 AI 语音助手,通过手机与 OpenAI Realtime API 建立语音会话,并利用函数调用控制 LIFX 智能灯的颜色、亮度和开关。项目尝试将 AI 的交互方式从屏幕上的文字回复,扩展为声音、灯光与色彩反馈。
通过手机连接 Realtime API,实现硬件语音交互: 根据项目展示页,设备可创建名为
reflect的 Wi-Fi 热点,用户使用手机连接后,访问本地网页192.168.4.1启动会话。项目使用 WebRTC 传输双向音频,并通过数据通道交换模型事件,让低成本微控制器也能接入实时语音模型。通过函数调用改变灯光状态: Reflect 接入 LIFX Color A19 智能灯,为 Realtime API 配置了开关控制和颜色调整两类函数。用户可以通过自然语言指定灯光氛围,例如暖色、日落、海洋或专注模式,系统将指令转换为具体的色相、饱和度、亮度和色温参数,再通过 LIFX 局域网协议执行。
开放 ESP32-S3 固件,供开发者改造: 项目基于 ESP-IDF 开发,公开了音频采集与播放、WebRTC 连接、Realtime API 事件处理和 LIFX 设备控制等代码。开发者可以从现有实现出发,尝试为语音助手加入其他物联网设备或交互方式。
Reflect 是 2025 年 OpenAI 黑客松期间开发的实验性作品,并非近期新发布的商用硬件。项目仓库采用 MIT 许可证,目前公开代码与展示页在网络连接和 API 密钥配置方式上存在差异,复现时需要核对具体固件版本。官方也明确提示该演示项目尚未经过完整的安全性、稳定性和生产适用性验证。
https://github.com/openai/openai-reflect
3、柔性传感器厂商 UDEXREAL 推出触控 AI 陪伴机器人 NiniQuu:7 个传感器识别触摸,全离线运行,无需语音和联网
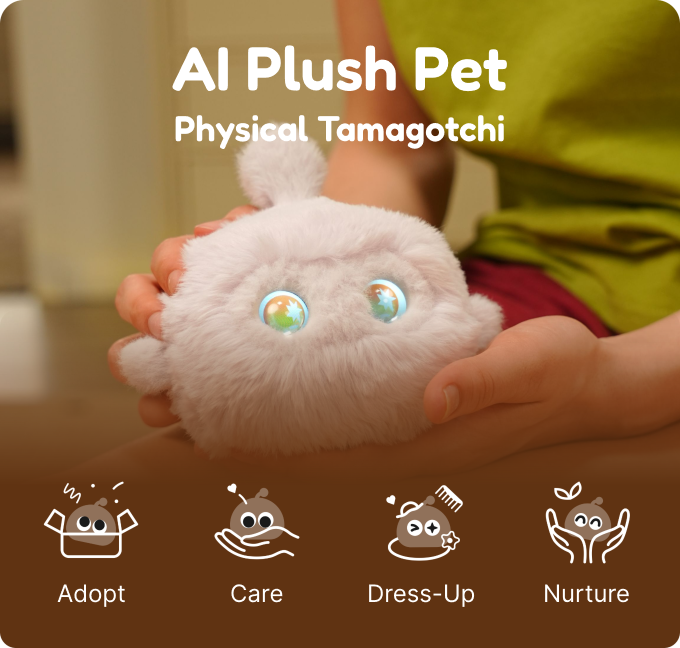
柔性传感器及 XR 设备厂商 UDEXREAL(宇叠智能) 在 Kickstarter 上推出毛绒 AI 陪伴产品 NiniQuu,将此前用于 VR 数据手套的柔性传感技术应用于情感陪伴场景。与依赖语音大模型的 AI 陪伴设备不同,NiniQuu 没有摄像头、麦克风、Wi-Fi 和蓝牙,也无需手机 App。用户只需通过挤压、抚摸、轻敲或摇晃设备,就能触发眼部表情、拟声音效和振动反馈。
7 个柔性传感器识别不同触摸动作: NiniQuu 在太阳穴、脸颊、下巴及后脑等位置部署了 7 个可拉伸传感器,用于感知触摸位置、按压力度和持续时间,并通过运动传感器识别抬起、摇晃及抛掷等动作。这套方案源于 UDEXREAL 的柔性传感技术,此前已应用于 UDCAP VR 数据手套,可在柔软表面感知压力及形变。
本地行为系统提供 300 多种互动反馈: 设备根据用户的触摸动作和内部情绪状态,从超过 300 种眼部表情、声音与振动组合中选择反馈。NiniQuu 每次启动时会随机进入开心、平静或低落三种初始情绪,同样的触摸动作可能触发不同反应。官方还表示,设备能够在长期使用中学习用户的触摸习惯,逐步解锁新的互动方式,相关数据全部保存在本地。
不使用语音大模型,主打无网络的实体交互: NiniQuu 不具备语音对话功能,也没有聊天机器人或大语言模型,交互主要由本地触摸识别和行为系统驱动。设备重约 110 克,采用柔软泡棉与毛绒外壳,支持 USB-C 充电,官方标称连续使用续航最长约 6 小时。
NiniQuu 已于 10 月 15 日开启 Kickstarter 众筹,提供 Mochi、Pom-pom、Plume 和 Starlight 四种外观,标准众筹价格为 159 美元,部分早鸟档位为 139 美元,预计于 2027 年 1 月开始发货。
https://niniquu.com/
03 有态度的观点
1、Tibo 回应 Codex 用户许愿:五项建议中有两项正在做
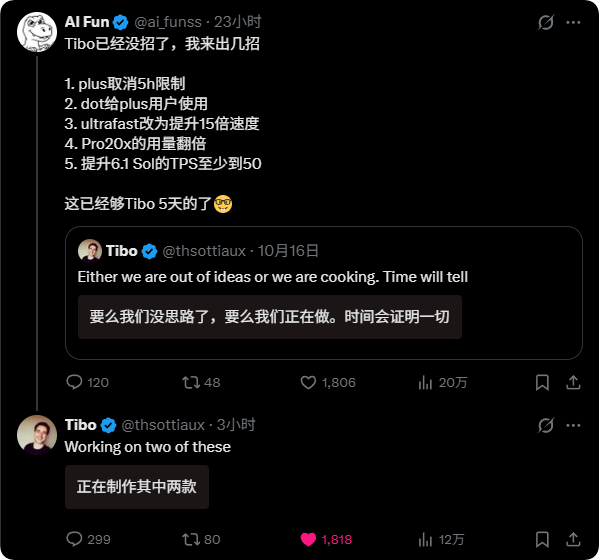
10 月 17 日,OpenAI 的 Codex 与 ChatGPT 团队成员 Tibo Sottiaux 在 X 上回应一份用户许愿清单,称团队「正在做其中两项」。这份清单由用户 AI Fun 提出,具体希望:
取消 Plus 的 5 小时用量限制;
向 Plus 用户开放 dot;
将 ultrafast 的加速幅度提高到 15 倍;
将 Pro 20x 的用量翻倍;
将 GPT-6.1 Sol 的输出速度提高到至少每秒 50 个 token。
在近期更新中,他还介绍了 Codex 与 Work 提高实际可用额度的做法:在子智能体之间复用上下文、延长上下文缓存时间,并通过优化请求路由提高缓存命中率。另一项已公布的变化是 ChatGPT Space 增加幻灯片支持,先面向 Pro、Business 和 Enterprise 用户开放。
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、如果今年只参加一场实时交互模型和 Voice Agent 大会,来 iRTE2026 实时智能大会就够了
在这里,Kimi、MiniMax、阶跃星辰、面壁智能、模思智能、生数科技等国内领先大模型公司将带来最前沿的 AI 产品 / 技术分享,话题覆盖多模态模型、Voice Agent、AI 硬件、具身智能、实时基础设施等。
还有美团、阿里 ATH、Rokid、斜跃智能、博通集成、Soul、HOLLA、EF 英孚、伴鱼等企业分享 Voice Agent 在客服、硬件、具身智能、社交、教育等行业场景的落地。现场更有丰富的开发者工作坊,手搓各类 Voice Agent 应用与硬件。
10 月 23-24 日,来 iRTE 大会现场,与国内外一线的 AI 产品 / 技术专家深度交流,掌握 RTE、Voice Agent、实时多模态的最新动向与技术实践,把握 2026 Voice Agent 技术风向标。欢迎关注公众号和添加小助手微信 Creators2022 进大会交流群获取直播提醒。
大会官网:shengwang.cn/rteconf
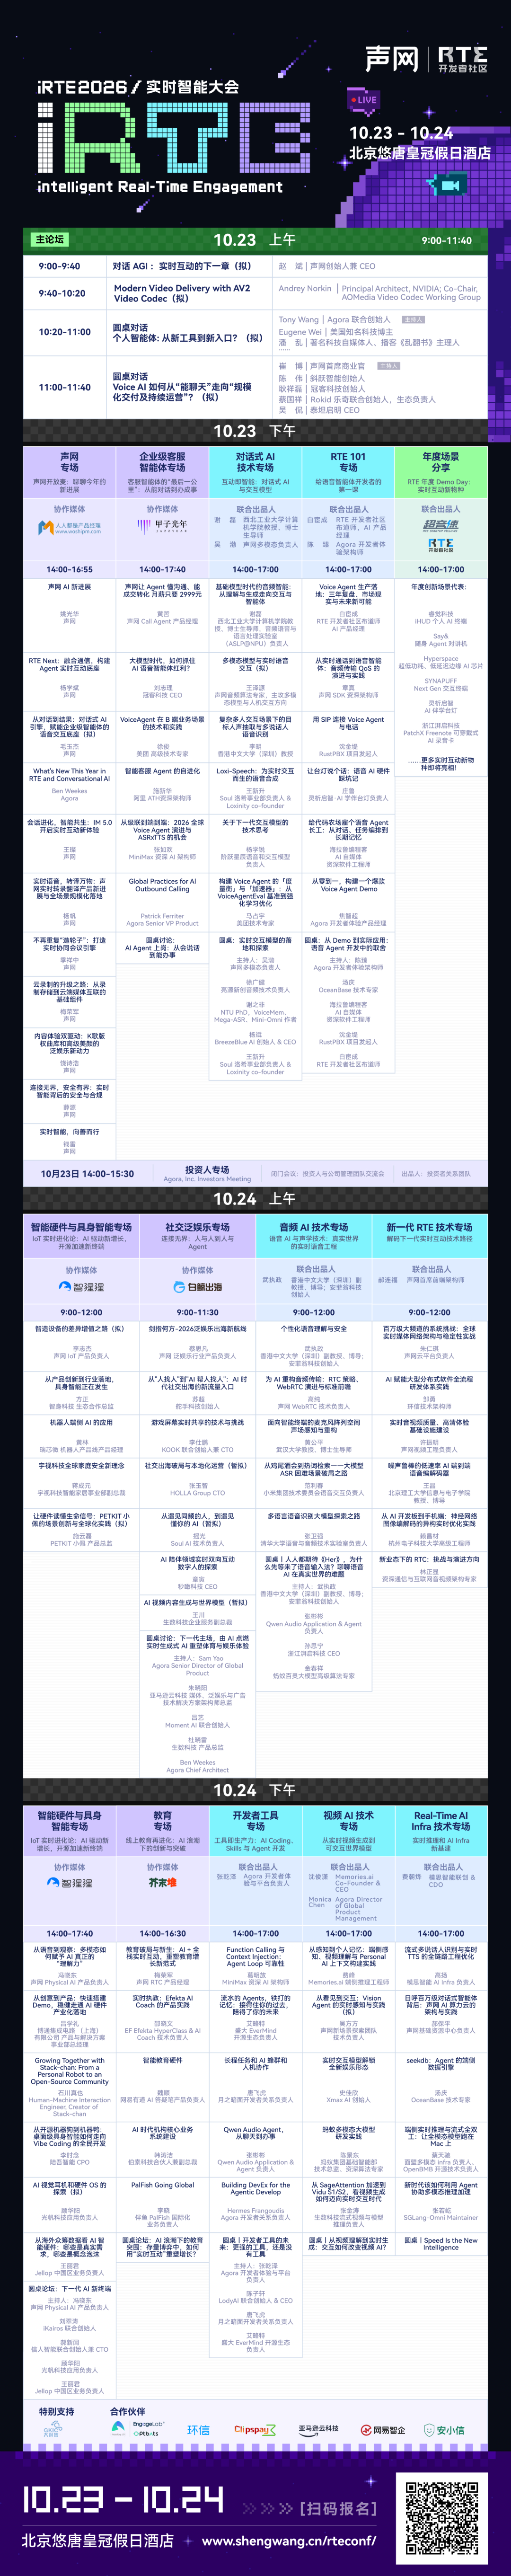
大会全议程如下:
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考