AI 智能眼镜公司 Mira 发布音频动作模型 Thud:不经 ASR 直出操作丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、韩国互联网公司 Kakao 展示全双工语音技术 Kanana Live:支持边听边说、端云模型智能调度,Kanana-o 编解码器计划开源
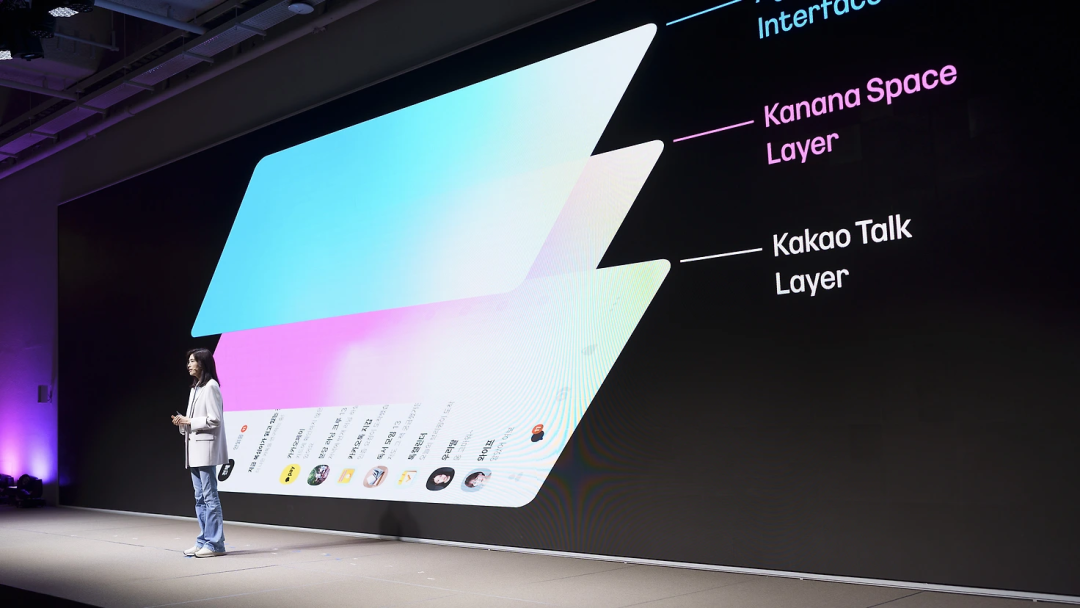
韩国互联网公司 Kakao 在年度开发者大会 if(kakao)26 上公布自研 AI 模型 Kanana 的最新技术进展,包括支持全双工语音交互的 Kanana Live、负责协调端侧与云端模型的 AI Conductor,以及多模态模型 Kanana-o 的开源计划。Kakao 希望将语音、视觉理解和工具执行整合到统一的智能体系统中,让 AI 能够持续理解用户意图,并根据任务复杂度选择合适的模型完成操作。
Kanana Live 支持边听边说的全双工语音交互: Kakao 展示了 Kanana Live 的开发成果,使 AI 能够同时接收用户语音并生成语音回应,支持更自然的双向交流。此前推出的 Kanana-o 已具备文本、图像和音频联合理解及语音生成能力,此次进一步展示了面向持续实时对话的全双工技术。目前官方尚未披露 Kanana Live 的具体延迟指标及独立开放时间。
AI Conductor 根据任务复杂度调度端侧与云端模型: Kakao 提出端云协同架构,将简单请求交给智能手机上的轻量级模型处理,复杂推理任务则调用云端大模型。AI Conductor 负责理解用户请求,选择适合的模型、工具及执行顺序,以减少不必要的云端计算开销。Kakao 还结合自研分词器及模型推理优化技术,提升整体运行效率。
Kanana-o 自研编解码器计划开源: Kanana-o 是 Kakao 自研的多模态语言模型,可同时理解文本、图像和音频,并生成文本与语音回应。Kakao 表示,模型所使用的多种编码器和解码器均由团队自主研发,计划向开发者开源,供其他多模态 AI 系统使用。目前尚未公布具体开源日期及许可协议。
配套 AI 助手 Kanana Space 将于 12 月开展封闭测试: Kakao 同期展示了集成于 KakaoTalk 的智能体服务 Kanana Space。用户可通过语音或文字请求发送消息、管理日程、搜索网页及修改应用设置。未来还计划支持购物、预订、送礼及支付等操作。Kanana Space 已开放测试申请,将从报名用户中选取部分人员参与 12 月的封闭测试。
https://www.kakaocorp.com/page/detail/12160
2、语音智能体评测公司 Veris AI 测试 14 套 Voice Agent:电视背景人声使任务完成率从 38.7% 跌至 8.6%
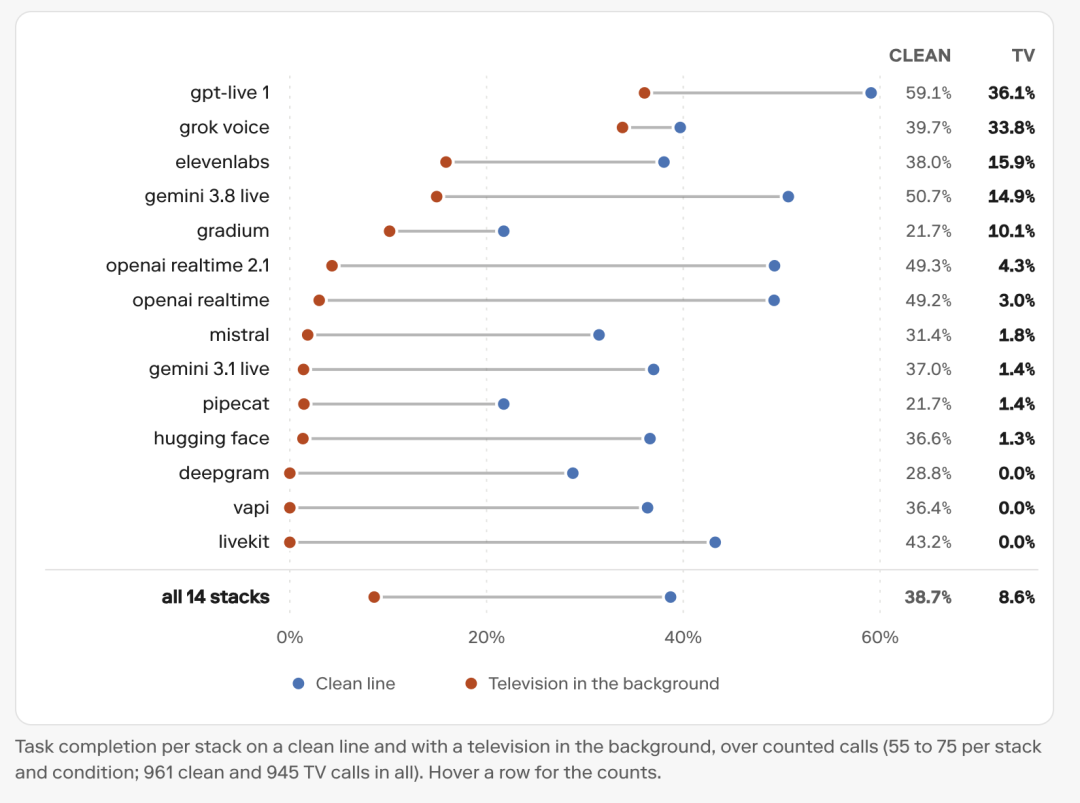
语音智能体评测公司 Veris AI 公布 VAmoS Pro Bench 的最新测试结果:当通话环境中出现电视背景人声时,14 套语音智能体系统的整体任务完成率从安静环境下的 38.7% 降至 8.6%。测试发现,电视中的清晰人声容易被误识别为真实用户指令,导致智能体错误回应、频繁中断语音输出,甚至无法完成用户身份验证。
14 套语音系统中,9 套完成率不足 5%: 测试让 14 套语音智能体系统执行相同的 100 项公共事业账单客服任务,每项重复 3 次,并混入街道噪声、咖啡馆交谈声和电视新闻人声。在相同背景音量下,街道噪声环境的任务完成率为 41.4%,咖啡馆人声为 27.4%,电视背景人声则降至 8.6%。其中 9 套系统的完成率不足 5%,3 套完全无法完成任务。表现相对较好的 GPT-Live-1 和 Grok Voice 分别达到 36.1% 和 33.8%。
电视人声会被错误转录为用户指令: 在有可用转录日志的测试通话中,90% 的电视背景通话出现至少 10 个用户从未说过的额外识别词,而安静环境下这一比例仅为 2%。部分智能体会直接回答电视节目中的内容,导致真实用户的请求被忽略。
背景人声干扰轮次检测,导致 AI 频繁中断: 电视声音还会触发语音活动检测(VAD),使智能体误以为用户正在插话。在电视背景下,智能体 36% 的语音输出被中途打断,安静环境下为 9%;单次通话平均语音输出片段也从 8.5 次增至约 15 次。用户身份验证成功率则从 81.3% 降至 52.5%,转人工比例从 4.4% 升至 8.1%。
本次测试使用模拟来电者及单段电视新闻音频,部分语音系统未启用降噪功能,结果不能直接代表各模型在所有真实环境下的表现。Veris AI 已公开 14 套语音系统的测试实现与配置,供开发者复现和比较。
https://veris.ai/blog/vamos-pro-findings-tv-in-the-room
3、AI 智能眼镜公司 Mira 发布音频动作模型 Thud:无需语音转写直接执行操作,延迟仅 107.6ms,速度达 Gemini Live 的 9.2 倍
AI 智能眼镜公司 Mira 发布音频动作模型 Thud,能够直接根据输入音频选择并执行操作,无需先经过 ASR 转写或调用大语言模型生成文本。在 Mira 智能眼镜的演示中,用户只需说出指令,即可打开应用、导航菜单、发送消息。根据团队内部测试,Thud 的中位延迟为 107.6ms,约为 Gemini Live 的 1/9.2,每千次请求的估算成本降低约 20 倍。
从音频直接映射到操作指令: Thud 将语音输入转化为对候选动作的分类与选择,例如打开指定应用、点击菜单项或发送消息。模型直接分析音频信号,无需中间的语音转文字环节,并为每个候选操作输出置信度。开发者可以像修改提示词一样调整可选动作类别,模型的输出限制在预设类别内,避免生成无法执行的操作。
本地推理中位延迟 107.6ms,成本约为 Gemini Live 的 1/20: Mira 公布的内部测试显示,Thud 的中位延迟为 107.6ms,每千次请求估算成本为 0.098 美元;Qwen ASR + Jev 串联方案分别为 383.8ms 和 0.190 美元,Gemini Live 则为 985.1ms 和 1.92–2.39 美元。Thud 可以直接在手机本地运行,减少云端模型调用带来的延迟和成本。上述对比由 Mira 团队自行测试,尚未公布完整的独立评测条件。
从语音操作扩展至环境声音感知与智能体调度: 除了控制眼镜和手机应用,Thud 还能根据语音内容、说话方式及周围声音判断用户是否正在向助手发出指令,并决定是否回应。团队还展示了根据语音请求选择 Claude Code、ChatGPT 等不同智能体,以及识别水龙头漏水、门铃和救护车警笛等环境声音并触发提醒的功能。
目前 Thud 已完成 Mira 智能眼镜和手机应用的交互演示,尚未开放公共 API,团队计划将其集成至 Mira 智能眼镜产品中。
https://trymira.com/blog/meet-thud
4、端侧语音 AI 团队 FluidVoice 开放语音识别模型 Fluid Speech Mini:仅 253MB,背景人声干扰下识别错误率降低 47%
语音听写应用开发团队 FluidVoice Labs 发布开放权重语音识别模型 Fluid Speech Mini,基于 NVIDIA Parakeet v3 和 Moondream Parakeet Ultra,通过知识蒸馏与低比特量化训练,将模型压缩至 253MB。在 8 个公开英语语音识别测试集上,模型平均词错误率(WER)为 4.54%,与体积为 1.26GB 的 Parakeet Ultra(4.56%)基本持平,并针对多人说话环境优化,可在 iPhone、Mac、Windows 和 Linux 设备上离线运行。
253MB 模型达到 Parakeet Ultra 级别的识别精度: 在 Open ASR Leaderboard 的 8 个公开英语测试集上,Fluid Speech Mini 的平均 WER 为 4.54%,低于 Parakeet v3 的 4.86%,与 Parakeet Ultra 的 4.56% 接近。模型在 Apple Core ML 格式下占用约 277MB 运行内存。这些结果来自 FluidVoice 使用公开评测代码进行的内部测试,并非排行榜官方提交成绩。
针对背景人声优化,识别错误率降低 47%: 在 Google SVQ 英语背景人声测试中,Fluid Speech Mini 的 WER 为 10.9%,相比 Parakeet v3 的 20.4% 降低约 47%。团队先结合 Parakeet v3 与 Parakeet Ultra 训练教师模型,再让学生模型从带有噪声、混响和其他说话人声音的音频中学习恢复正确文本。模型从训练开始就采用约 3 比特权重精度,完整训练可在单张 RTX 5090 上完成。
提供三种部署格式,支持完全离线转录: 官方开放 Core ML(253MB)、ONNX(302MB) 和 GGUF(347MB) 三种版本,分别面向苹果设备、Windows/Linux 及 C++ 应用。Core ML 版本可利用 Apple Neural Engine 加速;在 Apple M5 Max 的官方测试中,模型加载完成后处理 60 秒音频耗时约 144ms。所有版本均可在本地运行,无需将语音上传至云端。
Fluid Speech Mini 已在 Hugging Face 以 CC BY 4.0 许可证开放权重,并集成至 FluidVoice 听写应用。目前模型仅针对英语训练和评测,iPhone 端仍处于 TestFlight 测试阶段,团队计划后续推出更小的模型及多语言版本。
https://x.com/FluidVoiceApp/status/2110060621886816593
02 有亮点的产品
1、苹果发布 AI 智能家居中枢 HomeView:Siri AI 支持自然语音对话、跨应用操作,可识别 6 位家庭成员
苹果正式发布首款智能家居中枢 Apple HomeView,搭载全新 Siri AI,将自然语音对话、个人上下文理解和智能家居控制整合到一台家庭共享设备中。HomeView 配备 7 英寸 Liquid Retina 显示屏与 A18 芯片,支持通过语音查询信息、操作应用及管理家居设备。苹果同期推出支持 Siri AI 的 HomePod mini 2 和新款 Apple TV 4K,将升级后的语音助手扩展至家庭音箱与电视。
Siri AI 支持连续对话与跨应用任务执行: 新版 Siri 基于 Apple Intelligence,具备更强的自然语言理解、屏幕内容感知和多轮对话能力。当 HomeView 与支持 Apple Intelligence 的 iPhone 或 iPad 配对后,Siri 可以结合 Messages、Calendar、Apple Music 等应用中的个人上下文回答问题,并执行跨应用操作。例如,根据聊天记录查找朋友推荐的音乐,或结合日历信息创建提醒。对话历史还可通过 iCloud 在 iPhone、iPad、Mac、Apple Watch 和 Apple Vision Pro 之间同步,用户能够在不同设备上继续此前的对话。
识别最多 6 位家庭成员,提供个性化语音服务: HomeView 通过面部识别区分家庭成员,自动切换对应的桌面、应用和个人信息。系统可根据用户距离调整屏幕内容的呈现方式;访问 Messages、Calendar 等个人内容时,还需确认用户身份及其配对设备状态。Siri 请求可通过端侧模型或 Private Cloud Compute 处理,摄像头和麦克风数据则由 A18 芯片中的 Secure Exclaves 隔离保护。
语音控制扩展至家庭环境感知与设备操作: 用户可以直接通过 Siri 调整灯光、恒温器、门锁和窗帘,并查看最多 9 路摄像头实时画面。结合兼容摄像头和 iCloud+,系统能够识别人、宠物、包裹及车辆,为监控视频自动生成文字描述,并支持通过自然语言检索录像。HomeView 还具备烟雾和一氧化碳报警声识别能力,可在检测到异常声音后向用户设备发送提醒。
HomePod mini 2 与 Apple TV 4K 同步接入 Siri AI: HomePod mini 2 将通过后续软件更新获得 Siri AI,支持识别最多 6 位家庭成员的声音,并结合个人上下文执行任务。新款 Apple TV 4K 内置 3 个远场麦克风,结合回声消除技术,用户无需遥控器即可直接与 Siri 交流,即使电视正在播放声音,也能进行语音唤醒、内容搜索和智能家居控制。
HomeView 标准版与壁挂版均定价 299 美元,已在美国、英国等首批市场开放预购,11 月 13 日正式发售。目前 Siri AI 在 HomeView 上支持英语,苹果尚未公布中文版本的上线时间。
https://www.apple.com/newsroom/2026/10/meet-apple-homeview-a-new-way-to-enjoy-entertainment-and-manage-the-home/
2、阿里千问发布 AI 眼镜 N1/N1 Pro 与 Bose 联名 AI 耳机:支持眼动翻译、虹膜支付及语音交办任务,三款设备正式开售
阿里巴巴千问正式发布 AI 眼镜 N1、N1 Pro 及与 Bose 联合打造的 AI 耳夹式耳机,将个人智能体(Personal Agent)的实时语音交互、多模态感知和任务执行能力扩展至可穿戴设备。用户可通过语音、视线与环境感知信息向 AI 发出请求,并由千问在后台执行任务、主动反馈结果。三款产品此前已在云栖大会亮相,此次正式现货开售。
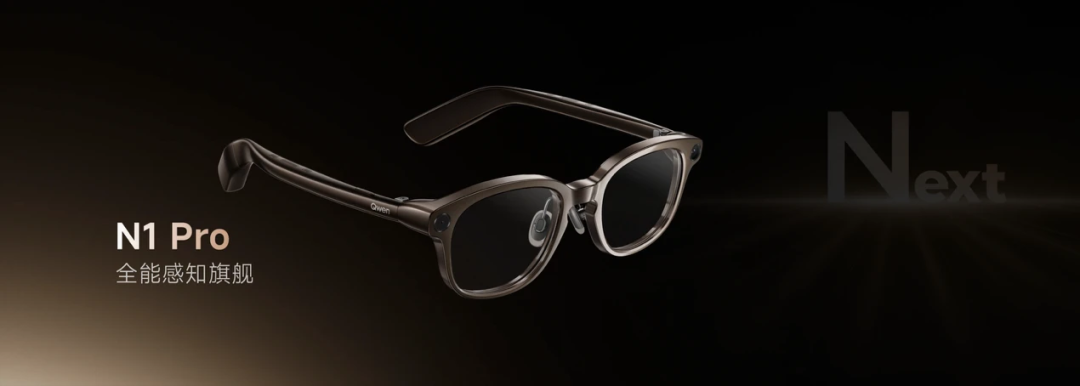
N1 Pro 支持眼动交互与实时语音翻译: N1 系列搭载 5000 万像素影像系统、低功耗感知芯片和端侧视觉理解模型,支持第一视角拍摄、环境感知和语音办事。N1 Pro 新增眼动追踪功能,能够结合用户视线判断关注对象。例如,用户看着外文菜单询问“这一项是什么”,眼镜即可定位对应内容,并通过语音提供翻译。开启相应功能后,设备还可根据环境信息主动提供出行提醒。
虹膜识别与支付宝集成,实现“看一下支付”: N1 Pro 与蚂蚁集团 GPASS 合作引入虹膜核身能力。用户发起支付后,看向商家收款码,确认付款信息并点头,即可通过虹膜身份核验完成支付。官方公布的虹膜核身误识率低于 百万分之一。N1 Pro 还支持心率、血氧和皮肤温度实时监测,并根据体征变化提供提醒。
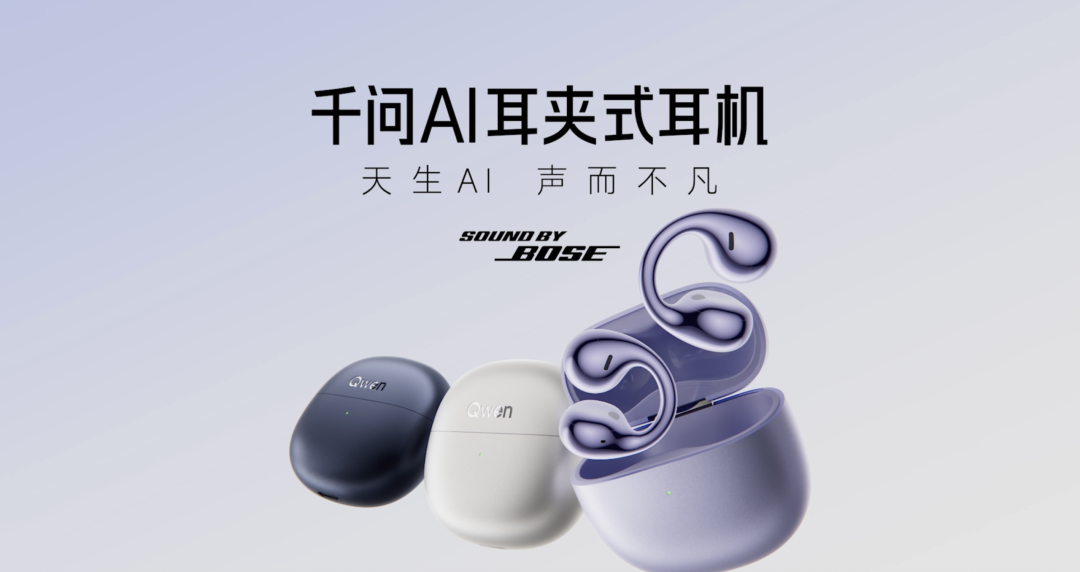
Bose 联名 AI 耳机支持 89 种语言翻译与实时听记: 千问 AI 耳夹式耳机采用开放式设计,支持 89 种语言实时翻译、多语言语音转写和会议纪要生成。用户可通过语音唤醒智能体,直接交办资料检索、报告生成等任务。例如,在通勤途中要求 AI 整理一场产品发布会的亮点,系统会在后台执行,并在完成后主动提醒。耳机还支持定时任务,可按指定时间整理行业动态并播报简报。
三款产品已在淘宝、天猫、京东和抖音等平台开售。叠加国家补贴及限时优惠后,N1 售价 2218 元起、N1 Pro 售价 2600 元起、AI 耳机售价 1099 元起。
(@千问 APP)
3、安克创新联合飞书推出 AI 会议耳机:支持跨平台录音、实时转写与翻译,会议纪要自动同步至飞书
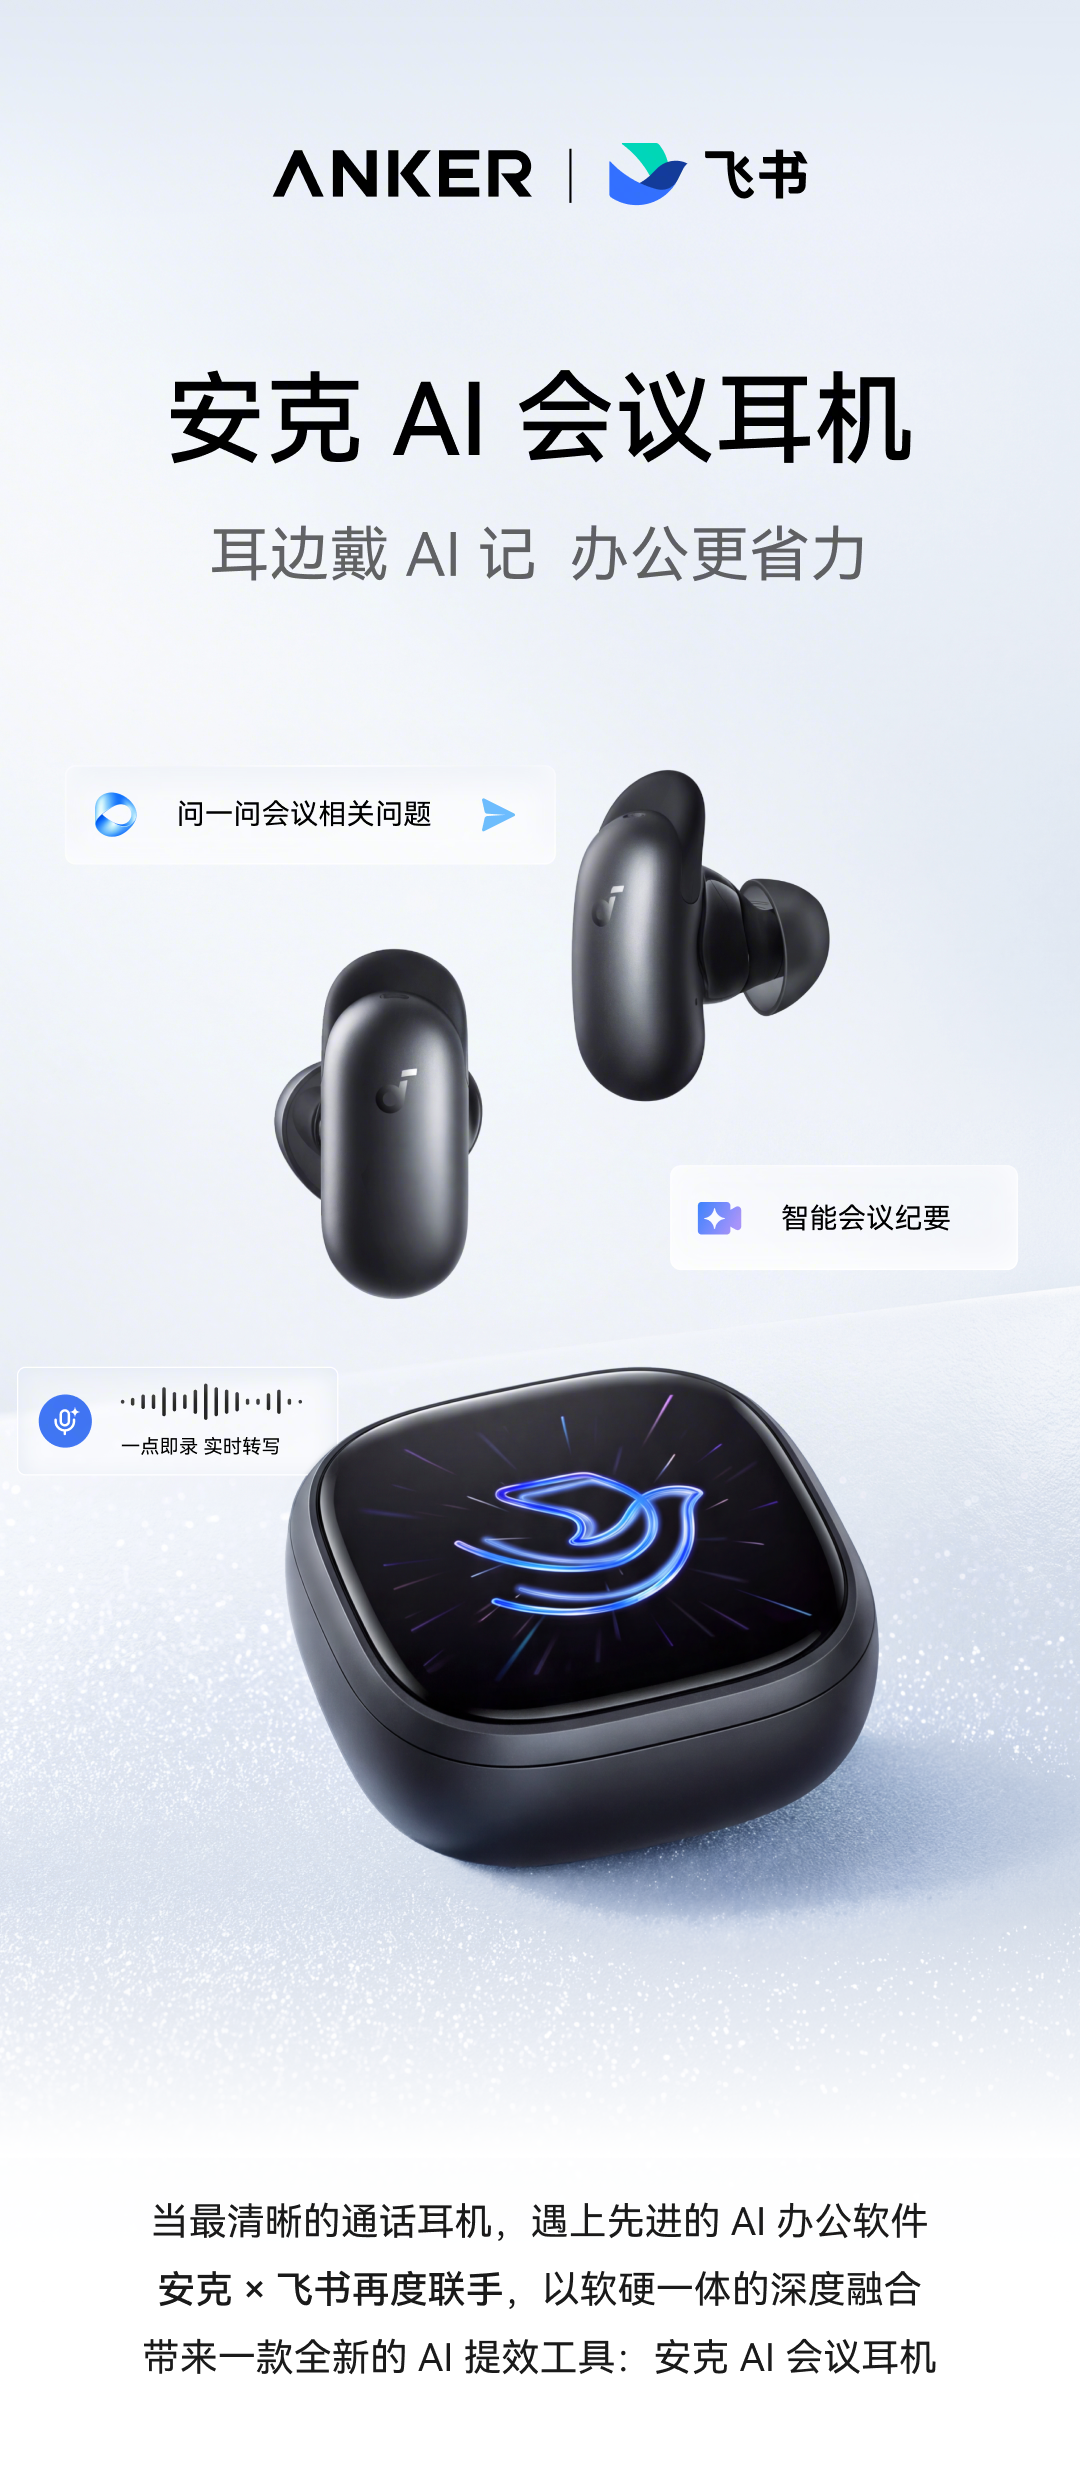
安克创新(Anker)联合飞书正式推出 安克 AI 会议耳机飞书版,将语音录制、实时转写、翻译和 AI 会议纪要整合到耳机与充电盒中。产品支持线上会议、电话通话和线下面对面交流,录音及转写内容可直接同步至飞书妙记,自动提取会议结论、待办事项和关键决策,无需手动导入录音文件。
耳机与充电盒双端录音,覆盖线上线下会议: 线上通话时,用户双击耳机即可启动录音,支持飞书、钉钉、腾讯会议、Microsoft Teams 和 Zoom 等主流会议平台。线下交流时,无需佩戴耳机,可直接使用充电盒内置麦克风录音。设备支持断网录音和本地存储,联网后再同步至飞书进行处理。
实时转写与 AI 纪要自动生成: 耳机深度集成飞书妙记,支持边录音边生成文字记录和 AI 总结,识别不同发言人,并处理中文、英语、日语混合语音。系统支持 24 种语言实时翻译,会后可自动生成包含关键议题、结论、待办事项及图表的结构化会议纪要,录音内容还可沉淀至飞书知识库,供后续问答、检索和分析使用。
自研 AI 芯片实现端侧实时人声降噪: 耳机搭载 Anker Thus AI 音频芯片,采用神经网络存算一体设计,官方称其 AI 峰值算力较上一代最高提升 150 倍。配合 8 颗 MEMS 麦克风与 2 颗骨传导麦克风,可在设备端实时分离人声与环境噪声,改善嘈杂环境下的通话与录音质量。端侧处理主要用于音频降噪,AI 转写和纪要生成仍依赖飞书服务。
安克 AI 会议耳机飞书版已于 10 月 12 日正式开售,售价 1799 元。产品配备 1.78 英寸触控屏充电盒,支持直接控制录音、降噪和音效等功能。
(@飞书)
4、语音 AI 公司 Fish Audio 完成 5200 万美元种子轮融资,发布语音合成模型 Drama 3:支持单词级情绪控制、句中语气切换,发音稳健性达 93.2%
语音 AI 公司 Fish Audio 正式发布新一代语音合成模型 Drama 3,相较此前的 S2.1 Pro,重点提升语音情感表现力、自然语言指令遵循能力和发音准确率。开发者可以直接用文字描述希望呈现的情绪、语气和说话方式,甚至对一句话中的特定单词进行独立控制。模型支持 83 种语言,已通过网页、移动应用和 API 开放使用,同时提供可自行部署的开放权重。
支持单词级控制与句中情绪切换: Drama 3 允许开发者在文本中插入自然语言指令,控制声音的哭腔、低语、愤怒、笑声、停顿等表现。例如,同一句台词可以从急促的语气逐渐转为恐惧的低语,并通过
<emphasis>标签单独强调指定单词。模型还支持在一段文本中使用最多 16 个说话人标记,生成多角色对话。发音稳健性达到 93.2%,领先上一代模型: 在 Artificial Analysis 的英语发音稳健性评测中,Drama 3 以 93.2% 的准确率排名第一,高于 S2.1 Pro 的 88.1%。其中,品牌名、地名和专业术语的正确发音率从 87.3% 提升至 95.9%,代码、文件路径和电子邮件等精确序列的正确率从 79.4% 提升至 86.3%。
采用 35B-A3B 混合专家架构,支持流式生成: Drama 3 基于 Qwen3.5-35B-A3B 初始化,采用混合注意力架构和新的 Codebook-MTP 音频解码器,在保留长文本上下文的同时生成语音细节。训练阶段还引入基于人类偏好的强化学习,改善情绪表达与指令遵循。在单张 NVIDIA H200 GPU、单并发且参考语音已编码的测试条件下,模型首段音频延迟(TTFA)中位数为 88.9ms。
开放模型权重,计划支持局部语音重新生成: Drama 3 已在 Hugging Face 开放权重,并支持通过 SGLang-Omni 本地部署。模型还展示了音频补全(Audio Inpainting)能力,允许创作者只修改一句话中的某个单词,同时保留其他部分的音色、情绪和节奏。不过,交互式编辑和音频补全工具目前仍处于小范围邀请测试阶段,编辑 API 尚未正式开放。
Drama 3 采用 Fish Audio Community License v1.0,研究和非商业用途免费,年收入低于 50 万美元的企业可在许可条件下免费商用,其他商业用途需另行授权。Fish Audio 此前于 7 月宣布完成 5200 万美元种子轮融资,此次发布时公司称平台用户已超过 1500 万。
https://fish.audio/zh-CN/blog/fish-audio-drama-3/
03 有态度的观点
1、Alexandr Wang:扎克伯格写得又快又严密,也对时间极其挑剔
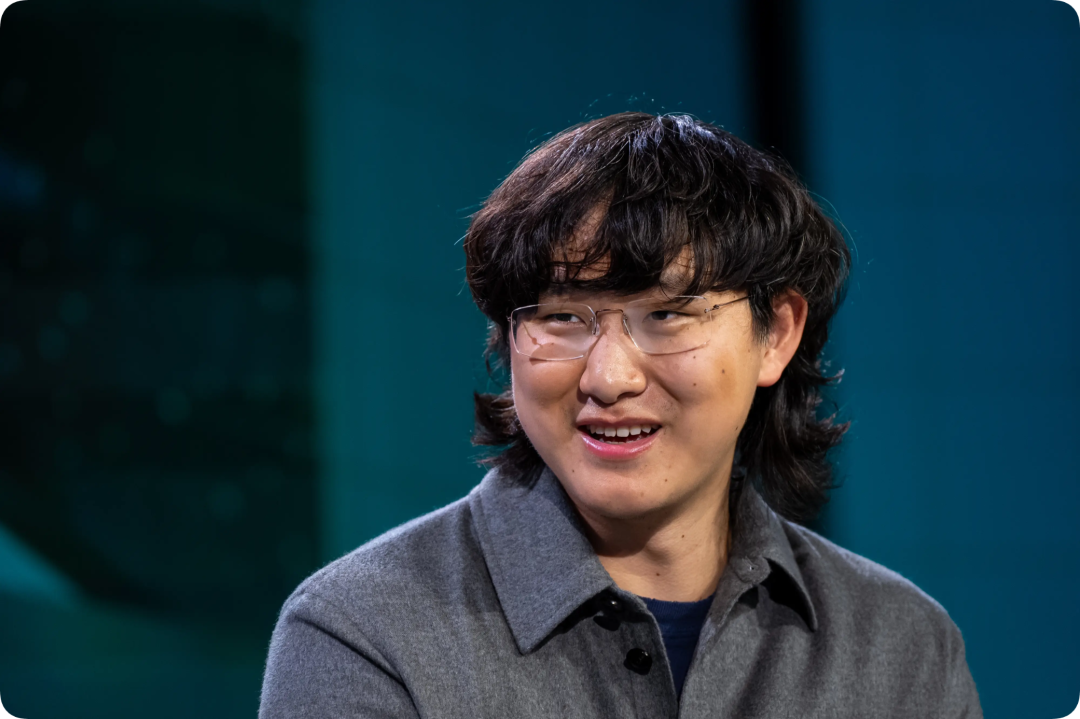
Meta 首席 AI 官 Alexandr Wang 在 David Senra 的采访中回忆,加入 Meta 前,他偶尔会通过 WhatsApp 向扎克伯格请教,总能收到出乎意料的长回复。
他曾困惑:一个日程如此紧的人,怎么有空写这么多?后来,他发现扎克伯格写作的速度很快,长回复仍保持严密的逻辑。这是令他印象深刻的一项能力。
Wang 说,自己经人介绍认识扎克伯格后,第一次会面花了约一年才排进日程;扎克伯格会把大量时间留给最重要的事情。想同时做到这些,又当好父亲、当好伴侣,他唯一的办法就是极其严格地确定优先级。Wang 也回忆,两人原本约每半年交流一次。
Llama 4 未达到 Meta 的预期后,扎克伯格主动打电话,问他应该做什么、把 AI 战略的重点放在哪里。对一位已经长期执掌大公司的创始人,他仍愿意持续向其他创业者求教,这一点也让他印象深刻。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考