腾讯混元开源同传模型 Hy-SimulMT:中英实时互译丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、腾讯混元开源 Hy-SimulMT 同声传译模型:30B-A3B 支持中英双向实时翻译,约 3 秒流式延迟与跨语言音色克隆
腾讯混元正式发布并开源同声传译大模型 Hy-SimulMT,支持中文与英语之间的双向实时语音翻译。模型能够持续接收说话人的音频,边听边生成译文,并通过语音合成将翻译结果实时播报,同时支持克隆原说话人的音色。官方在长音频评测中公布的平均流式翻译延迟约为 3 秒。该模型已在腾讯 Hy 翻译 App 首发,用户可免费体验。
30B-A3B 模型支持边听边译,无需等待整段讲话结束: Hy-SimulMT 采用总参数量约 30B、激活参数量约 3B 的架构,能够随着输入音频持续到达,逐步生成目标语言译文。官方提供两种输出版本:标准版直接生成翻译文本,Interleave 版本则同时输出源语言文本和目标语言译文,方便开发者构建实时双语字幕、会议翻译和演讲同传应用。
约 3 秒流式翻译延迟,质量超过多数参评商业 API: 在长音频同声传译评测集 RealSI 上,Hy-SimulMT 的 StreamLAAL 约为 3 秒,是此次对比系统中的最低值;翻译质量得分超过所有参评开源模型,以及五款商业 API 中的四款。在短音频测试中,模型在 RealSI-Sentence 上获得 84.7 分,为参评系统最高分。StreamLAAL 衡量的是流式翻译相对原始语音的滞后程度,并非第一段合成语音的出声时间。
支持实时音色克隆,译文可以保留说话人的声音特征: Hy-SimulMT 可以配合 TTS 服务,将中文语音翻译成英文语音,或将英文语音翻译成中文语音,并根据输入音频克隆说话人的音色。官方展示了包含三位不同说话人的英译中演示,译后语音能够体现不同人物的声音特征。开源的 Hy-SimulMT 权重主要负责翻译,语音输出和音色克隆需要额外配置 TTS 模型;官方推理方案提供了接入 Qwen3-TTS 0.6B 的示例。
开放模型、训练和推理工具: 提供 BF16、FP8、GGUF 权重,以及 SimulInfer、SimulTrain 工具,支持 WebSocket 实时输入和本地部署。语音输出及音色克隆需要另外配置 TTS 服务,官方提供 Qwen3-TTS 接入示例。
https://github.com/Tencent-Hunyuan/Hy-SimulMT
2、华盛顿大学开源语音智能体框架 ConvFill:0.6B 小模型先开口、大模型后台思考,工具调用场景首句响应提速 19.1 倍
华盛顿大学 UbiComp Lab 研究团队提出语音智能体框架 ConvFill,通过小型 Talker 和大型 Reasoner 协作,解决语音 Agent 在响应速度与复杂推理能力之间的取舍。用户说完话后,小模型先生成自然的对话回应,同时让大模型在后台完成推理、检索或工具调用;当大模型返回信息时,小模型再将其融入后续回答。研究团队已开源模型、训练代码和数据集,Hugging Face 团队也上线了可直接体验的语音对话 Demo。
0.6B Talker 负责即时对话,大模型负责复杂推理: ConvFill 将对话任务拆分为两个角色。Talker 是运行在本地的小语言模型,负责快速生成自然语言回应;Reasoner 可以使用 Claude、GPT 或 Gemini 等大型模型,在后台处理知识检索、多步推理和工具调用。Hugging Face 最新演示采用 Qwen3-0.6B 作为 Talker。研究团队还训练了 SmolLM、Gemma、Llama 和 Qwen 系列共 7 款小模型,参数规模覆盖 135M–1.7B。
用对话填充机制隐藏等待时间,答案来了再继续说: ConvFill 提出对话填充机制。系统将用户语音转写为文本后,同时发送给 Talker 和 Reasoner。当 Reasoner 尚未返回结果时,Talker 根据对话上下文生成类似「我来帮你查一下」的自然过渡语;当 Reasoner 开始输出知识片段后,Talker 就将这些信息组织成连贯的后续回答。系统使用知识队列和 TTS 队列协调两个模型,让用户听到的始终是同一个 Talker 的声音。
MCP 工具调用场景首句响应提速 19.1 倍: 团队在 Apple M2 设备上测试了普通对话、文档检索(RAG)和 MCP 工具调用三种场景。ConvFill 的首句文本生成时间分别为 542ms、976ms 和 478ms,相较直接等待大型 Reasoner,分别快 7.4 倍、9.2 倍和 19.1 倍。
29 万条合成训练数据,让小模型学会接收大模型的提示: 团队构建了包含 290,571 条样本的数据集,覆盖日常建议、助理问答、等六类对话场景。训练数据同时包含「尚无知识返回」和「已有知识片段」两种情况,使 Talker 学会何时自然过渡、何时根据 Reasoner 的信息组织答案。
ConvFill 论文收录于 EMNLP 2026 Findings,团队已在 GitHub 公开完整推理框架、训练流程和浏览器语音 Demo,代码采用 MIT 许可证。
https://convfill.cs.washington.edu/
3、IBM 开源 Granite Speech 5.0 语音模型系列:2B 模型转写 WER 低至 5.06%,470M Turbo CTC 吞吐率达 19,870 RTFx
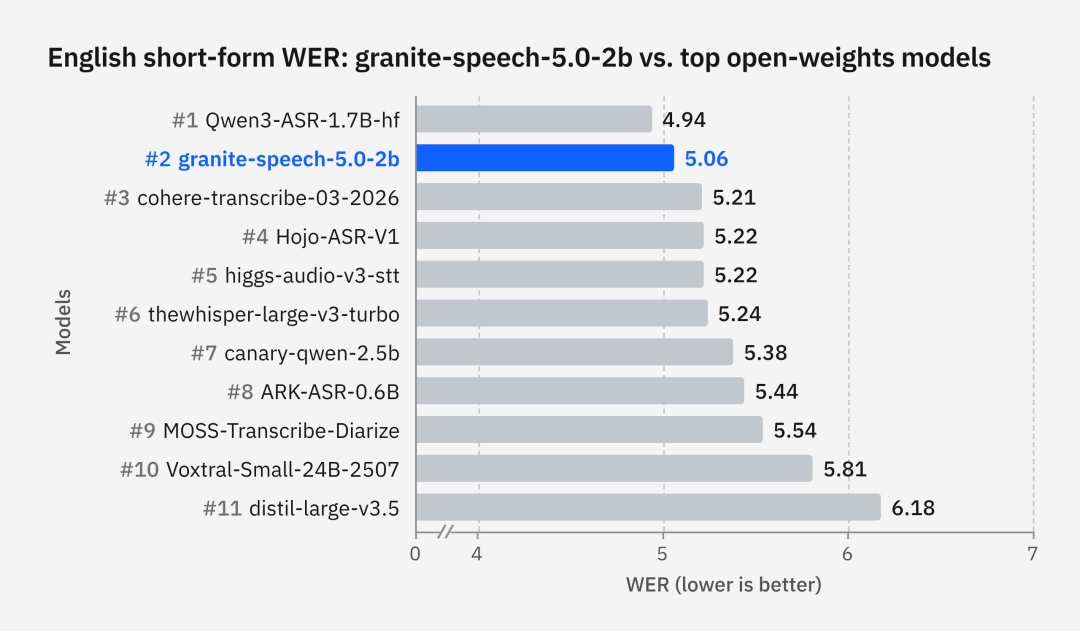
IBM 于 10 月 21 日发布 Granite Speech 5.0 系列更新,包括全新的 Granite Speech 5.0 2B,以及升级后的 470M Turbo CTC 和 Granite Speech 4.1 2B Plus。三款模型分别面向多语言语音转写与翻译、高吞吐量端侧识别,以及会议中的说话人识别和时间戳生成。全部模型权重已在 Hugging Face 开放,采用 Apache 2.0 许可证。
Granite Speech 5.0 2B:支持六种语言转写,英语 WER 达 5.06%: 新模型基于约 39 万小时公开音频数据及合成数据训练,支持英语、法语、德语、西班牙语、葡萄牙语和日语转写,以及这些语言与英语之间的双向语音翻译,另外支持英语翻译成意大利语和中文。在 Open ASR Leaderboard 的公开英语短音频测试中,平均词错误率(WER)为 5.06%,位列开源权重模型第二名。相比上一代,模型提高了噪声、混响和远场录音场景下的识别鲁棒性,并支持通过提示词指定输入语言,以及最多 2000 个关键词的专业术语识别增强。
Granite Speech 4.1 2B Plus:说话人识别错误下降 7%,长音频 WER 降低 24%: IBM 同步更新了面向多人会议和电话录音的 2B Plus 模型,在保持原有架构和 API 兼容性的同时改善识别精度。新版说话人归属错误率(WDER)由 4.40% 降至 4.10%,带说话人标签的转写错误率(cpWER)由 30.50% 降至 28.48%,两项指标均改善约 7%。
支持 Transformers、vLLM、llama.cpp 与 Apple Silicon 本地部署: Granite Speech 5.0 2B 已支持 Transformers 4.52.1 及以上版本,也可通过 vLLM 部署兼容 OpenAI 的推理接口,并提供 llama.cpp GGUF 和
mlx-audio的 Apple Silicon 运行方案。470M Turbo CTC 则要求 Transformers 5.16.0 及以上版本,同时支持mlx-audio,IBM 还提供基于 WebGPU 的浏览器流式语音识别演示。对于较长录音,2B 模型建议先将音频按约 2 分钟分段,再分别执行识别。
https://huggingface.co/blog/ibm-granite/granite-speech-5
4、美国 Destined AI 开源 Hurston-1:3B 参数 TTS 专攻美国南方与非洲英语口音,支持 8kHz G.711 电话语音输出
美国亚特兰大语音 AI 公司 Destined AI 开源文本转语音模型 Hurston-1,重点生成传统 TTS 模型容易弱化的地域性英语口音,包括美国南方、尼日利亚、西非、东非及南部非洲英语。该模型基于 Maya1 3B 微调,采用 Apache 2.0 许可证,并提供专门面向电话系统的 NB-TTS(窄带语音合成) 模式,可输出兼容 Twilio、SIP 和 IVR 系统的 8kHz G.711 音频。
支持 9 类英语口音描述,可控制年龄、性别、风格和语速: Hurston-1 支持普通美式英语、美国南方英语、尼日利亚英语、尼日利亚约鲁巴及伊博语背景英语、西非英语、东非英语、斯瓦希里语背景英语和南部非洲英语。开发者可以直接用自然语言指定声音特征,例如「成年女性、尼日利亚英语口音、清晰的对话风格、自然语速」。模型还支持有声书、日常对话等不同朗读风格。这些都是英语的地域性口音,并不代表模型能够直接合成约鲁巴语、伊博语或斯瓦希里语。
提供电话窄带输出模式,直接对接 Twilio 语音系统: 模型默认生成 24kHz 音频;启用
--phone后,系统会将合成语音限制在电话常用的 300–3400Hz 频段,重采样至 8kHz,再编码为 G.711 μ-law,也支持 A-law 格式。项目提供ulaw_encode()接口,可直接生成 Twilio Media Streams 所需的原始音频字节。电话模式采用的是合成后的信道处理,而不是模型直接生成原生 8kHz 音频码流。使用约 190 小时语音微调,包含真实 AI 电话对话: Hurston-1 基于 Maya1 进行 Rank 64 LoRA 微调,共训练 2000 步。训练数据包括 Destined AI 自建的约 136 小时地域口音语音、约 46 小时 LibriTTS-R 有声书语料,以及约 10.5 小时 Mozilla Common Voice 英语数据。
盲听测试获 78% 偏好率,困难文本 WER 降至 6.2%: 在开发团队组织的 54 组盲听对比中,测试者有 78% 的情况认为 Hurston-1 更接近目标口音的真人说话方式,原版 Maya1 获选比例为 6%。在 510 条困难文本生成样本上,单次生成音频经 Whisper 识别得到的平均词错误率(WER)为 14.5%;启用
--check自动质量检测与重试机制后,WER 降至 6.2%。
https://huggingface.co/destined/hurston-1
02 有亮点的产品
1、前 Meta 团队创立的 Nirva 完成 2500 万美元融资:累计融资 3300 万美元,推出 8g 声纹识别 AI 珠宝吊坠
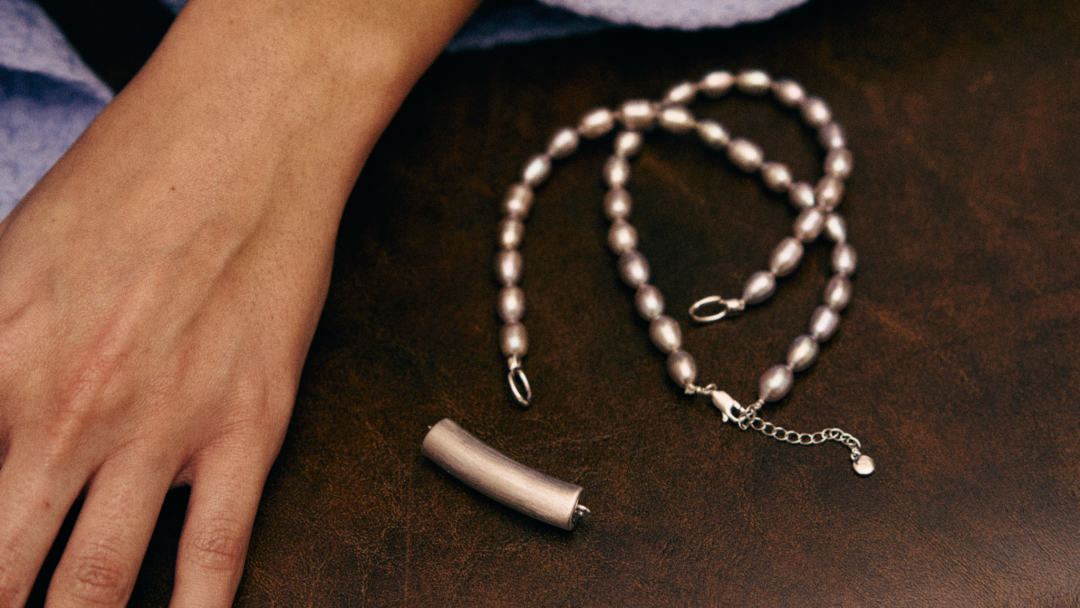
美国 AI 可穿戴公司 Nirva 于 10 月 22 日宣布完成 2500 万美元 Pre-Series A 轮融资,加上此前获得的 800 万美元早期融资,累计融资额达到 3300 万美元。Lightspeed Venture Partners 和 South Park Commons 等机构参与了此前的融资。公司首款产品是一款仅重约 8g 的 AI 吊坠,通过持续感知佩戴者的语音,自动生成生活日记、情绪分析和个性化提醒。
声纹识别过滤周围人声,重点记录佩戴者自己的表达: Nirva 在首次使用时要求用户录制短语音样本,以建立个人声音特征。设备日常佩戴时持续监听,并利用声音识别能力过滤其他人的对话,尽量只处理佩戴者本人的语音。与需要手动启动录音的设备不同,Nirva 的语音感知功能可在后台持续运行。
从语音中提取情绪与行为模式,生成个性化生活建议: Nirva 配套应用可以整理用户的日常表达,形成生活日志,并分析情绪变化、沟通方式、人际关系和反复出现的行为模式。系统不仅处理说话内容,还会分析语调、音高、音量和语速等声音特征。
8g 钛金属吊坠,售价 249 美元,计划年底交付: Nirva 首款硬件采用珠宝式设计,既可以作为项链吊坠,也可以作为手链佩戴。设备提供银色、拉丝银色、黑色和金色四种外观,单次充电标称续航最长 3 天。公司计划于 2026 年 11 月开放订购,售价 249 美元,目标在年底前向首批用户交付。据公司披露,目前已有约 9000 人加入产品候补名单。
Nirva 成立于 2025 年,由前 Meta Reality Labs 成员 Wei Lyu、Jason Chen 与珠宝品牌创业者 Hanying Hu 共同创立。公司计划将本轮融资用于首款产品上市,以及后续 AI 可穿戴设备的研发。
(@AING 硬迹)
2、YC 孵化公司 Hopper 发布语音 AI 推理云:Gemma 4 首 Token 延迟 80ms,集成 Qwen3-TTS 与 Nemotron ASR,支持企业语音模型持续优化
美国旧金山 AI 基础设施公司 Hopper 于 10 月 27 日正式发布面向实时语音 Agent 的推理云平台,提供语音识别(STT)、大语言模型(LLM)和语音合成(TTS)推理服务。平台重点优化语音对话中的首 Token 延迟、首段音频生成速度和推理成本,并允许企业利用真实业务数据对开源权重模型进行针对性训练。Hopper 已入选 Y Combinator 2026 年秋季批次。
Gemma 4 31B 首 Token 延迟 80ms,输入成本约为 GPT-4.1 的 15%: Hopper 首批提供 Gemma 4 31B 推理服务,官方公布的首 Token 延迟(TTFT)为 80ms,对比 GPT-4.1 的约 600ms。价格为每 100 万输入 Token 0.30 美元,GPT-4.1 的对比价格为 2 美元。这些数字衡量的是语言模型推理表现,不包含语音识别、语音合成和网络传输在内的完整语音 Agent 响应时间。
利用真实通话数据训练专属模型,改善指令遵循、工具调用和语音表达: Hopper 不仅提供模型托管,还为企业构建持续优化流程。团队会先根据客户的业务提示词和真实任务建立评测集,再针对开源模型进行后训练。例如,可以训练 LLM 更准确地遵循业务规则、选择工具并传递调用参数,也可以针对 TTS 优化品牌名称发音、字母数字的朗读速度及情绪表达。平台支持按业务需求选择部署区域,并通过缓存和推理性能监控持续优化服务。
针对语音对话优化网络连接,支持 OpenAI 兼容接口: Hopper 还开发了
hopper-client,通过 HTTP/2 连接复用和 300 秒 Keep-Alive,减少多轮对话中重复建立 TCP/TLS 连接的开销。在同一模型端点的测试中,存在轮次间隔的场景中,首 Token 延迟从 510ms 降至 197ms;20 路并发场景中则从 600ms 降至 319ms。开发者可通过兼容 OpenAI SDK 的调用方式接入,API 服务地址为https://api.withhopper.com/v1。
Hopper 由 Pavan Katta 和 Jashwanth Pedapudi 共同创立。Pavan 曾在语音 AI 公司 Salient 负责每日数百万通电话的语音推理系统;Jashwanth 曾在 Meta Reality Labs 为 Quest 3 开发底层推理算子。公司获得 Y Combinator 及来自 Turing、xAI、Stripe、Rubrik 等公司的行业人士支持。
https://withhopper.com/
3、全球人力资源管理软件公司 Dayforce 宣布收购加拿大 AI 招聘公司 Ribbon AI:将实时语音面试 Agent 集成至招聘平台,累计完成超 100 万场 AI 面试
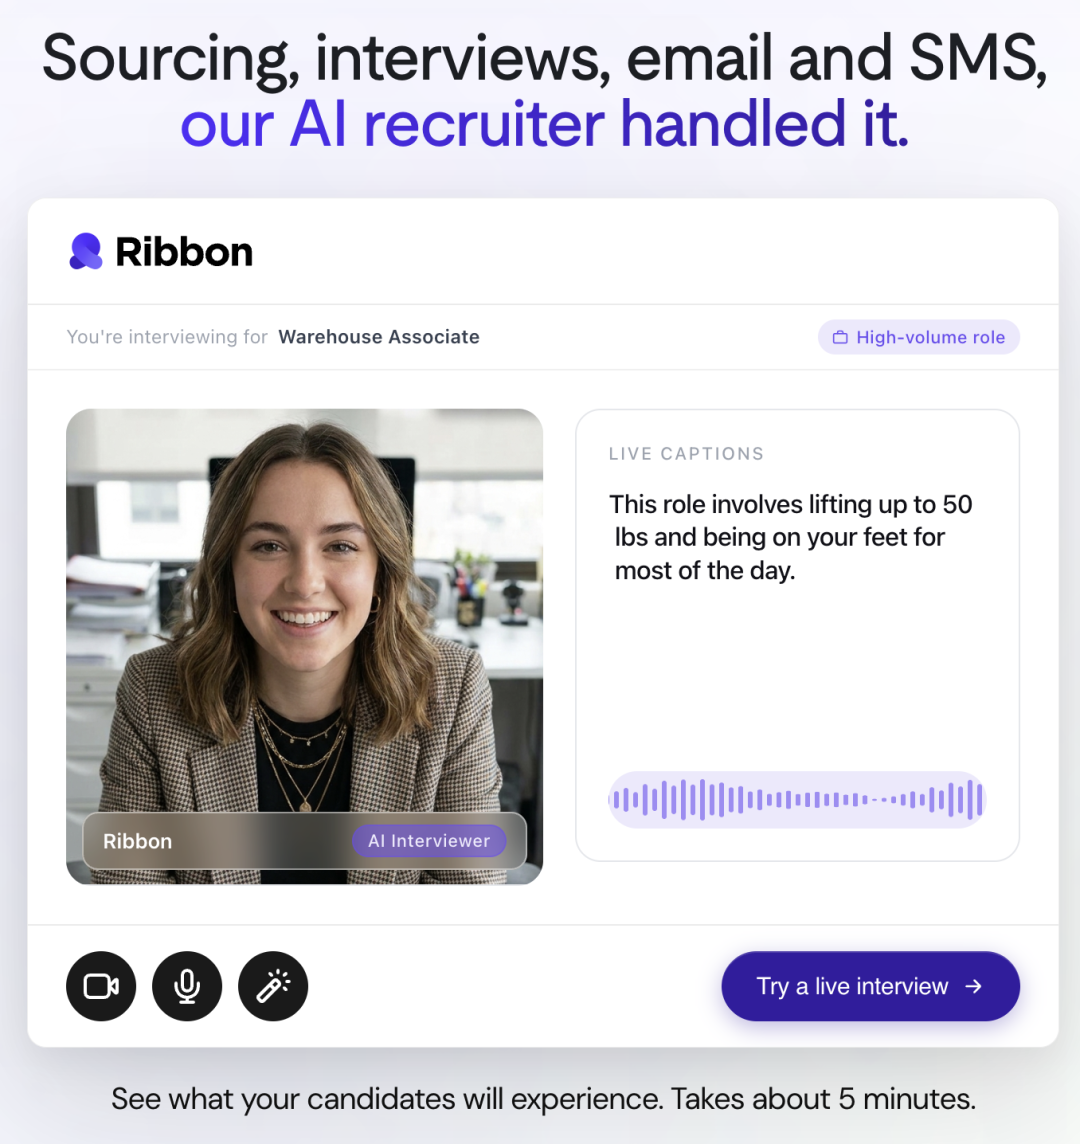
全球人力资源管理软件公司 Dayforce 于 10 月 23 日宣布签署协议,拟收购加拿大 AI 招聘公司 Ribbon AI,将其语音与视频 AI 面试技术整合进 Dayforce Agentic Recruiting 招聘平台。Ribbon 的 AI 面试官可全天候与求职者进行双向语音对话,自动完成初步筛选、面试评估和候选人跟进。Dayforce 披露,Ribbon 已服务数百家企业,累计完成超过 100 万场 AI 面试。
AI 语音面试官支持 7×24 小时双向对话: Ribbon 的 AI 面试官 Bonnie 可以根据岗位要求与求职者进行实时语音交流,动态提出追问,而非仅播放预设问题。候选人无需等待招聘人员安排时间,可以随时通过电话或在线界面完成初轮面试。Ribbon 官网显示,其语音面试支持 10 种语言,适用于零售、仓储、客服等大规模招聘场景。
根据岗位描述自动生成面试问题与评分标准: 企业输入职位描述后,Ribbon 可以结合相关历史面试信息生成问题和评分表,并依据面试转写文本评估候选人的专业技能、问题解决能力及岗位匹配度。系统向招聘团队提供结构化摘要与候选人评分,供招聘人员进一步审核。Ribbon 还提供视频及面试真实性检测功能,可识别异常音频、视线变化和回答时间模式。Dayforce 表示,约 90% 的 Ribbon 客户使用系统推荐的默认配置。
集成候选人搜索、人才库激活及多渠道触达: 除语音面试外,Ribbon 还可以从企业现有招聘数据库中重新发现符合岗位要求的候选人。官方称,相关技术曾在单个招聘管理系统中针对最多 3000 万名候选人进行测试。系统支持通过 短信、WhatsApp 和电子邮件自动发送面试邀请及跟进消息。Ribbon 官网还披露,其产品已支持与 60 多款招聘管理系统(ATS) 集成,包括 Workday、Greenhouse 和 UKG。
并入 Dayforce Agentic Recruiting,串联招聘全流程: 交易完成后,Ribbon 的语音面试、候选人搜索、评估和沟通能力将原生整合进 Dayforce 的招聘平台,与现有人力资源管理、人才管理及员工数据系统衔接。Ribbon 也正在开发 AI 面试安排 Agent,用于进一步自动处理候选人与招聘团队之间的日程协调。
https://www.dayforce.com/who-we-are/newsroom/dayforce-to-acquire-ribbon-ai-inc-to-advance-agentic-recruiting
https://www.ribbon.ai/
4、前微软 Copilot 高管 Peter Sellis 加盟 X 担任产品负责人:曾主导 Snapchat、Discord 产品业务,接替 Nikita Bier
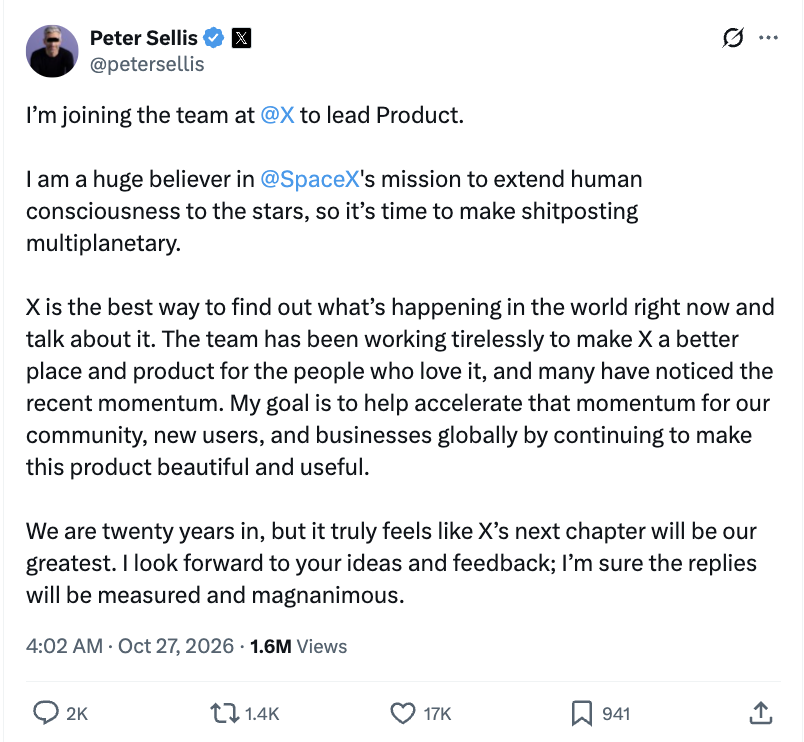
10 月 27 日,Peter Sellis 在 X 平台宣布加入公司,担任产品负责人(Head of Product),负责推动 X 的产品发展。Sellis 此前曾在微软负责 Copilot 的设计、增长及工程相关业务,并先后担任 Snap 产品副总裁、Discord 产品高级副总裁,拥有超过十年的消费级社交产品经验。
负责 X 的整体产品发展: Sellis 在公告中表示,将继续改善 X 的产品体验,推动现有社区、新用户以及全球企业客户的增长。他强调,X 的核心价值在于帮助用户实时了解世界动态并参与讨论,未来将重点提升产品的易用性与用户体验。
曾任 Snapchat 首位产品经理、Discord 产品高级副总裁: Sellis 于 2015 年加入 Snap,是 Snapchat 的首位产品经理,随后升任产品副总裁,参与广告产品及商业化业务建设。2022 年至 2026 年,他担任 Discord 产品高级副总裁,负责消费级社交产品、社区体验及产品增长。加入 X 前,他还曾在微软参与 Copilot 的产品设计、增长和工程管理。
接替 Nikita Bier 出任 X 产品负责人: X 前产品负责人 Nikita Bier 于 2026 年 8 月卸任,转为公司顾问。Bier 任职期间推动了信息流、Android 应用、聊天和通知等功能的改版,并参与创作者变现产品调整。其卸任后,X 的产品和设计工作暂由多名负责人共同推进,此次 Sellis 加入后将重新统一领导产品业务。
03 有态度的观点
1、比尔·盖茨:AI 带来富足前,要先度过约 20 年的动荡
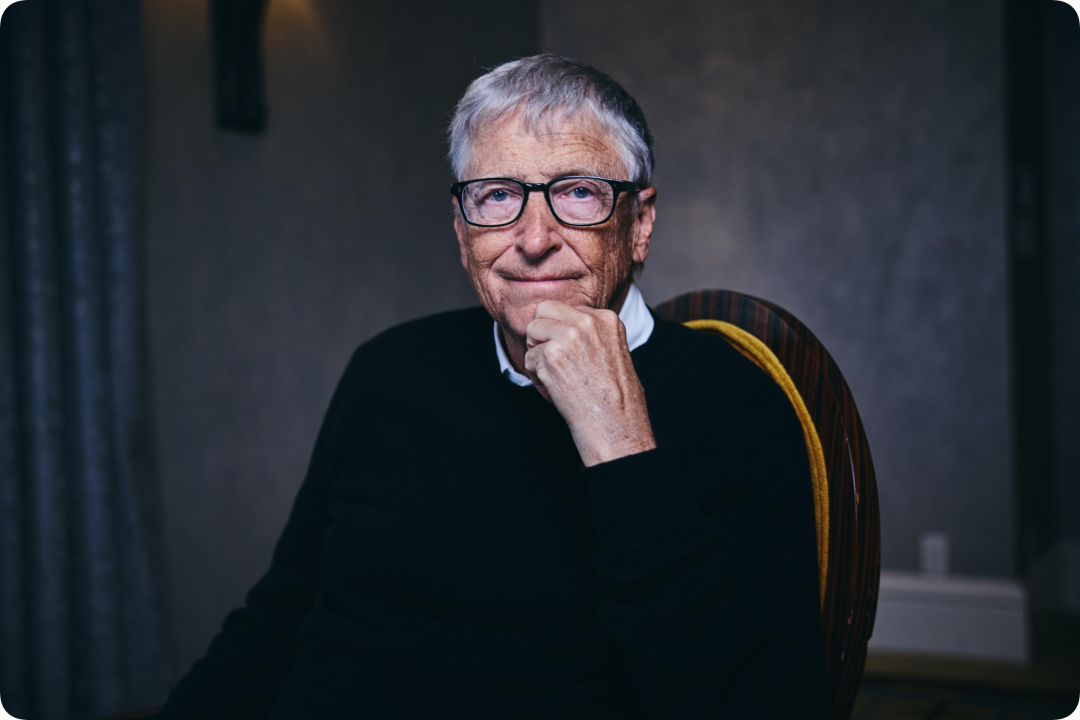
比尔·盖茨在 10 月 22 日播出的 Decoder 播客访谈中表示,AI 能够减少住房、食物和医疗等领域的短缺,但他更担心通往富足的约 20 年过渡期:其间会出现赢家、输家和大量冲击。在盖茨看来,电话销售、客服和会计等白领岗位会先受到影响,人形机器人随后也可能改变体力劳动。
工作同时提供收入、目标感、同事关系与解决问题的机会,单靠商品变便宜无法回答人们如何获得这些东西。他以自己的慈善工作举例:即使组织资源消除疟疾曾是他的独特贡献,AI 也可能做得更好,把他打发去打匹克球。对希望作出独特贡献的年轻人来说,这种能力变化会带来压力。
盖茨提出,人类可以选择把育儿、烹饪、艺术和体育等领域保留给人来做,即使 AI 能做得更好;提前退休、缩短工作周也是可讨论的办法。这些安排需要社会作出政策选择。
他认为,一部分人可能主动远离技术前沿,以保留互相帮助和作出独特贡献的空间。他同时强调,20 年只是自己选取的一个相对稳妥的估计,实际时间可能更长或更短。如果不大幅放缓或停止 AI 发展,机器人将逐步承担建房、种植食物和手术等工作;人类需要决定如何安排富足时代的生活,而他当前的重点仍是如何度过这段转型期。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考