小米开源 4 个 AI 硬件项目:全时记忆配饰、实时语音机器人与机械臂台灯等丨日报
本期编辑:@三水、@鲍勃
今天日报开头先插播一条:10 月,来北京线下对答案。
当然,答案不一定一样~
这一年,我们在日报里持续关注实时智能正在发生的变化。从国内到海外,从全双工、端到端语音、Voice Agent、实时多模态、世界模型,到新模型发布、开源项目、产品落地和创业融资,很多问题其实一直在反复出现:
全双工到底做到哪一步了?端到端语音会不会替代级联架构?Voice Agent 怎么真正进入生产环境?实时多模态和世界模型接下来又会怎么落地?
这次,我们想把这些问题搬到线下,和大家一起交换答案。
而这次,很多日报里出现过的公司、项目和开发者,也会来到 iRTE 2026 实时智能大会现场。比如有阶跃星辰、Kimi、Minimax、面壁智能、生数科技、模思智能等 AI 模型公司,也有我们此前报道过的 VoiceMem、SGLang-Omni、Breeze-TTS 等开源项目作者或团队参会。当然,这还只是目前提前剧透的一部分,还有一些神秘嘉宾会陆续揭晓~
10 月 23–24 日,大会会有 15+ 个论坛、100+ 场技术分享,从模型、Agent,到 AI 硬件和实时基础设施,把过去一年我们持续关注的很多话题真正聚到一起。
如果你也每天在关注这些,扫描下方二维码报名,来交换一下你的答案。
线上看了一年,这次线下见~
01 有话题的技术
1、全双工语音推理框架 pega-omni 开源 PersonaPlex Serving:单张 GB300 并发 128 路实时会话,每轮 80ms 音频计算约 15ms
pega-omni 开源 NVIDIA PersonaPlex-7B 的全双工语音 Serving 实现,在单张 GB300 上可同时运行 128 路实时双向语音会话,保持音频连续播放;128 路并发时,每个 80ms 音频帧周期的 GPU 计算约 15ms。
所有会话按固定 80ms 时钟统一批处理: PersonaPlex 持续同时接收和生成语音,每个周期将当前会话批量放入 CUDA Graph,一次完成 Mimi 编码、Helium 推理、Depformer 生成和 Mimi 解码。128 路会话时,单个 tick 的 p50 / p99 分别约为 15.0 / 15.9ms。
KV 改为固定大小的环形缓冲: 每个会话建立时一次性分配包含 3000 个位置的 KV 环,之后不再随对话长度增长;旧帧会随着环形缓冲推进自动退出注意力范围,避免长时间全双工会话因 KV 持续增长而在中途 OOM。
对外直接使用 GPT-Live WebSocket 协议: 客户端可以持续双向传输音频,不需要人为划分 response、commit 或 VAD turn boundary。pega-omni 还通过 PersonaPlex 官方参考实现进行逐帧正确性验证,其中模型输入和输出音频帧逐帧一致,文本及 Depformer logits 保持高度接近。
https://github.com/pegainfer-project/pega-omni
https://x.com/SuJinYan123/status/2103748126008045963
2、科大讯飞发布语音识别大模型 Spark-ASR-2.0:非自回归与 LLM 增强自回归协同,增加上下文纠错和口语成文
科大讯飞发布 Spark-ASR-2.0,基于此前的语音基座大模型 Spark-Audio-1.0-Preview 构建。相比 Spark-ASR-1.0 主要通过非自回归架构提升推理效率,2.0 加入 LLM 增强的自回归识别和动态上下文注入,在保持快速识别的同时,可结合上下文、用户历史修改和个性化热词处理歧义,并直接整理口头语、重复和改口等内容,整体推理成本较 1.0 增加 10%。
非自回归与 LLM 增强自回归协同: 非自回归部分负责快速生成识别结果,再针对需要上下文理解的内容进一步修正,减少对整段语音重新解码带来的额外计算。
上下文直接进入识别过程: 动态上下文注入会结合当前文本、用户识别历史、修改记录和个性化热词,对人名、专业术语、同音词等易混淆内容进行判断;同时支持从万级热词库筛选相关候选词。
转写结果增加口语整理与格式规范: 模型可减少语气词、重复和临时改口,并对标点、数字、符号和单位进行规范化输出。通用识别还覆盖中英文混合、专业术语,以及全国 202 个城市的方言免切换识别。
Spark-ASR-2.0 已通过讯飞开放平台提供 API,并从 9 月 24 日起逐步上线讯飞输入法。
https://www.xfyun.cn/services/spark_asr_zh_en_v2.0
3、PixVerse 发布实时世界模型 R2:加入持久世界状态,文本、音频和操作可持续改变后续世界
PixVerse 发布实时世界模型 R2。相比 R1 已实现的连续音视频生成和实时交互,R2 进一步加强长程状态保持:用户输入的提示词、操作和音频不再只改变当前画面,而会更新正在运行的世界状态,并持续影响后续角色行为、环境和剧情发展;模型同时统一接收文本、参考素材、音频和 Action 控制,并连续生成同步音视频。
交互结果可以持续保留: 玩家可以通过 WASD、镜头控制和提示词实时改变正在生成的世界,此前发生的变化会继续进入后续生成,而不是每次操作后重新开始。角色也可以在多轮交互中保持此前的身份、对话和剧情上下文。
统一建模长程世界与多模态控制: R2 使用 Omni Causal AR,将历史世界状态、当前交互输入和未来音视频生成放在同一条因果序列中;通过多时间尺度记忆保存世界锚点、近期动态和对象状态,并加入错误状态训练以减少长时间运行中的漂移。
实时加速针对长上下文计算优化: R2 使用块稀疏注意力,将注意力稀疏度提升至 90%+;同时采用金字塔式超少步蒸馏,先在低分辨率确定场景和运动,再用极少的高分辨率步骤恢复细节,以降低持续生成的计算成本。
PixVerse 7 月推出的 Game Engine 已运行在 R2 之上,目前也开放了一批可直接体验的实时世界。
https://pixverse.ai/zh/blog/pixverse-introduces-r2-real-time-world-model
4、159M 端侧音频语言模型 Mizar 开源:本地 CPU 平均 1.09 秒完成音频问答,MMAU 超 GPT-4o mini Audio
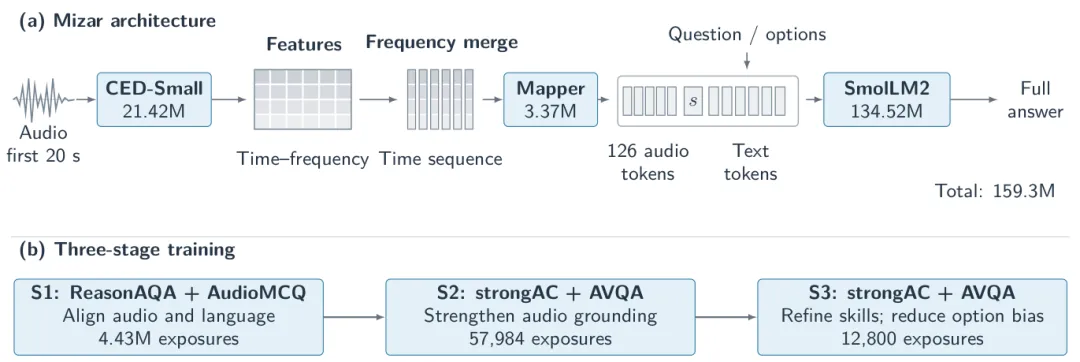
Kaiyang Li、Shaobo Han、Yue Tian、Shihao Ji 开源 Mizar,一个面向本地音频理解的 159M 音频语言模型,可直接输入声音和问题,理解语音、音乐及环境声等音频内容并生成文本回答。在 MMAU 测试集上,Mizar 五个随机种子平均准确率达到 52.92%,高于 GPT-4o mini Audio 的公开成绩;在单 CPU 本地推理测试中,从读取音频到生成完整回答平均耗时 1.09 秒。
159M 参数完成音频理解: Mizar 将冻结的 CED-Small 音频编码器通过频率合并映射器连接到 SmolLM2-135M,整套模型共 1.593 亿参数,不依赖云端大模型完成音频问答。
200M 参数以下模型三项基准均刷新此前最佳结果: 五个随机种子下,Mizar 在 MMAU、MMAR 和 ADQA-clean 上平均准确率分别为 52.92%、42.42% 和 36.02%。
支持 CPU 本地运行: 在 MMAU 问题测试中,从打开音频文件、完成音频处理到生成完整文本答案,平均延迟为 1.09 秒。当前模型一次处理音频的前 20 秒,主要使用英文文本数据训练。
https://github.com/KaiyangLi1992/Mizar_159M
02 有亮点的产品
1、小米 AI 硬创团队集中开源 4 个 AI 硬件项目:覆盖全时记忆、Agent 状态桌搭、实时语音机器人和机械臂台灯
小米 AI 硬创团队集中开源 DayoTag、HachimoDock、Brufik 和 YareLampGo 四个可复刻的 AI 硬件项目,分别探索可穿戴记忆、Agent 状态反馈、实时语音陪伴以及 AI 与机械动作结合等方向,硬件设计与软件能力均向开发者开放。
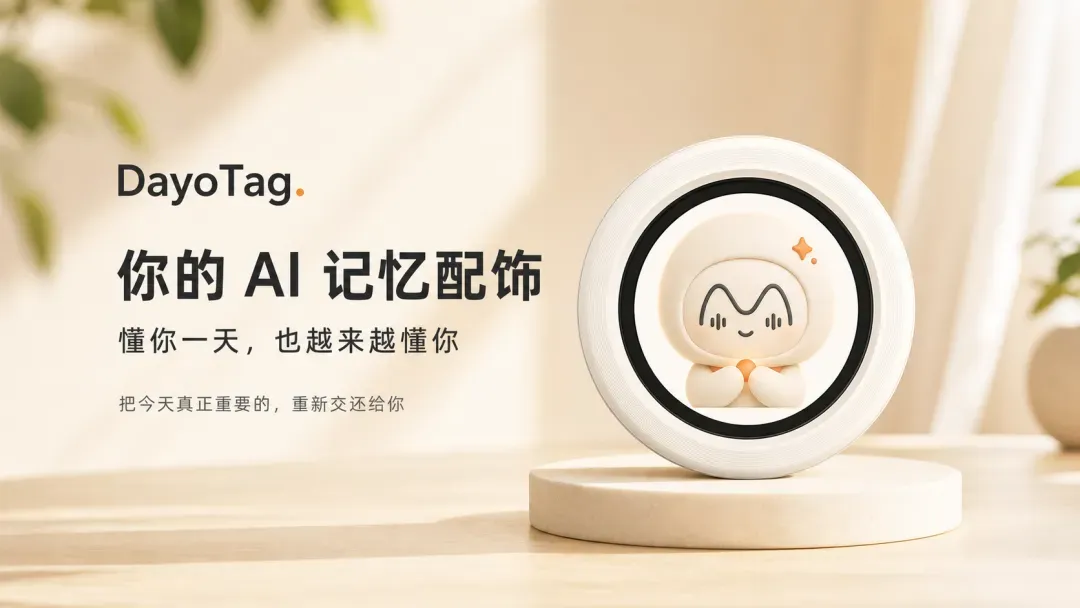
DayoTag|AI 记忆配饰: 设备可持续采集声音并本地落盘,通过蓝牙增量同步至手机,再由 Agent 对一天中的对话、灵感、承诺等内容进行转写、整理和关联;硬件记录不依赖手机持续在线。
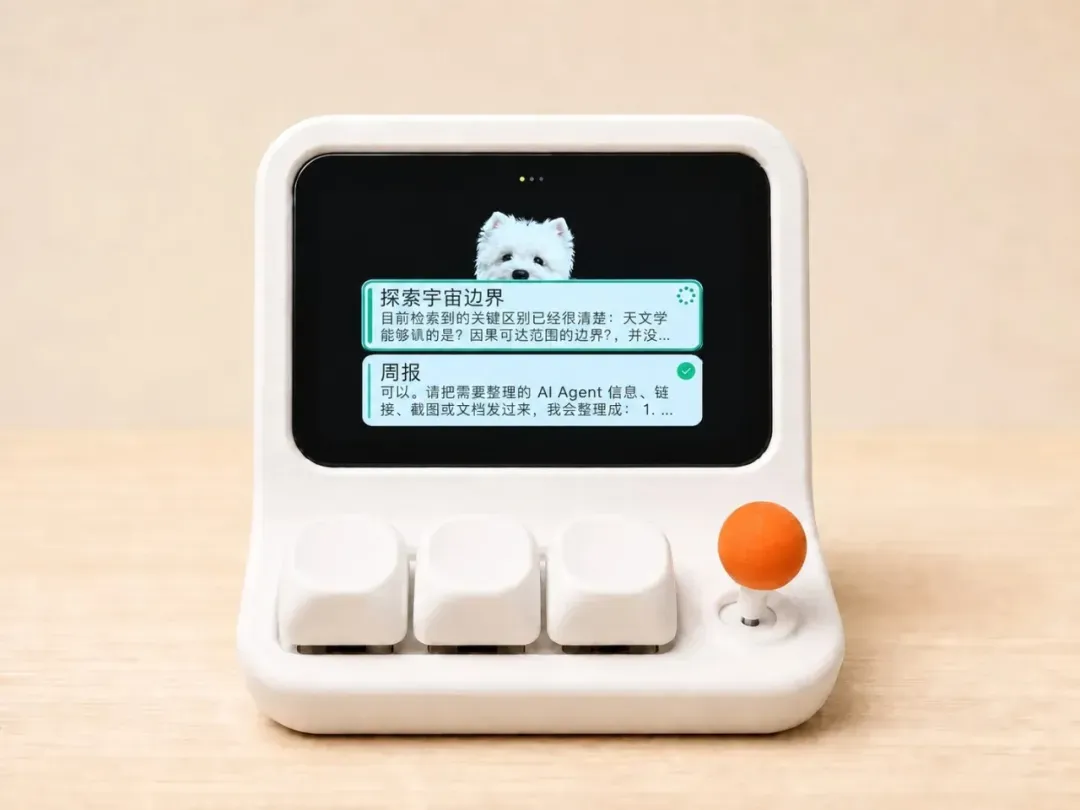
HachimoDock|Agent 状态桌搭: 将 Codex、Claude Code、OpenClaw 等电脑端 Agent 的思考、工具调用、完成、报错和等待确认等状态同步到桌面小屏,通过角色表情、动作和短标签反馈;同时支持语音下发任务和自定义桌面组件。
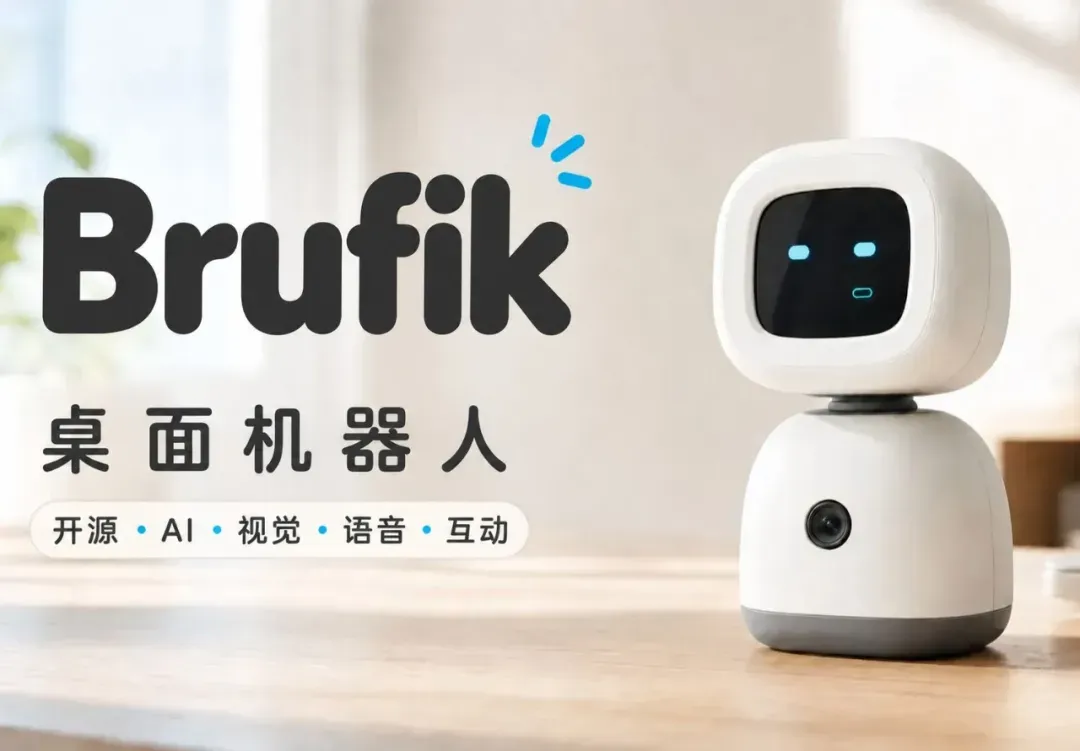
Brufik|实时语音桌面机器人: 通过实时语音、口型同步、屏幕表情和头部动作组合角色反馈,并支持记忆、提醒和拍照问答;接入 Xiaomi Miloco 后,还可以通过自然语言查询和控制兼容的米家设备。
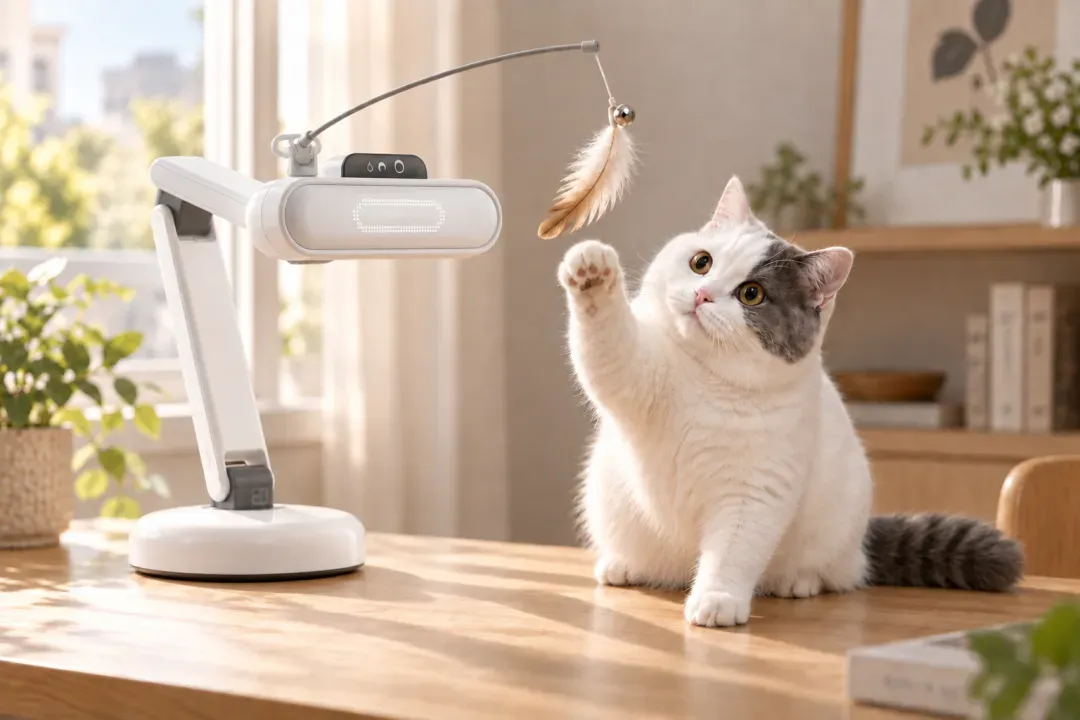
YareLampGo|AI 机械臂台灯: 将多轴机械臂、摄像头、麦克风、屏幕和灯光组合在一台桌面设备中,支持自然语言调用动作、表情和灯光能力,也可以录制和编排自己的动作 Skill,实现「观察—行动—再观察」的实体交互。
DayoTag:
https://oshwhub.com/eda_kqtkoxdx/project_bpeoomns
HachimoDock:
https://oshwhub.com/eda_gqvzlprk/project_cnbmkbjc
Brufik:
https://oshwhub.com/eda_hedwaytj/project_asxqsedb
YareLampGo:
https://oshwhub.com/eda_wbgvlqyi/project_rimxldmp
2、Microsoft Foundry 推出原生 Voice Agents:统一语音模型、工具调用、追踪评估与电话部署
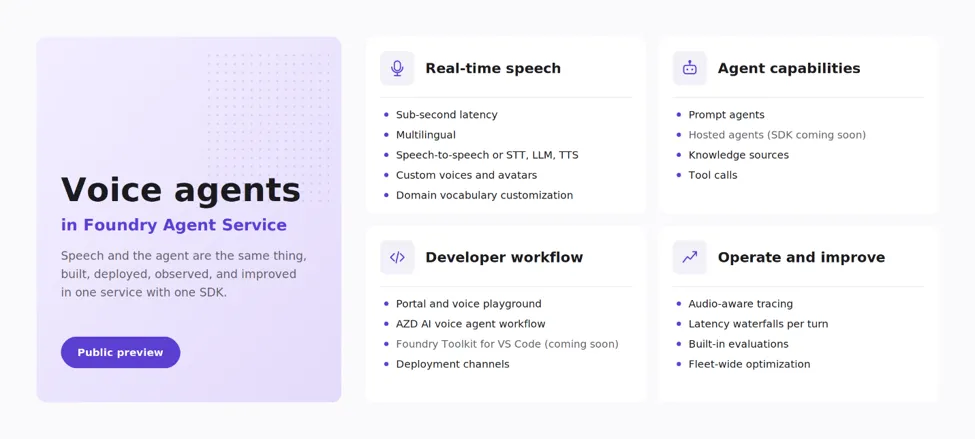
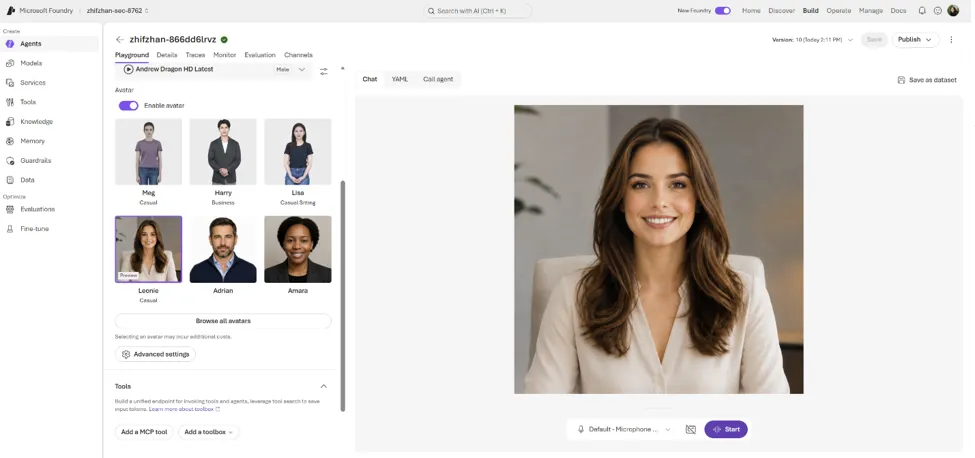
Microsoft Foundry 在 Agent Service 中加入 Voice Agents,目前开放公开预览。开发者可以像构建文本 Agent 一样配置模型、指令和工具,再直接接入实时语音;语音会话同时复用 Foundry 已有的追踪、监控、评估和企业治理能力,不再需要单独搭建一套语音 Agent 运行与运维链路。
Voice Agent 成为原生 Agent 类型: 支持 Prompt Agent 和 Hosted Agent,可选择 GPT Realtime、Azure Realtime、MAI 等语音模型,或接入自己的模型;模型、工具和企业知识可以继续沿用现有 Foundry Agent 配置。
语音会话接入统一可观测链路: 支持查看完整会话追踪、转写、工具调用和延迟等信息,并可对已有语音会话进行整段评估,用于检查任务完成、意图理解、工具调用和回复质量。
从网页继续扩展到电话渠道: Voice Agents 可部署到 Web、Microsoft Teams,并通过 Teams Phone 和 Twilio 接入电话场景;同时支持 80+ 种语言、140+ locale,以及自定义语音、Custom Speech 和 Avatar。
https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/introducing-voice-agents-in-microsoft-foundry/4557276
3、非洲企业自动化平台 PayWithPlay 上线 CallGPT:AI Agent 直接接听企业电话,支持尼日利亚英语与 Pidgin(尼日利亚皮钦英语)
尼日利亚企业自动化平台 PayWithPlay 上线语音 Agent 平台 CallGPT,面向企业电话客服和销售场景,可直接通过传统电话号码自动接听和发起电话,处理咨询、预约、订单和线索筛选,并将通话数据同步至 CRM、订单及支付系统。CallGPT 已在尼日利亚商业上线,并计划继续扩展至非洲和中东市场。
直接接入电话网络: 企业可以配置虚拟号码,让 AI Agent 自动处理呼入和呼出电话;目前提供尼日利亚 +234 号码,并覆盖 22 个国家的虚拟号码,同一个 Agent 可以根据号码或来电者语言切换语音。
针对非洲语音和通信场景做本地化: 当前官网明确列出 Nigerian English 和 Pidgin 已上线,Yoruba、Hausa、Igbo 等语言继续扩展;系统同时针对当地电信网络和移动端使用环境进行部署优化。
电话可以继续触发业务流程: CallGPT 提供 API 和 Webhook,可连接 CRM、订单系统及 Paystack、Flutterwave、M-Pesa、MTN MoMo 等本地支付基础设施,让一次电话继续完成订单、支付或后续业务操作。
https://paywithplay.africa/
4、爱尔兰老年照护语音 AI 公司 Amethyst Care 获 10 万欧元融资:用语音陪伴结合远程健康监测
爱尔兰老年照护科技公司 Amethyst Care 获得 Enterprise Ireland 10 万欧元种子前期创业基金投资,用于继续开发和商业化其面向老年人的 AI 语音陪伴产品。系统以语音为主要交互方式,无需屏幕,可主动进行每日健康问询和用药提醒,并持续收集健康与行为数据,将异常提醒和长期趋势提供给家属及医护人员,帮助行动不便的老年人在家独立生活更长时间。公司近期还在美国俄亥俄州 Mentor 开设办公室,并计划启动新一轮种子融资。
https://www.amethystcare.ie/
03 有态度的观点
1、比尔·盖茨:AI 可能引发十亿人死亡事件
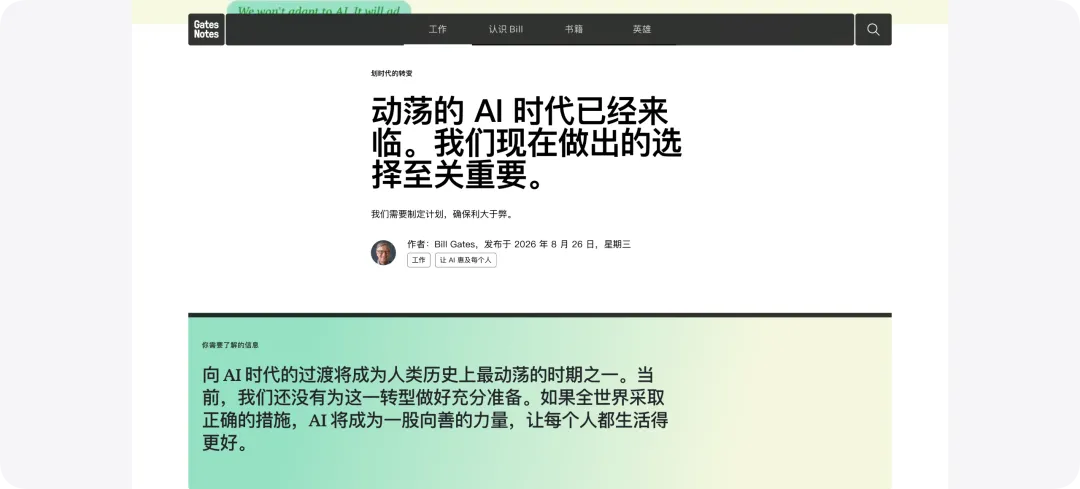
微软联合创始人比尔·盖茨在 NBC《Meet the Press》采访中警告,AI 的能力已足以推动造成十亿人死亡的事件。他强调,风险在于怀有恶意的人使用最新 AI 工具,认为这种组合比以往任何武器都更强大。
盖茨在 8 月发表于个人网站的长文中解释了担忧的依据:AI 会降低实施网络攻击和生物恐怖主义的门槛,让能力有限的犯罪者也能针对医院、金融机构、水电系统等基础设施发动攻击。他认为,同一模型既能帮防御方找漏洞,也能帮攻击方利用漏洞,现有机制难以彻底切分两种用途。
他提出,政府需要建立跨部门机构,协调国家安全、就业、教育、公共卫生等事务,并与其他国家建立国际治理框架。盖茨以核武器核查和国际航空规则为参照,主张对跨境风险设立共同监督;对就业冲击,则建议让劳动者、企业和社区参与政策讨论。
盖茨同时承认,全球放缓 AI 进展的统一计划在经济和地缘竞争下很难实现。他主张继续推动 AI 在医疗、农业和教育中的应用,同时及早为恶意使用和岗位流失建立应对机制;他把如何让收益惠及弱势群体,列为治理框架的一部分。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考