Qwen 云栖大会密集更新语音模型系列,实时翻译、全模态交互与全双工语音丨日报
本期编辑:@三水、@鲍勃
01 有话题的技术
1、阿里云栖大会期间 Qwen 连发两款实时语音模型:Qwen3.8-Omni-Flash-Realtime 加入多通道音频、视频聚合与远程 MCP,Qwen-Audio 3.1 Realtime Plus 新增 8 个系统音色
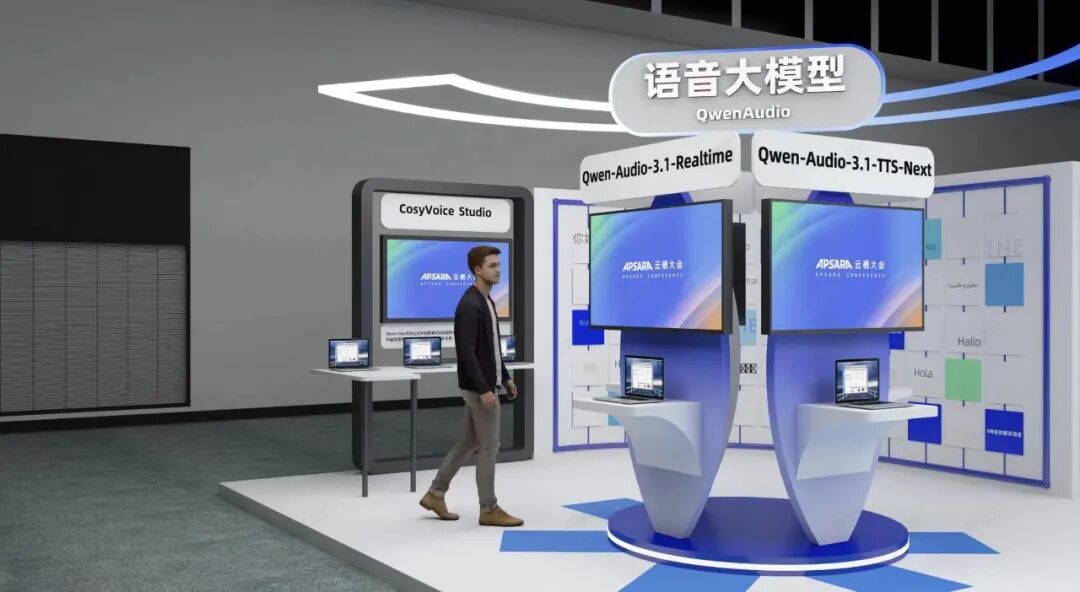
近 4 日,Qwen 密集更新实时 Voice AI 产品线。前两日发布实时音视频翻译模型 Qwen3.8-LiveTranslate-Flash-Realtime 后,现又上线 Qwen3.8-Omni-Flash-Realtime 和 Qwen-Audio 3.1 Realtime Plus,分别补全实时全模态交互与端到端全双工语音两条能力线。其中,Qwen3.8-Omni-Flash-Realtime 面向实时音视频交互,在已有文本/音频输出基础上新增多通道音频输入、视频聚合和远程 MCP,并支持 WebSocket、WebRTC 和 AOQ;Qwen-Audio 3.1 Realtime Plus 则延续 3.0 Plus 的接入协议,新增 8 个系统音色。
同时剧透会发布一个首次亮相的新模型——Qwen-Audio-3.1-TTS-Next ,将呈现 Qwen Audio 从语音生成迈向通用音频生成的最新进展:根据一段脚本生成包含语音及完整环境声场的音频,并支持细粒度时间戳控制、声音复刻和 48 kHz 输出,满足有声书、影视剧和播客等专业创作需求。
Qwen3.8-Omni-Flash-Realtime 把实时交互从单路语音扩展到音视频 + 空间音频: WebSocket 下支持 1、2、4 通道 PCM 输入,其中 2 通道可用于麦克风阵列、4 通道支持 FOA Ambisonics;视频侧新增 representation aggregation,可在不需要细粒度视觉信息时压缩视频表示、降低计算量。
远程 MCP 被直接接进实时会话: 开发者可以在
session.tools中配置公网 HTTPS MCP 服务,由模型完成工具发现、审批和调用;Function Calling 与 MCP 可以同时配置,但不能和 Web Search 同时开启。接入协议覆盖 WebSocket、WebRTC 和 AOQ: WebSocket 适合服务端集成,WebRTC 面向浏览器低延迟实时音视频,Qwen3.8-Omni-Flash-Realtime 的单次 WebSocket 会话最长可到 120 分钟,音频上下文最多 100 轮 / 600 秒。
Qwen-Audio 3.1 Realtime Plus 全双工语音体验继续扩展: 沿用 3.0 Plus 的 WebSocket 事件协议,保留语义 VAD、Function Calling、Web Search 和声音克隆,并新增 8 个系统音色;开发者从 3.0 Plus 迁移时主要只需切换模型名。
https://docs.qwencloud.com/changelog/models
2、Kyutai 基于 GLM-4-Voice 发布语音推理模型 Voice of Reason:首次将强化学习用于语音原生数学推理,不加额外推理 token 也将 GSM8K 提升至 65.5%
Kyutai 基于 GLM-4-Voice 做了一版更会「算题」的语音模型 Voice of Reason:模型可以直接听语音题目并用语音回答,不需要先转成文字再交给文本模型。团队先用数学语音问答数据训练,再加入强化学习,把 GLM-4-Voice 在数学文字题推理数据集 GSM8K 上的准确率从 27.3% 提升到 65.5%;进一步加入 STITCH 的「边说边想」方式后,最高达到 77.1%。
这也延续了 Kyutai 从 Moshi 开始探索的方向:Moshi 主要解决语音模型如何做到低延迟、全双工地边听边说,而 Voice of Reason 开始进一步补上复杂推理能力,让实时语音模型不仅能「边听边说」,也能尝试「边说边想」。
不额外加入隐藏的思考过程,强化学习也能明显提升算题能力: GLM-4-Voice 经过训练和强化学习后,GSM8K 从 27.3% 提升到 65.5%,已经超过此前只使用 STITCH 的 58.7%。这说明语音模型不一定要增加额外的思考步骤,本身也可以通过强化学习变得更会推理。
STITCH 让模型可以「边说边想」: 它不是等整段推理完成后再开口,而是让模型说一小段、内部继续想一小段,把思考穿插在语音生成过程中。结合强化学习后,GSM8K 达到 74.8%;取消默认的 top-k=50 解码限制后进一步达到 77.1%。
强化学习版本的平均回答时长缩短:不使用 STITCH 时,平均时长从 41.9 秒降至 36.4 秒;生成语音经 ASR 转写后的答题准确率从 61.5% 升至 63.9%。
https://x.com/kyutai_labs/status/2102080831242060123
https://arxiv.org/abs/2609.18677
3、语音 AI 公司 Freya 发布 TTS 模型 Adam / Eve:Adam 在 AudioRealismBench AI 模型中排名第一,API 开始分批开放
Freya 发布两款英语 TTS 声音 Adam 和 Eve,并开始开放 API 申请。其中 Adam V1 在 Design Arena 的 Audio Realism Benchmark 中获得 1419 Elo,在参测 AI 模型中排名第一,仅次于真人语音基线 1462。该评测让母语听众盲听相同文本生成的两段语音,并选择哪一段更像真人。
Adam V1 在真人感盲测中位列 AI 模型第一: 截至 9 月 16 日榜单,Adam V1 的 Elo 为 1419,高于 Bland Speech v3、Cartesia Sonic 3.6、Eleven v3 Conversational、Grok TTS 等参测模型。这里更准确的表述是「AI 模型中第一」,而不是已经超过真人。
评测重点为「听起来是否像真人」: Audio Realism Benchmark 使用固定美式英语提示词、原生英语听众和成对盲测,再通过 Bradley–Terry 模型计算 Elo。
Adam 和 Eve 已进入 API 开放阶段: Freya 官网目前提供两款英语声音,通过同一个 API 使用,但访问仍采用申请后分批开放的方式。
https://x.com/TungaBayrak/status/2102069626762932680
https://www.freyavoice.ai/
4、清华孵化全模态交互公司聆芯智语发布声音设计 TTS 模型 LingX-TTS:可按场景与角色控制表达,并主动生成笑声、咳嗽等副语言
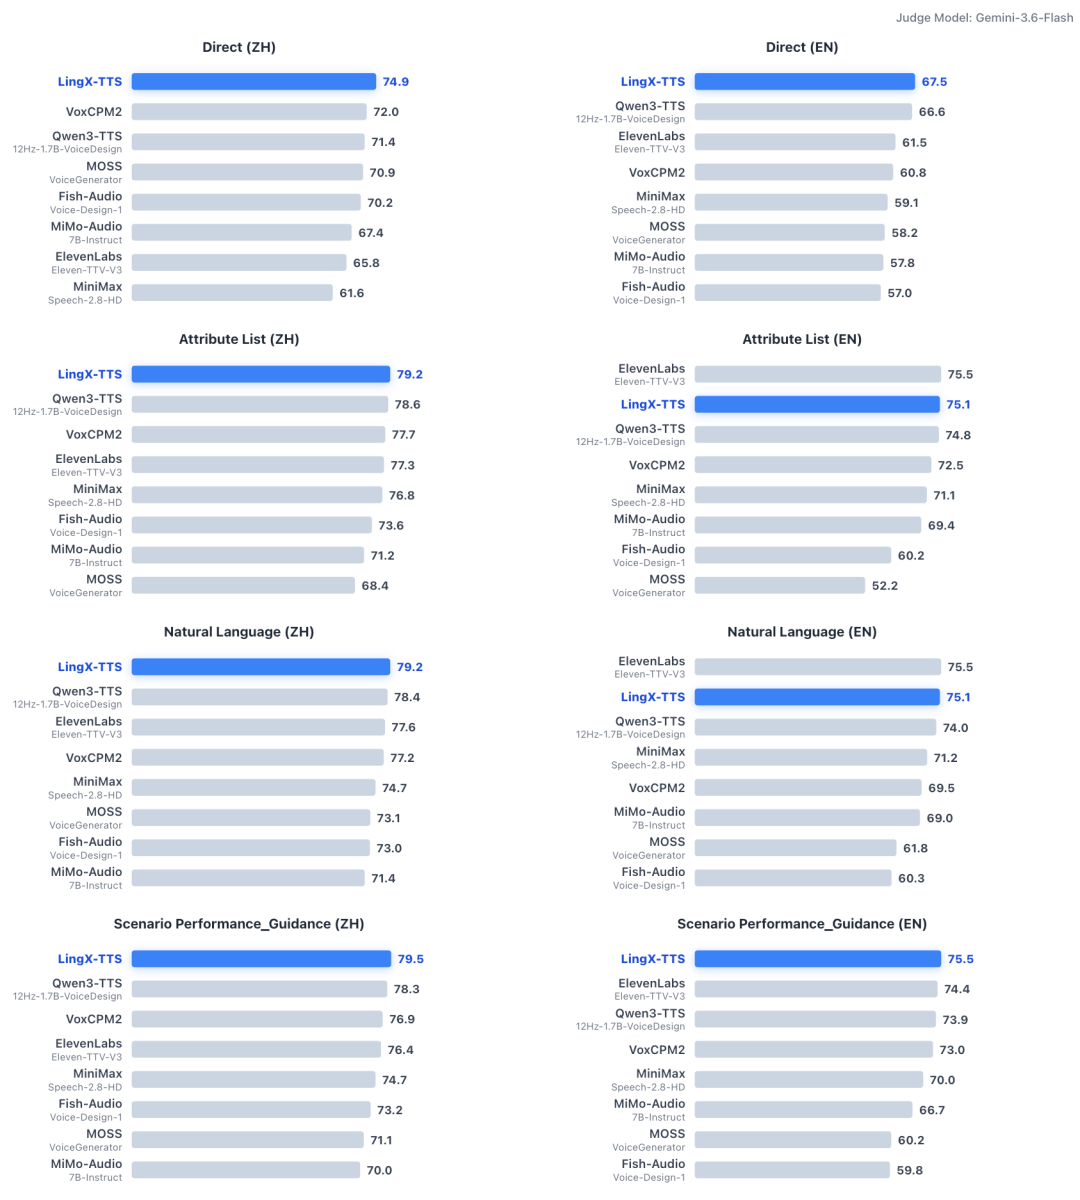
聆芯智语发布高表现力语音生成模型 LingX-TTS,用户可用自然语言描述角色、场景和说话方式,控制生成语音的情绪与韵律。模型还可根据上下文生成笑声、叹息、咳嗽等副语言声音。
把 TTS 控制从离散参数扩展到场景化声音设计: LingX-TTS 面向不同粒度的自然语言指令训练,可同时理解角色、场景、情绪和说话方式,并将这些条件组合成完整的语音表达,而不是只接受
happy、语速、音高等单独参数。副语言可以由模型根据上下文主动生成: 除了按指令控制语气,模型还可以根据场景自行加入笑声、叹息、咳嗽、哈欠和呼吸等非文字声音。官方称,在 NVV-SuperBench 上其副语言生成表现仅次于 Gemini-TTS。
中文指令遵循是这次重点指标之一: 官方公布 LingX-TTS 在 InstructTTSEval 中文测试中得分 72.1,英文为 64.2;在自建 ExpressTTS-Bench 中,中文的空指令、属性列表、自然语言描述和场景化表演指导四项均获得最高分。
训练加入强化学习优化「怎么说」: 训练流程采用 Pretraining → SFT → GRPO,强化学习阶段同时优化内容准确、音频质量、指令遵循和表现力;数据侧则重点构造包含身份、场景、情绪、韵律和副语言组合的高表现力语音样本。
https://lingx.cn/playground
https://lingx.cn/tts.html
5、端侧 AI 推理公司 Argmax 等研究者提出长文本 TTS 推理方法 LACI:不重训模型,Qwen3-TTS 1500+ 词最差 WER 从 35.2% 降至 3.4%
端侧 AI 推理公司 Argmax 等研究者提出 LACI(Localized Attention-Constrained Inference),用于解决 Qwen3-TTS、VoxCPM2 等自回归 TTS 在超长文本生成中容易出现的跳读和幻觉问题:生成过程中持续监控音频与文本的注意力对齐,一旦检测到异常,就回滚到错误起点,并临时施加注意力约束重新生成。
LACI 在推理阶段局部修正长文本生成异常:检测到异常后,方法回滚到失败起点,短暂限制注意力范围并重新生成,无需重训模型或重新生成整段语音。
Qwen3-TTS 的超长文本稳定性提升最明显: 在 1500+ 词文本上,Qwen3-TTS-0.6B 的 worst-of-10 WER 从 35.2% 降至 3.4%,说明这类长文本失败更像是少量灾难性生成,而不是整体语音质量均匀下降。
长参考音频的声音克隆也更稳定: 在 120 秒参考音频条件下,Qwen3-TTS-0.6B-Base 的灾难性生成比例(WER > 30%)从 26% 降到 1% 以下。
方法并非对所有模型同样有效: 在 VoxCPM2 上,LACI 将超长文本失败率从 70% 降到 57%,提升明显弱于 Qwen3-TTS,说明部分长文本失稳可能来自更深层的模型一致性问题,而不是单靠注意力约束就能完全解决。
https://x.com/RmdW_W/status/2102032894600401231
https://arxiv.org/abs/2609.16989
6、端侧 AI 公司 M87 Labs 发布三值 ASR 模型 Parakeet Redux:将 NVIDIA Parakeet 从 1.2 GB 压到 178 MB,8 核 CPU 达 113× 实时转写
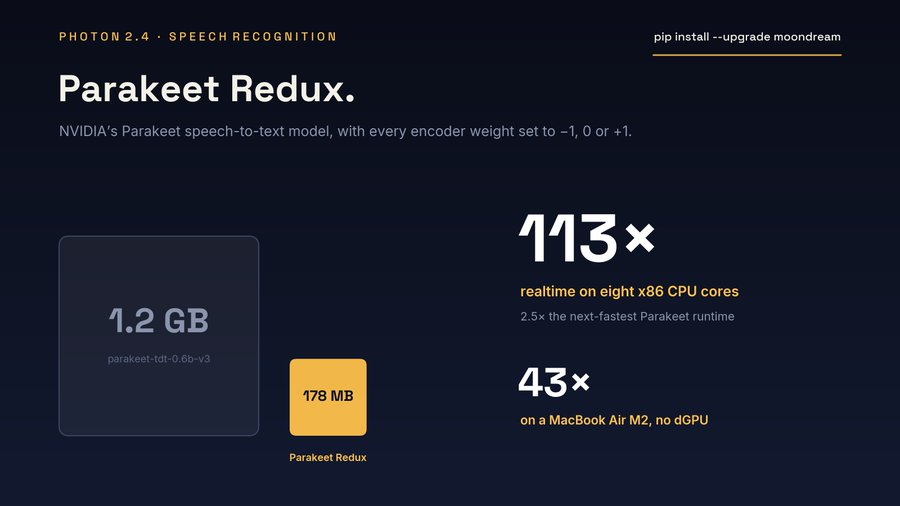
M87 Labs 基于 NVIDIA Parakeet-TDT-0.6B-v3 发布 Parakeet Redux,把编码器权重量化成 -1 / 0 / +1 三种取值,在保持原架构和 tokenizer 不变的情况下,将模型权重从 1.2 GB 压缩到 178 MB。配合其 Photon 推理引擎,官方测试中在 8 个 x86 CPU 核心上达到 113× realtime,同时在英文基准上与原模型保持接近的 WER。
核心变化是把 Parakeet 做成 1.58-bit 三值模型: 每个编码器权重只有
-1、0、+1三种状态,模型体积缩小约 85%;由于 CPU 推理经常受内存带宽限制,这种压缩也减少了推理时需要搬运的权重数据。8 核 x86 CPU 上达到 113× 实时: 在 AMD EPYC 9575F 的 8 个物理核心上,Parakeet Redux + Photon 达到 113× realtime;同机测试中,parakeet.cpp Q8 为 45×、sherpa-onnx INT8 为 42×。这个数据对应特定服务器 CPU 和测试条件,不代表所有 8 核设备都能达到相同速度。
极限压缩没有明显牺牲英文准确率,多语言反而提升: Open ASR Leaderboard 的 7 个英文测试集平均 WER 从原版的 6.26% 变为 6.55%,相差 0.29 个百分点;25 种语言的 FLEURS 平均 WER 则从 11.62% 降到 10.56%,长音频 TED-LIUM 测试也从 2.71% 降到 2.51%。
代价主要出现在噪声环境: 9 组加噪测试的平均 WER 从原版 6.72% 上升到 9.04%,说明三值编码器在低信噪比下更容易把相似发音的词识别错。
https://huggingface.co/moondream/parakeet-redux
02 有亮点的产品
1、阿里实时交互开放式世界模型 HappyOyster 新增 Acting 角色演绎模式:可与生成角色实时交流,扩展至三种交互方式
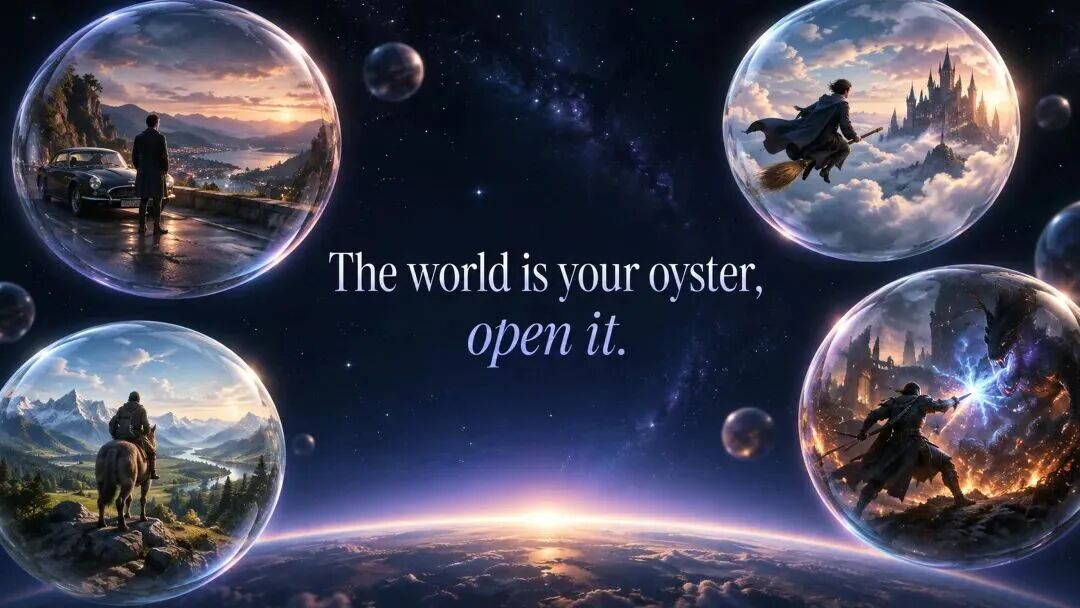
阿里实时交互开放式世界模型 HappyOyster 目前提供 Adventure 世界探索、Directing 实时导演、Acting 角色演绎三种交互模式。相比此前主要开放的 Adventure 和 Directing,这次新增的 Acting 把交互对象从「生成世界」和「视频剧情」进一步扩展到「生成角色」:用户可以和角色面对面实时交流,角色会通过语音、表情和动作即时回应。该模型目前处于邀测阶段。
Adventure|世界探索: 输入文字和首帧图生成可探索的世界,用户可以第一或第三人称移动、战斗、骑乘,并实时控制方向、视角和动作,支持 1 分钟以上连续交互。
Directing|实时导演: 视频一边生成,用户一边通过文字指令改变人物动作、镜头和剧情,还可以暂停、回溯到之前的时间点重新演绎,最长可连续生成约 3 分钟。
Acting|角色演绎: 用户可以与生成角色面对面实时交流,角色会根据输入即时通过语音、表情和动作完成演绎,更接近实时数字人、AI 陪伴等交互场景。
三种模式均已提供开发者接入: HappyOyster 分别提供对应 Open API,并通过客户端 SDK 建立实时音视频和交互链路,可用于可玩世界、互动剧、AI 陪伴等应用。
https://www.happyoyster.cn/
2、DeepNovaCore 发布开源语音智能体 NovaAudioAgent v0.2:语音对话不中断后台任务,新增长期记忆与可插拔语音链路
DeepNovaCore 开源语音智能体 NovaAudioAgent v0.2,让实时对话和后台任务并行运行:用户可以一边和 Nova 继续说话,一边让 Codex 在后台写代码、执行任务或管理工作区;任务有重要进展时再主动播报,普通过程则保持安静。v0.2 进一步加入可配置的 ASR / LLM / TTS、个人记忆、MCP 和 iPhone 远程接入。
说话和干活可以同时进行: 用户把任务交给后台执行后,不需要等待任务结束,可以继续补充要求、修改方向或聊其他内容;Nova 会把新的语音要求继续传给正在运行的任务。
不是所有后台进度都要打断用户: Nova 单独设置了一层判断「这件事值不值得现在说」,重要进展和异常会主动播报,普通进度保持安静,也尽量避免在用户正在说话时插嘴。
v0.2 把语音链路拆开了: ASR、LLM、TTS 不再绑定单一实时语音模型,可以分别配置;同时支持接入自定义 MCP,用于搜索、RAG 和外部工具。
加入跨会话个人记忆和远程使用: v0.2 通过 mem0 / VoiceMem 保存可追溯的个人记忆,还可以通过 Tailscale 从 iPhone 连接到电脑上的 Nova,继续语音对话并确认后台任务。
https://deepnovacore.github.io/NovaAudioAgent/
03 有态度的观点
1、Anthropic、OpenAI、SpaceX 和 Google 因「放缓 AI 开发」表态遭反垄断诉讼
据 Seeking Alpha 和界面新闻报道,4 名 ChatGPT、Claude、Grok 和 Gemini 付费用户的律师已在加利福尼亚州提起反垄断诉讼,将 Anthropic、OpenAI、SpaceX 和 Google 列为被告。
原告指称,4 家公司的高管近期先后公开表态应放缓前沿 AI 开发,这些言论构成协调行动,可能减慢产品竞争与功能迭代,降低付费订阅的价值。这些目前只是诉状中的指控,现有公开报道尚未提供案件编号,4 家公司也未在报道中公开回应。
(@APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考