Retell 年化营收突破 1 亿美元,推出自研实时通话模型 Tell-1丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、AI 可穿戴公司 Looki 发布生活理解模型体系 Loom:串联感知、事件与长期记忆,让 AI 理解真实生活上下文
AI 可穿戴设备公司 Looki 介绍自研生活理解模型体系 Loom,面向第一视角设备持续采集的视觉、声音及环境数据,将日常记录整理为可供 AI 检索和调用的结构化上下文。Loom 采用 Sense、Moment、Memory 三层架构,不仅识别用户当下正在做什么,还尝试记录事件的发生过程、关键决定及其原因,为长期陪伴式 Personal Agent 提供记忆基础。
Sense:持续识别日常活动与环境状态。 通过专门训练的判别式模型判断用餐、交谈等近 20 类日常活动,并结合历史时段的信息减少识别结果抖动。据团队测试,活动识别 F1 分数为 88.6%,单次判断平均耗时 0.51 秒。
Moment:将连续视听数据整理为完整事件。 对不同时刻的视觉和音频进行时间对齐,识别一次经历的开始与结束,生成包含关键事实、时间戳和原始证据的事件描述,而不是简单按固定时长切分视频。
Memory:通过分层检索构建长期记忆。 将生活事件组织为日、周、月总结及长期记忆。回答用户问题时,系统可先检索摘要,再逐层追溯具体事件和原始记录。团队自测记忆评测得分为 79.0,比 mem0 高 18 分,单个问题的平均 Token 处理量约为后者的 14.5%。
优先服务 Looki 软硬件生态: Loom 目前由多个专用模型与记忆检索系统协同工作,未来计划进一步整合为端到端多模态模型。现阶段尚未开放独立模型 API 或模型权重。
(@Looki 团队)
2、Higurashi AI 开源 4B 全双工语音模型 Haru:133ms 音频分块,支持日英中等 9 种语言及自然笑声
语音 AI 团队 Higurashi AI 发布并开源全双工语音对话模型 Haru-4B,支持在持续聆听用户讲话的同时生成语音回应。模型基于 Qwen3.5 语言模型构建,采用连续音频表示和单步生成架构,能够处理重叠发言、接话及角色化语音表达。项目已开放 Apache 2.0 许可的模型权重与推理代码,并提供 NVIDIA GPU、Apple Silicon 和 vLLM-Omni 三种运行方案。
133ms 分块实现原生全双工: Haru 以 7.5Hz 频率处理音频,每 133ms 同时接收用户语音,并生成模型的文本与语音。用户音频、模型音频和文本在同一个语言模型位置融合,无需等待用户发言结束。
连续音频表示减少生成步骤: 使用 VibeVoice 因果音频编码器,将 24kHz 语音转换为每帧 64 维连续表示,再通过 MeanFlow 与轻量 MLP 头单步生成音频,不依赖独立的音频 Transformer 或离散音频 Token 预测。
开放 9 种语言与多种部署方案: 支持英语、日语、中文、韩语、西班牙语、葡萄牙语、德语、法语及俄语。开发者可通过角色描述定义人物性格,使用参考音频设定声音,并在约 12GB 显存的 NVIDIA GPU 上运行,也可通过 MLX 在 Apple Silicon 上部署。当前属于研究型预训练基础模型,尚不具备可靠的知识问答和复杂指令执行能力。
https://github.com/higurashi-ai/Haru
https://blog.higurashi.ai/melte/haru4b/
3、Liquid AI 开放 7400 万参数流式音频编解码器 LiquidCodec:单核 CPU 编码速度达实时 361 倍,解码达 87 倍
Liquid AI 发布并开放流式音频编解码器 LiquidCodec,这是 LFM3-Audio-2B 和 LFM3-Omni-2B 使用的音频 Tokenizer。该模型约 7400 万参数,可将连续语音转换为供语言模型预测的离散 Token,再将 Token 还原为音频。团队重点优化语音重建质量、Token 预测效率与端侧推理速度,以降低实时语音模型的音频处理开销。
单核 CPU 编码与解码速度达实时 361 倍、87 倍: Liquid AI 在 Apple M4 Max 单个 CPU 线程、FP32 精度下测得,LiquidCodec 编码和解码的实时因子分别为 0.0028 和 0.0115。相比 Mimi,编码约快 13 倍,解码约快 2.9 倍,以上均为官方测试结果。
12.5Hz 流式音频表示支持并行预测: 模型采用基于 LFM3 的因果编码器与解码器,以 24kHz 处理语音,每 80ms 生成一帧,包含 12 个音频 Token。通过分组有限标量量化(GFSQ)降低码本之间的顺序依赖,使语言模型能够并行预测一帧中的多个码本。
开放权重并支持端侧量化部署: LiquidCodec 在官方 8 个语音重建测试集上取得较好的音质指标;解码器经过量化感知训练后,Q4_0 版本体积缩小约 3.5 倍。开发者可通过 Hugging Face Transformers 使用 BF16 权重,量化版本随 LFM3-Audio 与 LFM3-Omni 的 GGUF 模型提供,采用 LFM Open License v1.0。
https://www.liquid.ai/blog/liquidcodec
https://x.com/liquidai/status/2120947649994228088
4、Keyframe Labs 实时数字人模型 persona-2.0-live 全面开放:支持词级表情控制,最低每分钟 0.06 美元
实时数字人技术公司 Keyframe Labs 宣布,旗下 persona-2.0-live 正式结束预览阶段,向所有套餐用户开放。模型支持在 AI 角色讲话过程中,按照具体词语或短语调整面部表情,并结合实时语音生成口型、头部动作和细微表情,面向 AI 教育、客服及陪伴等需要面对面交互的应用。
支持词级表情与情绪控制: 开发者可在语音或 Agent Prompt 中加入情绪标签,让虚拟角色在指定语句处表现开心、惊讶、担忧等情绪,也能通过 SDK 进行更细粒度的控制。
官方盲测中情绪识别表现提升 2.2 倍: Keyframe Labs 发布 EmoteBench 评测,在涉及 250 名参与者、19500 次判断的测试中,其角色表情被正确识别的比例达到 81%,最接近的参测产品为 37%;情绪切换识别成功率为 53%,约为最接近竞品的 4 倍。测试由 Keyframe Labs 自行设计与开展。
开放 API 与 SDK,支持大规模并发: 官方公布模型首字节延迟约 180ms,可对接 OpenAI、ElevenLabs、Fish Audio 等语音与语言模型,并提供 JavaScript SDK 和 LiveKit 集成方案。服务支持数千路并发会话,起步价格为每分钟 0.06 美元。
https://platform.keyframelabs.com/
02 有亮点的产品
1、Google Antigravity 上线 Voice Mode:基于 Gemini Live,开发者可通过语音指挥 Coding Agent 编写代码和执行任务
Google 为 AI 编程工具 Antigravity 推出 Voice Mode,基于 Gemini Live 实现双向实时语音交互,支持开发者边查看代码、边通过语音向 Coding Agent 分配任务、修改要求或询问执行进度。该功能同时覆盖 Antigravity 桌面应用与 CLI,语音对话会继承当前会话上下文,Agent 仍可正常读取文件、修改代码及运行命令。
Gemini Live 支持实时语音对话与打断: 直接处理用户音频并生成语音回应,允许开发者随时插话、补充条件或调整正在执行的任务。语音内容会同步显示在会话界面中,并在结束后保留文字记录。
语音控制 Coding Agent 的执行流程: 开发者可以口头要求 Agent 修复代码、停止任务、查询进度,或回答非破坏性操作的权限确认。涉及删除文件、提权执行或强制推送等高风险操作,仍需在界面中手动批准。
桌面端与 CLI 均已提供入口: 桌面应用可直接点击 Voice Mode 按钮;Antigravity CLI 1.5.0 及以上版本支持通过
/voice live启动,并提供/voice duplex on、/voice speaker等控制指令。该功能正在逐步开放,部分用户可能暂时看不到入口。
https://antigravity.google/blog/antigravity-voice-mode/
2、Fish Audio 推出零代码语音 Agent 平台 Fish Agent:支持电话呼入呼出,集成全双工模型 Live 3
语音 AI 公司 Fish Audio 宣布推出 Fish Agent,面向开发者和企业提供无需编写代码的语音智能体构建平台。用户只需使用自然语言描述 Agent 的角色和任务,即可生成可测试的语音助手,并将其部署到电话、网站或应用中。平台集成此前发布的全双工语音模型 Live 3,Fish Audio 称其 Agent 部署时间中位数为 32 秒。
自然语言创建语音 Agent: 用户可通过文字描述或预设模板配置 Agent 的角色、目标和对话规则,选择语音模型、声音及 LLM,也能接入自定义 LLM。平台支持通话模拟测试、版本管理及对话质量分析。
支持电话与 Web 多渠道部署: 开发者可申请电话号码或连接已有号码,让 Agent 自动接听、拨打电话,也可通过 WebRTC、React SDK 或网页组件接入应用,覆盖客服、预约、订单处理及个人电话助理等场景。
集成 Live 3 与外部业务工具: 平台支持全双工语音交互,使 Agent 能够在讲话时持续聆听,识别附和、打断和用户临时修改的要求。同时提供 API、Webhook、知识库和工具调用能力,可连接日历、CRM 等业务系统。
已开放使用并提供试用额度: Fish Agent 提供 5 美元免费试用额度。官网当前公布限时基础价格为每分钟 0.035 美元,电话接入、专用号码和高级 LLM 另行计费,开发者可通过官网直接创建 Agent。
https://fish.audio/agents/
3、语音 Agent 平台 Retell 年化营收突破 1 亿美元:月处理超 1 亿通电话,推出自研实时通话模型 Tell-1
AI 语音客服平台 Retell 宣布年化营收运行率(Annualized Run Rate)突破 1 亿美元,在 17 个月内从 1000 万美元增长至 1 亿美元。公司目前服务超过 4000 家企业,每月处理超过 1 亿通电话,累计融资仅 460 万美元,并已实现盈利。同日,Retell 发布面向实时呼叫中心场景的自研语言模型 Tell-1,重点优化电话交流中的推理速度、对话连续性和工具调用。
17 个月内实现 10 倍年化营收增长: Retell 自 2023 年成立以来累计融资 460 万美元,2026 年企业客户业务收入增长 9 倍。平台目前服务 Lenovo、BILL、CVS Health 等企业,支持客户自行构建、测试、部署及持续优化语音 Agent。
Tell-1 针对真实电话场景优化: 据公司介绍,模型使用数亿通电话数据训练,采用交错推理(Interleaved Reasoning)架构,能够在生成回应的过程中持续判断业务规则、补充缺失信息和调用工具,处理用户中途改口、话题切换及不完整回答。
官方测试响应时间低于 100ms: Retell 称 Tell-1 在其公开 vCX Benchmark 中取得综合第一,重点覆盖指令遵循、事实一致性、工具调用、口语自然度和延迟等指标。目前测试响应时间低于 100ms,系统目标是在高峰负载下保持低于 300ms。该指标并非完整电话端到端语音延迟。
同步推出 Retell Dialer: 新产品支持统一编排 AI 语音与短信 Agent 的外呼任务,可根据通话结果安排回拨、转交专业 Agent 或发送短信跟进,并提供号码轮换、呼叫时段控制、垃圾电话监测及 CRM 集成。
https://www.retellai.com/blog/retell-100m-revenue-run-rate
03 有态度的观点
1、前字节、美团招聘负责人魏小康谈 AI 人才泡沫:高薪要看能解决什么问题
在《晚点 LatePost》的访谈中,曾参与搭建字节跳动招聘体系、负责过美团招聘的魏小康说,衡量大模型人才的薪酬,应该先看他们能解决什么问题。基座模型训练需要大量算力,少数核心研究者做的决定,会影响训练资源的使用效率,甚至决定模型能不能做出来。
魏小康回忆,早期「百模大战」推高了研究员薪酬,一些公司花高价组队,招来的人却无法完成大模型研发。他认为,这类投入才是人才泡沫。随着基座模型竞争收敛到少数公司,即使有顶级论文和头部模型厂实习经历,毕业生也可能更难拿到面试机会。谈到资源有限的团队如何把基座做出来,魏小康给出三项做法:由懂模型的人决定实验方向,允许试错但保持过程可检验;让算法、数据和基础设施人员一起工作;单独把训练数据的质量做好。
谈到应用团队时,魏小康主张缩小产研团队,让擅长使用 AI 的成员承担更大范围的工作。他认为,过去依靠大量招聘扩大组织的办法,在 AI 应用创业中会逐渐失去优势。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 在 RTE 开发者社区,一起动手给 AI 眼镜加个自己想用的功能!
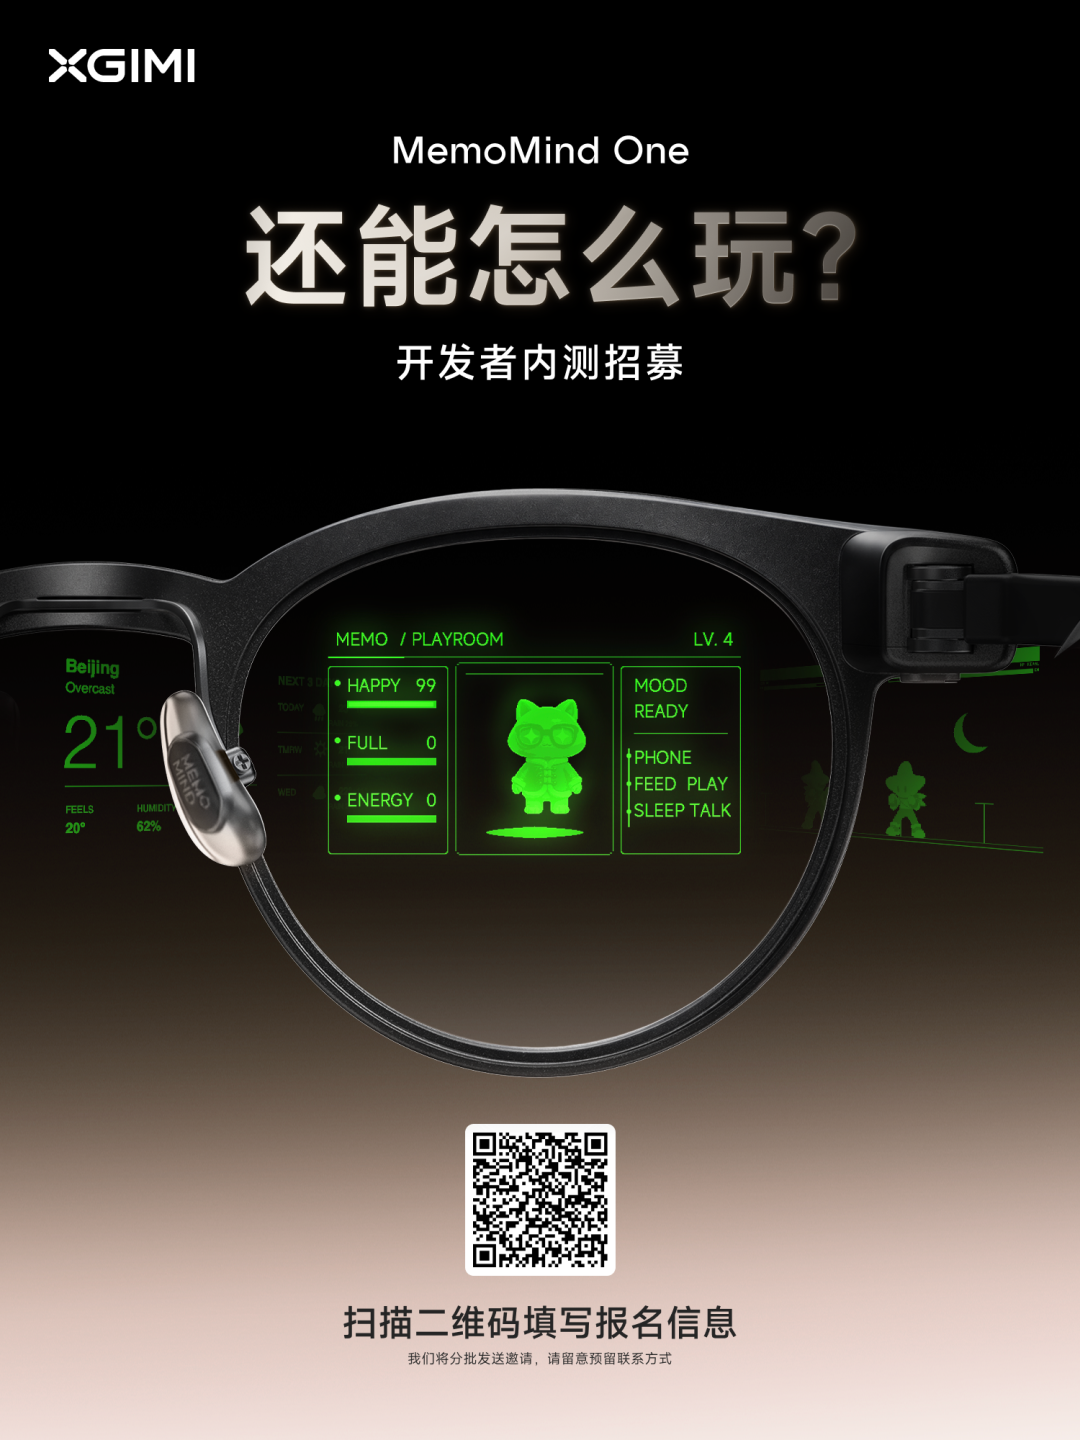
MemoMind One 开发者内测开启招募。 有个想在眼镜上实现的点子?可以先用 SDK 和模拟器把它做成应用,获邀开通白名单权限后,再到 MemoMind One 真机上跑一遍,看看实际佩戴时的体验怎么样。
 扫码报名想动手试试的伙伴,欢迎扫描海报二维码报名。MemoMind 团队将分批联系入选开发者并发送测试指引,请留意报名时填写的联系方式。
本期应用仅供开发者本人测试,暂不支持公开分发。
 开发资源
开发者平台:
https://cn-open-platform.memo-mind.com
开发者 SDK github:
https://github.com/memomind-open/plugin-open-platform
自然语言编程 skill:
https://github.com/memomind-open/plugin-open-platform/tree/main/.agents/skills
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考