Hume 发布音频决策 API,分析语气、情绪与环境声音,支持实时通话判断丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、情感语音 AI 公司 Hume 发布音频决策 API:直接分析语气、情绪与环境声音,支持实时通话判断
情感语音 AI 公司 Hume 发布 Audio Decision API,让开发者通过自然语言向原始音频提问,直接获得结构化判断结果及概率,无需先将语音转写为文本。模型基于超过 1000 万次人类听觉判断相关数据训练,支持识别说话人、情绪、背景声音及对话行为,可用于实时语音 Agent 和通话录音分析。
一个模型处理多种音频判断任务: 支持判断说话人数、用户是否沮丧、是否存在笑声或背景警报等,并根据开发者提供的候选答案返回概率,无需针对每种任务单独训练检测器。
支持实时分析与事件定位: 可在同一请求中执行多项判断,支持是非题、多选、评分和音频时间片段定位,帮助 Agent 识别情绪变化、重叠发言及需要澄清的时刻。
与人类群体判断一致率达 70.7%: Hume 初步评测中,模型与人类评审群体平均判断的一致率为 70.7%,单名人类评审的对照结果为 56.5%。目前提供在线演示,API 访问需申请。
https://www.hume.ai/blog/introducing-hume-audio-decision-api
2、语音 AI 公司 Tazo Labs 推出实时音频决策模型 Tazo:无需语音转写即可判断接话时机,模型延迟低于 200ms
语音 AI 公司 Tazo Labs 发布面向实时 Voice Agent 的音频决策模型 Tazo,直接根据通话音频和开发者提供的选项输出决策概率,无需经过 STT 转写。模型可在用户说话过程中判断何时回应、等待、附和、调用工具或转接人工,并作为独立 API 接入现有语音 Agent 系统。
直接从音频判断对话状态: 结合语气、停顿和语速等声音线索,在回应、等待、打断处理及人工转接等选项之间进行决策,支持自定义候选动作和概率阈值。
实际通话决策准确率达 70.9%: Tazo 团队报告,在生产通话数据测试中取得 70.9% 的准确率,对照 STT + Jev 方案为 46.4%;官方还称其在 MMAU 音频智能评测中排名第二。
模型延迟低于 200ms,API 已上线: 支持流式通话中的持续决策,并新增「以上皆非」选项处理超出候选范围或不确定的情况。开发者可通过 API 和现有 STT、LLM、TTS 组合使用。
https://x.com/namanjn1998/status/2117232948327936064
3、腾讯混元开源交互式世界生成模型 Hy-Nomas:支持多轮文本与镜头控制,单张 RTX 4090 可运行
腾讯混元开源交互式世界生成模型 Hy-Nomas,支持用户在视频生成过程中持续输入文本指令或控制镜头方向,逐步改变场景、物体及动作,并保持生成内容的时序一致性。项目开放训练与推理代码、模型权重及在线演示,近期还新增了参考图初始化功能。
多轮交互控制生成世界: 采用自回归分段生成架构,支持通过文本修改场景、角色和动作,或通过相机轨迹控制观察视角,并利用持续维护的 KV Cache 保持不同视频片段之间的一致性。
新增参考图初始化与实时交互支持: 10 月 31 日,在线 Demo 新增上传图片初始化世界的功能;社区已通过 SGLang 和 Reactor Runtime 实现流式视频生成、实时修改提示词及键盘镜头控制。
支持单张 RTX 4090 部署与 LoRA 微调: 通过 INT8 模型量化、KV Cache 压缩及 CPU 卸载降低显存需求,支持单卡推理,并提供训练、数据标注和 LoRA 微调代码,采用 Apache 2.0 许可证开源。
https://github.com/Tencent-Hunyuan/Hy-Nomas
4、开源本地 AI 推理工具 Strata :8GB 显存支持 Qwen3.8-Flash-Next 的 128K 上下文,优化多 GPU 并行推理
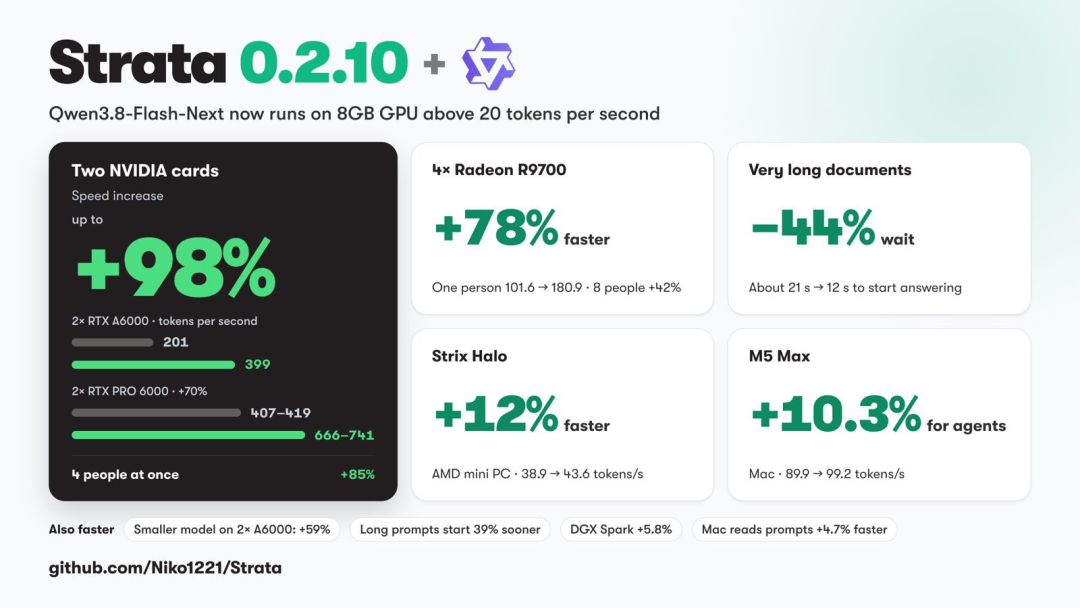
开源本地 AI 推理工具 Strata 发布 0.2.10 版本,进一步降低 Qwen3.8-Flash-Next 的部署显存需求,使配备 8GB 显存的设备能够启动 128K 上下文推理。同时将 DFlash2 设为默认推测解码方案,并引入多 GPU 协同计算优化,提升本地模型生成速度和并发处理能力。
8GB 显存支持 128K 上下文: 通过缩减 GPU 上的 KV Cache、降低缓存占用及将部分计算卸载至系统内存,保持 131,072 tokens 的上下文长度。官方已在 Intel Arc A750 8GB 显卡上完成启动测试。
默认采用 DFlash2 推测解码: 在支持的设备上使用约 0.7GB 的轻量级推测模型,替代约 5.2GB 的 MTP 模块。官方测试中,部分硬件的文本生成速度提升约 4%–12%。
新增多 GPU 协同推理优化: Linux 版本支持将模型各层分布至多张显卡并行执行。在双 RTX A6000 测试中,代码编辑任务的生成速度从 195 tokens/s 提升至 377–394 tokens/s,并改善多请求并发性能。
https://github.com/Niko1221/Strata
02 有亮点的产品
1、AI 客服平台 Chatbase 发布 Voice 2.0:语音模型负责实时听说,Opus 5.5 等大模型负责推理与工具调用
AI 客服平台 Chatbase 发布 Voice 2.0,将原生语音交互与前沿 LLM 的推理能力结合。语音模型负责实时听取用户讲话并生成自然语音回复,同时将复杂推理交给 Claude Opus 5.5 等模型处理,使 Voice Agent 在保持低延迟对话体验的同时,能够遵循业务流程、调用工具并执行客服任务。
语音交互与复杂推理分工: 语音模型承担听说交互,前沿 LLM 负责业务判断和任务执行,结合原生语音模型的自然表达与传统 STT → LLM → TTS 架构的工具调用能力。
支持业务流程与工具调用: 可复用 Chatbase 现有的 Procedures、Actions 和 Guardrails,处理订单查询、预约修改、退款及人工转接等客服流程,并遵守预设业务规则。
支持实时打断与多语言通话: 官方介绍支持 95 种以上语言,用户可在通话中打断、改变问题或切换语言。Voice 2.0 已开放在线体验。
https://chatbase.co/voice
2、前百川智能联合创始人焦可推出 Voice-native Personal Agent Orilo:边聊边执行任务,支持主动信息追踪
前百川智能联合创始人焦可带领团队推出语音优先的个人智能体 Orilo,以个性化晨报为日常交互入口,结合长期记忆、实时语音对话和跨应用工具调用,让用户在收听资讯时随时插话、安排任务。产品延续了团队此前 AI 个性化电台「来福」的探索,进一步从音频内容服务扩展到个人 Agent。
从个性化晨报切入日常语音交互: 根据用户兴趣、历史对话和个人背景生成资讯简报,并结合日历、邮件等信息提供提醒。用户可以随时打断播报、追问新闻,也可以指定需要长期关注的事件,由 Agent 持续追踪并主动汇报。
实时对话与后台任务并行: 据量子位报道,Orilo 采用双层架构,由低延迟语音模型负责听说、情绪感知与打断处理,高推理能力 Agent 在后台完成邮件查询、日历创建等工具调用。执行任务期间,前端仍能继续对话,减少等待造成的交互中断。
通过语音完成跨应用操作: 连接邮箱、日历和待办工具,支持读取并总结邮件、回复邮件、添加日程及设置提醒。例如,在晨报中发现学校临时通知后,用户可以直接通过语音将相关安排加入日历。
由 AI 电台向 Personal Agent 延伸: 焦可于 2025 年创办「来福电台」,此前主要提供个性化 AI 音频内容。据报道,来福曾达到数十万用户规模,次日留存率约 50%。Orilo 目前已登陆 iOS 和 Android,现阶段主要支持英文交互。
https://www.orilo.live/
3、NVIDIA 工程师用 Nemotron 打造实时语音互动鬼屋 MonsterHouse:语音驱动 3D 表情,缓存回复延迟约 0.72 秒
NVIDIA 工程师 Rick Grandy 分享万圣节互动项目 MonsterHouse,将车库门改造成能够听懂访客、实时说话并同步表情的虚拟角色。项目基于 NVIDIA Nemotron Voice Agent,组合语音识别、小型语言模型、零样本 TTS 与 Audio2Face-3D,在一台双 GPU 工作站上完成本地语音交互和实时动画。
串联语音与 3D 动画模型: 使用 Nemotron 3 ASR 识别访客语音、Nemotron 3.5 Bolt E4B 生成回答、Magpie TTS Zeroshot 合成角色声音,再通过 Audio2Face-3D 在 Unreal Engine 5 中驱动嘴部动画。
通过 LoRA 微调角色性格与对话流程: 团队构建超过 5000 组多轮对话样本训练 LoRA,让角色根据访客是否说「请」和「谢谢」等表达调整态度,同时由应用逻辑维护交互状态。
缓存回复将响应延迟降至约 0.72 秒: 官方实测中,完整语音生成链路从用户结束说话到开始播放音频的中位延迟为 1.70 秒,预先缓存的音频回复为 0.72 秒。系统由 RTX PRO 6000 Blackwell Max-Q 和 RTX PRO 4000 Blackwell 分别承担语音推理与图形动画。
加入视觉感知与访客追踪: 尝试结合 Nemotron 3 Nano Omni、YOLO 和 ByteTrack 识别服装及追踪访客。视觉部分仍需真实场景测试;MonsterHouse 项目代码尚未单独打包开源,但使用的 NVIDIA 模型及 Voice Agent 框架已开放。
https://huggingface.co/blog/nvidia/nemotron-halloween
03 有态度的观点
1、Omdia:AI 眼镜的差异化要靠可靠体验与服务整合
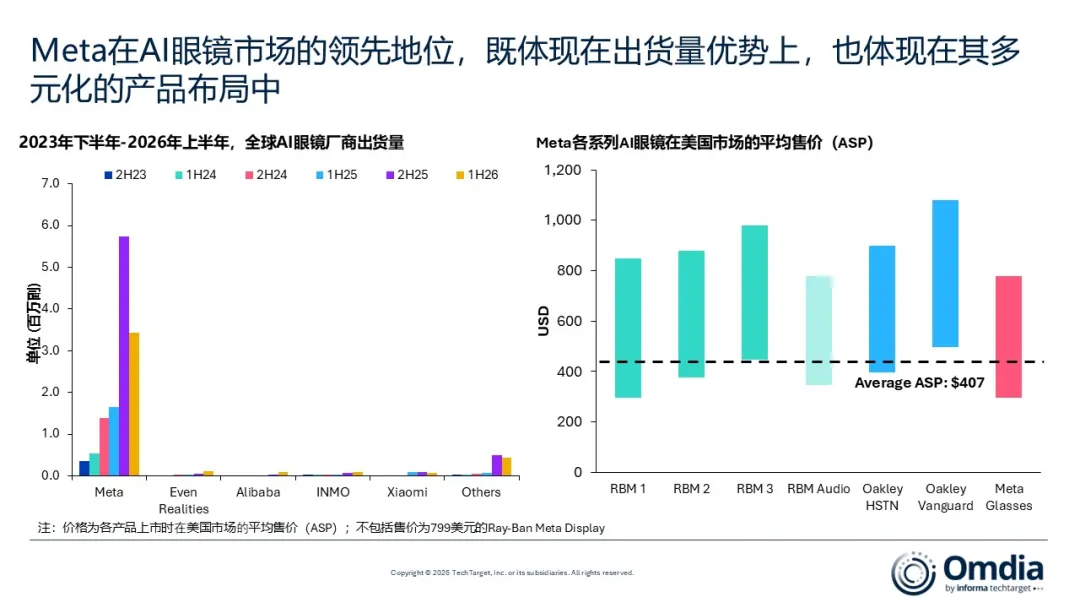
市场调研机构 Omdia 在最新分析中认为,随着个人 AI 智能体发展,AI 眼镜的竞争将从硬件进一步延伸到模型能力、跨设备和跨服务的整合,差异化的前提是提供手机难以实现的可靠、实用体验。该机构以 Meta 计划将个人智能体 Muse 引入 AI 眼镜为例指出,免手持交互和第一视角视觉信息,有助于智能体理解用户意图与环境,减少用户解释需求的负担;任务随后可由设备或云端处理,也可协调其他服务执行。
在该机构看来,这种即时、自然的交互,可能让消费者愿意把更多日常任务交给智能体,包括过去不会交给手机语音助手的任务。但可靠执行、清楚的安全边界与消费者对个人数据访问的信任,是智能体扩大应用的前提;Meta 过去的隐私争议会增加建立信任的难度。
Omdia 提出的竞争路径也不限于拥有自研模型的大公司:其他硬件厂商可与 OpenAI 等 AI 服务商合作,再用差异化硬件参与竞争。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 Ask Me Anything! 和蚂蚁百灵聊聊 Ming-3.0 语音模型
在 RTE 开发者社区,和最前沿的实时智能 builder 们对话!
TTS 的情绪和节奏怎么控制?长录音如何整理出共识与分歧?地方口音、产品名和专业术语怎样识别得更准?端侧语音模型如何部署?
围绕新发发布和开源的 Ming-3.0 语音系列模型,RTE 开发者社区邀请到蚂蚁百灵大模型语音算法负责人金春祥,用一小时微信群文字 QA 的形式,和大家聊聊模型能力、选型与实际接入中的问题。
欢迎正在开发语音应用、研究音频模型,或已经体验过 Ming 系列的朋友,带上你的场景与问题来交流!
 时间:2026 年 11 月 6 日 (周五)20:00—21:00
 地点:Voice Agent 开发者 1 群、2 群
 形式:微信群文字 QA
 提问福利:会后将从参与有效提问的开发者中随机抽取 1 位,送出由极米提供的价值 599 元的「极米记得 AI 记忆手环 L1」一份。
添加小助手微信 creators2022,备注「百灵 AMA+一句话自我介绍」,审核后邀请入群。进群后可提前接龙提问,我们群里见!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考