多模态决策模型 Jev-Omni:支持图文、音视频丨日报
本期编辑:@三水、@鲍勃
今天日报开头先插播一条:10 月,来北京线下对答案。
这一年,我们在日报里持续关注实时智能正在发生的变化。从国内到海外,覆盖全双工、端到端语音、Voice Agent、实时多模态、世界模型等话题,从新模型发布、开源项目到产品落地和创业融资,我们几乎每天都在记录这个行业又往前走了一点什么。
而这次,很多日报里出现过的公司、项目和开发者,也会来到 iRTE 2026 实时智能大会现场。比如有阶跃星辰、Kimi、Minimax、面壁智能、生数科技、模思智能等 AI 模型公司,也有我们此前报道过的 VoiceMem、SGLang-Omni、Breeze-TTS 等开源项目作者或团队参会。当然,这还只是目前提前剧透的一部分,还有一些神秘嘉宾会陆续揭晓~
过去在日报里看到的新技术、新项目和新团队,这次可以在线下面对面聊。
10 月 23–24 日,大会会有 15+ 个论坛、100+ 场技术分享,从模型、Agent,到 AI 硬件和实时基础设施,把过去一年我们持续关注的很多话题真正聚到一起。
如果你也每天在关注这些,扫描下方二维码报名,来一起见个面。
线上看了一年,这次线下见~
01 有话题的技术
1、复旦大学、上海创智学院等研究者提出音视频生成奖励模型 VA-Judger:从人类偏好学习整体音画判断,并用于强化学习提升
复旦大学、上海创智学院等研究团队提出 VA-Judger,面向联合音视频生成学习人类对完整结果的偏好。模型会同时比较同一提示词下的两段生成视频,从 提示词匹配、音视频一致性、音频质量、视频质量、内容完整性与连贯性 五个维度给出判断,并生成偏好解释,再将这些评分作为强化学习奖励用于后训练音视频生成模型。
VA-Judger-Bench 用 1150 组音视频对测试「是否符合人类偏好」: 其中包含 400 组明显质量差异样本、250 组同分布样本和 500 组来自 Kling 2.6、Wan 2.6、Veo 3.1、Sora 2 等未见模型的跨分布样本。最终 VA-Judger 对人类偏好的整体判断准确率达到 68.43%,相比原始 Qwen3-Omni CoT 的 57.83% 提升 10.6 个百分点。
训练数据直接来自人类对完整音视频结果的比较: 团队构建 VAPref-10K,包含 9000 个提示词和 1.03 万组细粒度成对偏好;训练先从质量差异明显的样本学习比较格式,再使用人工验证的困难样本和 Dimension-wise GRPO 继续对齐人类判断。
奖励可以直接用于改进生成模型: 团队用 VA-Judger 后训练 LTX-2,在 200 个 JavisBench 提示词测试中,视频质量从 2.248 提升到 3.942,音频质量从 4.767 提升到 5.610,JavisScore 从 0.074 提升到 0.230。
人类盲评也观察到生成结果变化: 20 名参与者对 200 组三模型输出进行三选一比较,VA-Judger 后训练的 LTX-2 获得 62.30% 的偏好选择,OmniNFT 为 27.63%,原始 LTX-2 为 10.08%。
https://github.com/ShareLab-SII/VA-Judger
2、世界模型团队 XGEN Labs 开源第一人称交互体验模型 JING:可用键盘控制移动、与物体和角色互动,并同步生成视频与音频
XGEN Labs 发布 JING,一款基于 MiniMax-H3 的第一人称交互体验模型。输入动作、参考图像和历史观察后,JING 会继续生成第一人称视频与音频,让用户通过摄像机移动、物体交互和角色对话持续改变后续内容。
支持连续的第一人称导航控制: 用户可以通过
W/S/A/D控制前后左右移动,用I/J/K/L调整视角,模型根据这些动作继续生成后续画面。物体交互和角色对话会进入后续生成: 除了镜头移动,JING 还支持用文本引导物体互动和角色交流,并同步生成对应的视频与音频。
参考图像可同时约束角色、物体和场景: 开发者可以组合多张参考图像定义体验中的人物、物体与环境,再从同一起点探索不同动作分支。
首个开源版本是 JING-Flash-v1: 当前已开放四步双向推理模型、推理代码、示例和 Prompt Skills;因果模型和技术报告仍待后续发布。官方 Demo 已在 6 张 H100 上验证运行。
https://x.com/XGEN_labs/status/2102050332960497738
https://huggingface.co/XGENlabs/XGEN-JING
3、Voice AI 公司 Gradium 推出低延迟 TTS Beta:官方称首包音频可低于 50 ms,较当前生产模型进一步压缩语音智能体响应延迟
Gradium 开放新一版 Gradium TTS Beta,重点继续压缩实时语音合成的首包延迟。官方称新模型的 time-to-first-audio 可低于 50 ms,目前已可在 Gradium Studio 体验;相比 8 月底成为默认版本的 Gradium TTS,这次更新把延迟继续作为主要优化方向。
首包音频延迟进入 50 ms 以下: Gradium 在最新发布中称 Beta 模型可以在低于 50 ms 内开始输出音频,面向需要快速抢占响应时间的实时 Voice Agent 场景。该数字目前来自 Gradium 自测,测试条件尚未完整公开。
相比当前生产模型,延迟进一步下降: Gradium 8 月底发布的现行生产模型在官方引用的 Coval 测试中 P50 TTFA 约为 216 ms,同时在五种语言的 500 条复杂文本测试中通过率为 81.0%。新 Beta 的
<50 ms指标目前还不能与这组数据直接做等条件比较。此前对电话号码、邮箱、IBAN 等复杂文本的处理继续保留在 Beta 路线中: Gradium 今年 7 月开始用 Beta 模型集中优化 Voice Agent 中常见的电话号码、邮箱、参考编号、时间表达和 URL 等结构化文本,并支持通过同一 WebSocket API 做实时流式合成。
https://studio.gradium.ai/?model_name=gradium-tts-beta
https://x.com/GradiumAI/status/2102438831668551687
4、三星波兰研发中心等研究者开源端侧小型音频语言模型 Samsone:最小 99M 参数,Galaxy S25 Ultra 可实时运行
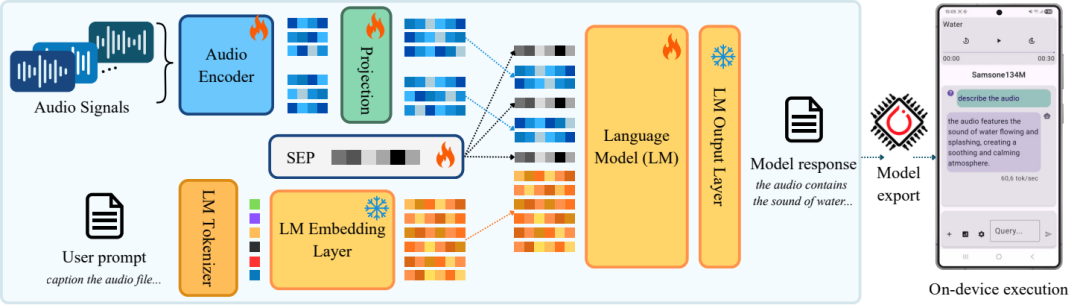
三星波兰研发中心等研究者提出并开源 Samsone,一组面向设备端音频理解的小型 Audio Language Model,包括 99M、134M 和 356M 三个版本。项目同时开放 PyTorch 权重、移动端 ExecuTorch checkpoint、训练与评测代码,以及可直接在 Android 设备上运行的 Demo App;论文已被 Interspeech 2026 接收。
最小版本只有 99M 参数: Samsone 系列包含 99M、134M 和 356M 三档模型,面向声音、音乐和语音理解任务;其中 Samsone-134M 在 MMAU test 上平均得分 61.33,Samsone-99M 为 58.13,都高于 167M 参数的 Mellow。
模型可以直接部署到 Android 端实时运行: 项目提供基于 ExecuTorch 的移动端优化 checkpoint 和开源 Android App,论文与项目均给出了 Galaxy S25 Ultra 上的端侧实时推理验证。
端侧版本和服务器版本同时开源: 三个模型均提供服务端 PyTorch checkpoint,移动端则提供
.pte模型;代码同时覆盖训练、评测、模型导出和 Android 部署流程。训练数据全部来自公开数据集: Samsone 使用 ReasonAQA 和 AudioSkills 训练,作者同时开放完整训练配置,方便开发者复现或继续针对端侧场景微调。
https://arxiv.org/abs/2609.21666
https://github.com/SamsungLabs/samsone
02 有亮点的产品
1、上海首例涉 AI 声音仿冒不正当竞争案生效:《原神》63 款角色声音被复刻销售,法院判赔 75 万元
上海市浦东新区人民法院公布上海首例涉 AI 声音仿冒不正当竞争案。被告运营的 AI 变声软件未经授权复刻《原神》63 款角色声音,制作成付费声音资源包,并配合角色头像、原声试听和游戏宣传素材进行销售推广。法院认定相关行为同时涉及著作权侵权和不正当竞争,一审判赔经济损失及合理维权开支共计 75 万元;被告撤回上诉后,判决已生效。
法院将具有辨识度的游戏角色声音纳入商业标识保护: 判决认为,《原神》角色声音经过长期运营后,已成为公众识别游戏来源的重要听觉标识,属于「有一定影响的商业标识」组成部分。未经许可批量复刻并用于商业变声服务,足以使用户误认为相关服务与游戏方存在授权或合作关系。
涉案服务采用 AI 语音处理技术批量生成角色音色包: 相关软件共包含 500 余款声音资源包,其中《原神》涉案角色共 63 款,可用于实时语音聊天中的变声。公开报道显示,这些资源包售价约 19–59 元,部分使用次数达到数万至上百万次。
声音复刻本身与商业混淆被分别看待: 法院同时指出,市场主体仍可借鉴基础声线特征进行声音模仿;本案触及边界的关键,在于未经授权复刻具有明确来源识别作用的角色声音,并叠加角色形象、原声试听等方式进行整体商业化使用。
https://m.thepaper.cn/newsDetail_forward_34043593
2、瑞典 AI 助手公司 Incredible 推出语音优先桌面智能体:可直接操作浏览器、文件与应用完成电脑任务
瑞典 AI 公司 Incredible 发布面向 Mac 和 Windows 的语音优先桌面智能体。用户按下快捷键后直接说出任务,Incredible 会结合当前屏幕内容理解上下文,并在浏览器、文件和应用中执行点击、输入、搜索、切换标签页、填写表单和发送等操作。
语音从「输入方式」变成电脑操作入口: Incredible 会读取用户当前激活的屏幕和应用状态,将自然语言指令直接转换成浏览器与桌面操作,用户无需把内容复制到聊天窗口再手动执行。
可跨浏览器、文件和 3000+ 应用执行任务: 官网展示的能力包括网页点击、搜索、输入、表单填写、标签页切换,以及在 Gmail、Google Sheets、日历等工具之间串联任务;对于没有专门集成的网站,也可以直接通过浏览器界面操作。
涉及外部提交的动作会等待用户确认: Incredible 可以自动完成读取、搜索和准备步骤,但发送、提交、修改和删除等操作会暂停并展示下一步,由用户确认后继续执行。
屏幕上下文按用户主动调用获取: 官方称 Incredible 只在用户激活时读取屏幕内容,并可结合连接的应用和本地文件完成任务;当前提供 macOS 和 Windows 客户端。
http://incredible.one
https://x.com/useincredible/status/2102382407471263760
3、AI 硬件公司 Rabbit 发布跨平台智能体系统 OS3:从 R1 专用设备扩展到 Mac、Windows、Linux、Telegram 和 iMessage
Rabbit 发布 OS3,将原本围绕 R1 硬件构建的 Agent 能力扩展成跨设备的软件系统。OS3 运行在云端,通过安装在 Windows、Mac 或 Linux 上的本地 Agent Node 连接桌面软件、文件和网页;用户也可以通过浏览器、Telegram 或 iMessage 发起任务,一个账号最多可连接 5 台设备。
从专用 AI 硬件转向跨设备 Agent 平台: OS3 不再要求使用 R1,用户可直接在现有电脑和手机入口调用;如果已经拥有 R1,也可以把它作为 OS3 的输入输出设备。Rabbit 目前已停止生产 R1,并表示没有推出 R2 的计划。
本地 Agent Node 可以直接操作软件、文件和网页: OS3 使用 Rabbit 的 DLAM(Direct Large Action Model)执行本地软件任务,也可以自主编写和调试代码;系统会根据任务自动决定由已连接的哪台设备执行。
第三方 Agent Skill 可以直接安装进会话: 用户把公开的 Skill URL 粘贴到聊天中,OS3 即可自动安装并调用,无需手动配置;Rabbit 将其称为 universal skill compatibility。
采用 BYOK,不收月订阅费: 用户可接入 OpenAI、Anthropic 等模型提供商的 API Key,也可以连接本地开源模型;Rabbit 表示本地文件内容保留在设备端,但涉及模型推理的相关提示会经过 Rabbit 服务器再发送给对应模型提供商。
https://www.wired.com/story/rabbit-r1-os3-jesse-lyu/
(@wired)
4、开发者 Akhila 开源多模态实时决策模型 Jev-Omni:统一支持文本、图像、音频和视频输入,文本决策延迟约 83 ms
开发者 Akhila 开源 Jev-Omni,一款面向实时类型化决策的多模态模型,统一支持文本、图像、音频和视频输入。模型延续 Jev 这类决策模型的使用方式:输入当前状态和候选选项后,直接返回各选项概率,用于分类、路由和动作选择。
四种模态统一进入同一个决策接口: Jev-Omni 可同时处理文本、图像、音频和视频,并输出结构化概率结果。作者将其定位为首个覆盖这四种模态的开源系统 1 模型。
在类型化决策基准上与 Jev 表现接近: Jev-Omni 在 JevBench 上准确率为 86.15%,微平均准确率为 87.45%;DecisionBench Medium 准确率为 87.57%。
不同模态的推理延迟已经给出实测: 在 H200 上,预热后推理中位延迟约为:2k token 文本 83 ms、图片 26 ms、13 秒音频 31 ms、16 帧视频 504 ms;这些数字不包含预处理和网络时间。
模型基于 Gemma 4 12B IT 微调并已开放权重: 作者使用约 3 万道问题进行训练,采用 Apache-2.0 许可证;当前音频输入最长 30 秒,视频默认取 16 帧。
https://x.com/Akhila_988/status/2102171891410825520
https://huggingface.co/akhilaaa3/Jev-Omni
03 有态度的观点
1、特努斯:Siri AI 不应代替人际关系
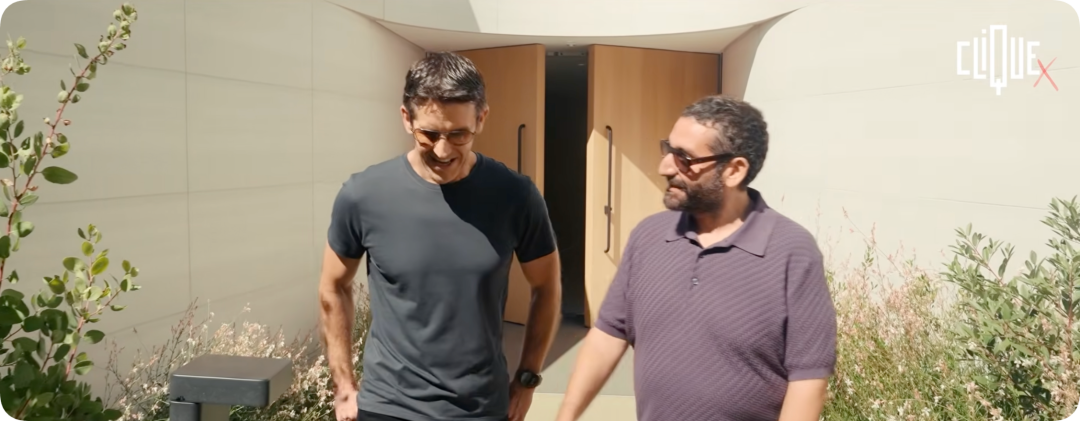
苹果 CEO John Ternus 在接受 Canal+ 节目 Clique 采访时表示,Siri AI 「并非被设计成你的朋友」。面对 AI 伴侣产品的市场竞争,他认为苹果不希望 AI 取代人与人的关系,因为人际关系是学习、成长和获得快乐的基础。
他还谈到 iPhone Duo 的开发取舍。苹果从类似 iPad 的大屏体验出发确定展开比例,没有沿用常见的两块手机屏幕拼接形态。铰链和屏幕的可靠性是主要工程问题;例如,团队需要同时处理展开角度、屏幕连续性与软件动画的配合。
Ternus 特别展示了展开手机时跨越两侧屏幕的动画。他把这个小细节视为工程之外的产品目标:用户在展开设备时能立刻理解界面如何连续,同时保留一点轻松感。
对于接任 CEO 后的方向,Ternus 称不会对苹果做激进改造。
Tim Cook 和苹果董事会询问他是否愿意接任时,他形容自己「幸好当时是坐着的」。他给出的经营边界是继续把产品、创新和用户放在中心,不把新任期包装成路线翻转。
(@APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考