Fish Audio 全双工模型 Live 3 上线,从真人对话学习接话时机丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、Fish Audio 发布全双工语音模型 Live 3:从真人对话学习接话时机,最快 186ms 做出回应决策
语音 AI 公司 Fish Audio 发布全双工语音模型 Live 3,重点提升 Voice Agent 在连续对话中的轮次判断与打断处理能力。模型通过真实人类对话数据学习何时附和、等待、接话或停止,让 Agent 能够在说话时持续聆听,并根据用户的停顿、插话和临时修改实时调整回应方式。
从真实对话中学习轮次控制: 将对话时机判断融入语音模型,通过训练数据学习应答、等待和停止等行为,减少对独立 VAD 阈值及人工轮次规则的依赖。
区分附和与真正打断: 当用户在 Agent 讲话时说“嗯”“对”等简短反馈,模型可以继续表达;当用户明确提出新要求时,则停止当前输出。对于分段报电话号码、修改订单等场景,也能通过简短附和保持对话连续。
最快 186ms 决定是否回应: 据 Fish Audio 披露,Live 3 最快可在 186ms 内做出回应决策,并通过简短确认语保持交流流畅。模型目前支持英语,已上线 Fish Agent Platform,开放 API 调用,并支持企业本地部署。
https://beta.fish.audio/blog/introducing-live-3/
2、个人电话助手 Mitra 开放 MCP 接口:Claude、ChatGPT 可调用 AI 使用本人号码拨打电话并查询通话结果
个人 AI 电话助手 Mitra 宣布开放 MCP 接口,让 Claude、ChatGPT 等支持 MCP 的 AI 应用能够调用其电话服务。Mitra 原本可使用用户现有的电话号码接听和拨打电话,新接口进一步将电话能力开放给外部 Agent,使用户可以直接在 AI 对话中委托预约、询价、跟进事项等任务,并获取通话结果。
通过 MCP 将电话能力接入外部 Agent: Mitra 提供远程 MCP Server,支持 Claude、ChatGPT 等应用通过 OAuth 连接现有账号。Agent 可发起电话请求、查询通话记录及转写内容,并调用用户已配置的 Mitra 助手。
使用本人号码完成电话任务: Mitra 可代替用户拨打电话、处理等待和电话菜单,并在通话后返回摘要与后续事项。用户可设置每次拨号前确认、始终允许或禁止外拨,避免 Agent 未经授权发起电话。
复用现有记忆与工具连接: MCP 请求可使用 Mitra 已建立的对话记忆、联系人及日历等上下文,也可发送消息、修改日程和设置提醒。外部 AI 应用仅接收 Mitra 返回的结果,无法直接浏览其内部联系人或记忆数据。接口已开放,需完成 Mitra 账号和电话功能配置。
https://www.getmitra.com/mcp
3、OpenAI 公布四家 GPT-Live 落地案例:后台任务并行、多角色语音协作,真实通话目标达成率提升 6 个百分点
OpenAI 开发者博客发布四家企业使用 GPT-Live 构建 Voice Agent 的实践案例,涉及健康助手 Juno、创作平台 Picsart、企业电话 Agent Treater 和语音游戏开发商 Weekend。文章介绍了团队如何处理长对话记忆、后台任务执行、语音风格优化及多角色协作,并公布部分真实业务测试数据。
Juno:异步处理任务与长期记忆。 健康助手 Juno 在每轮对话后使用 Decisions API 判断需要记录的信息和相关历史记忆,再将结果提供给后续语音交互。团队表示,该架构使文本 Agent 的交接次数减少 40%,测试通话中的最长静默时间由 9.3 秒降至 3.2 秒。
Picsart:语音对话与后台 Agent 并行。 Picsart 通过 WebRTC 连接浏览器与 GPT-Live,并利用 WebSocket 在语音界面和后台智能体之间同步任务状态。用户可在 AI 执行图片、视频创作任务时继续交流,也能在结束语音通话后保留任务进度。
Treater:根据真实通话优化语音 Agent。 企业电话 Agent 平台 Treater 通过多臂老虎机算法测试不同声音、Prompt、语速和工具配置。据团队披露,采用 GPT-Live 后,通话时长中位数增长 26%–30%,客户目标达成率平均提高 6 个百分点。
Weekend:两个 GPT-Live 会话协作扮演不同角色。 在语音桌游 Wit’s End 中,团队为游戏主持人和剧情角色分别运行独立语音会话,通过 Decisions API 判断谁该接话。预热会话的角色切换后首段语音平均延迟为 0.84 秒,低于新建会话的 1.54 秒。
https://developers.openai.com/blog/pushing-voice-agents-further
4、Google 发布端侧语音方案:Android 系统级 ASR 支持超 100 种语言,TTS 约 100ms 开口,开放跨平台 API
Google 发布面向移动端和可穿戴设备的端侧语音方案,将新一代 ASR 与 TTS 模型集成到 Android ML Kit GenAI,并通过 MediaPipe Tasks 和 LiteRT 为跨平台开发者提供开放模型支持。Google AI Edge Gallery 同步加入离线语音聊天与 XR 语言教学演示,让视觉理解、语言模型和语音输入输出能够在设备本地协同运行。
Android 系统级 ASR 支持超 100 种语言: ML Kit GenAI Speech Recognition API 支持实时输出部分及最终转写结果。Google 官方测试显示,模型在 FLEURS 上达到约 8%–9% 的词错误率,转写速度约为实时的 10 倍,并使端到端语音翻译等待时间缩短 35%–44%。
端侧扩散 TTS 约 100ms 开始发声: ML Kit GenAI Text-to-Speech API 采用经 NPU 加速的少步扩散模型,支持 21 种语言区域设置及 8 种声音,输出 24kHz 音频,生成速度最高达到实时的 50 倍。模型由系统管理,无需将模型权重打包进 APK。
MediaPipe 与 LiteRT 支持跨平台接入: 为 iOS、macOS、Windows、Linux 和 Web 提供语音识别及合成接口,并适配 Parakeet-TDT 0.6B、PocketTTS 100M、Kokoro-82M、Phonon 31M 等开放权重模型。LiteRT 将模型及相关预处理组件封装为
.litertlm文件,降低部署复杂度。开放全离线多模态应用示例: Google AI Edge Gallery 新增 XR Language Teacher,可通过摄像头识别菜单、标识等内容,并结合 Gemini Nano 或 Gemma 4 在本地生成双语解释与发音;AI Chat 也加入流式听写、语音播放和逐句高亮功能。相关实现已在 GitHub 开源。
https://developers.googleblog.com/on-device-speech-recognition-and-text-to-speech-in-google-ai-edge-gallery/
02 有亮点的产品
1、开发者开源 Mac 语音跟读应用 Read Along:本地 ASR 实时追踪朗读位置,读错或跳行也能重新对齐
开发者 Sharath Krishnamurthy 开源 macOS 阅读应用 Read Along,支持导入 PDF、扫描文档、手写页面及文本文件。用户出声朗读时,应用会通过本地语音识别实时追踪阅读位置,直接在原始页面上高亮当前词句,即使出现识别错误或跳过段落,也能重新定位到正确位置。项目基于 SwiftUI 与 Python 构建,所有识别和文档处理均在本机完成。
本地流式 ASR 跟踪朗读进度: 使用 Phonon-2.5 English 模型实时识别麦克风音频,再通过单调模糊对齐算法匹配原文。系统可容忍识别错误,并在跳行后重新定位,避免逐词跟读过程中高亮位置持续偏移。
直接在 PDF 和手写页面上高亮: 对可提取文字的 PDF 直接读取文本及坐标;扫描件和手写内容则结合 LFM3-VL 2B 与 macOS Vision 进行 OCR。阅读时以不同颜色标记当前和下一处文字,并支持自动翻页。
完全本地运行,代码采用 MIT 许可证: 支持用户自己朗读和系统语音朗读两种模式,提供阅读进度保存、OCR 纠错及文档管理。适用于搭载 Apple Silicon、运行 macOS 14 及以上版本的 Mac;首次使用需下载约 1.7GB 模型,目前语音跟读主要支持英语。
https://github.com/sharathkrml/read-along
2、YC 孵化团队 Moonshot 推出 AI 吊坠 Luna 并开启众筹:灯光与震动主动提醒,配合语音助手 Samantha
Y Combinator 2026 夏季批次初创公司 Moonshot Computer 推出新款 AI 可穿戴设备 Luna,并于 11 月 10 日在 Kickstarter 开启众筹。设备采用月牙形吊坠设计,内置双麦克风,通过手机上的 AI 助手 Samantha 持续理解用户授权记录的日常对话,在需要提醒时先通过灯光和轻微震动吸引注意,再通过耳机或手机提供语音回应。
用灯光与触觉反馈触发主动交互: Luna 通过柔和灯光和震动提醒用户,再由 Samantha 结合历史对话提供待办提醒、日程跟进和主动建议,减少每次都需要主动唤醒 AI 的操作。
双麦克风与手机协同工作: 吊坠直径约 27mm、重量约 7g,不配备摄像头,可连接 iPhone 或 Android 手机。用户能够通过双击关闭麦克风;语音处理与上下文记忆依赖配套 App 和云端服务。
众筹启动,计划 2027 年春季交付: 官方公布前 300 名支持者可享受 399 美元价格,常规众筹价为 499 美元,并附赠充电盒及六个月 Samantha 服务。硬件目前仍处于众筹阶段,尚未量产交付。
https://moonshot.computer/reserve
https://x.com/ojaskandy/status/2120211254619107808
3、AI 硬件 SlashVibe 开启 Kickstarter 众筹:桌面屏幕实时显示 Agent 状态,可拆卸语音控制器支持 Codex、Claude Code 等工具
AI 硬件项目 SlashVibe 正式开启 Kickstarter 众筹,并已超过 1 万美元的初始目标。产品由一块常亮桌面显示屏和可拆卸控制器组成,能够集中显示多个 AI Agent 的运行状态、待办任务和待确认操作。用户可以通过按键、摇杆或语音切换 Agent、批准任务及下达新指令,减少在不同开发工具之间反复切换窗口。
常亮屏幕集中显示 Agent 任务: 配备 3.96 英寸 LCD 显示屏,可查看不同 Agent 的进度、任务状态和待处理操作,通过物理按键及摇杆切换会话、确认下一步执行。
可拆卸控制器支持语音交互: 控制器配备双 MEMS 麦克风、按键及摇杆,通过 2.4GHz 与桌面主机通信,支持将语音转换为指令,也可配置本地 STT。桌面显示屏通过 USB-C 连接电脑。
兼容 20 余种 AI 开发工具: 通过 SlashVibe+ 软件连接 Claude Code、Codex、Cursor、Gemini CLI、OpenCode 等现有工具,用户仍需自行提供对应账号或 API。产品兼容 macOS 和 Windows,计划于 2027 年 3 月开始首批发货。
https://x.com/slashvibe_ai/status/2120184730406560234
4、视觉 AI 公司 Memories.ai 推出第一视角数据采集平台 Memories Upload:通过 LUCI Pin 记录真实操作,为机器人训练提供数据
视觉 AI 公司 Memories.ai 推出数据采集平台 Memories Upload,邀请参与者佩戴 LUCI Pin 摄像设备,按照任务要求拍摄做饭、整理物品、维修及其他日常操作,并根据审核通过的有效录像时长获得报酬。平台将第一视角视频转化为带有动作、手部姿态和语义标签的训练数据,提供给世界模型与机器人研发团队。
通过轻量级摄像设备采集真实操作: LUCI Pin 重量低于 45g,提供 109° 视场角,可安装在手腕、胸前、头部等位置,记录操作者视角下的手部动作与环境变化,也支持双摄像头采集立体视角。
按任务质量与有效时长向参与者付费: 参与者可通过 Memories Upload 选择做饭、洗衣、购物等采集任务。上传视频经过 AI 和人工审核,仅对符合要求的有效时长支付报酬,具体金额依据任务和质量等级确定。
将视频转化为机器人训练数据: 平台使用自研 Omni Model 为视频建立时间索引、描述和向量表示,并提取手部动作边界、动作类别、3D 手部姿态等信息。公司网站披露,其采集网络已积累超过 100 万小时第一视角视频,使用中的 LUCI Pin 超过 5000 台;相关数据可通过 DataLake API 提供给机器人及世界模型团队。
https://x.com/shawnshenjx/status/2120177161860706806
03 有态度的观点
1、派拉蒙天舞 CEO:AI 工具或让片商更敢为新人导演下注
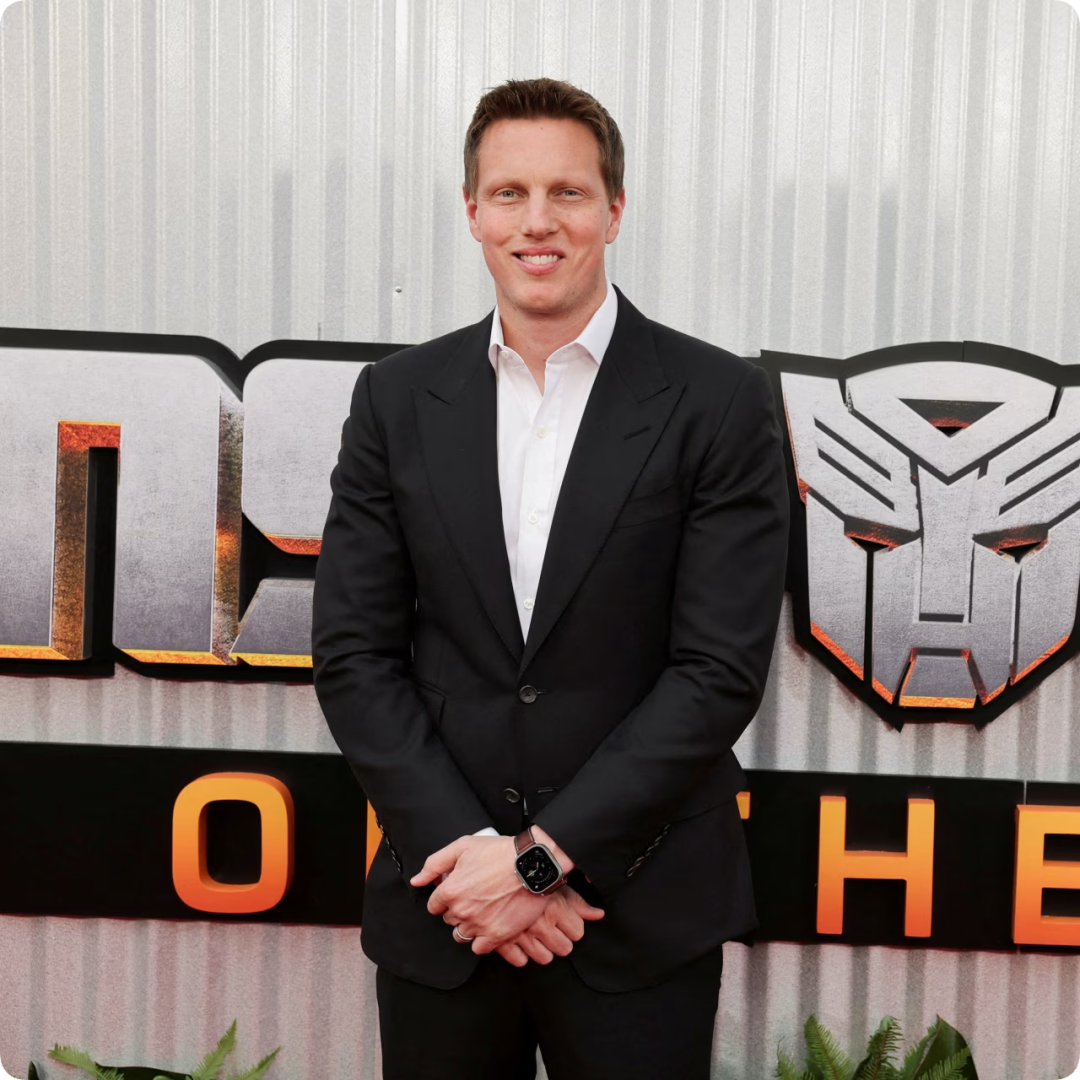
在派拉蒙天舞最新一场财报电话会上,首席执行官大卫·埃里森表示,AI 工具可以帮助降低电影制作成本,让片商更愿意为新人导演和原创故事承担风险。
埃里森以詹姆斯·卡梅隆早期拍摄的《终结者》为例。他认为,今天按同样的镜头逐一重拍,制作成本会比当时高得多。面对一部由新人执导、尚未有大明星撑场的原创电影,片商很难按这样的预算押注。AI 工具如果能让预算降到更容易接受的水平,类似项目就可能更容易开拍。
他还把 AI 与上世纪 90 年代初的电脑特效和数字合成相比。《侏罗纪公园》和《终结者 2》是他用来说明制作工具如何拓宽电影叙事的两个例子。在同一场电话会上,埃里森将 AI 的角色界定为供创作者使用的工具。同一场问答也涉及 AI 会怎样改变观众寻找内容的方式。埃里森把流媒体的用途落在个性化推荐、内容发现和用户留存。
他同时认为,即使制作工具越来越普及,由创作者主导打磨的故事和成熟的系列 IP 仍有价值。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考