Otter.ai 获 3.2 亿美元增长融资:从会议转写转型企业语音知识库丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、法国 AI 公司 Mistral 发布 Voxtral 3 语音模型与 Voice Agent SDK:实时转写延迟低于 500ms,支持 ASR、LLM、TTS 按需替换
法国 AI 公司 Mistral AI 发布新一代语音模型系列 Voxtral 3,包含三款语音转写模型和一款支持流式输出的语音合成模型,同时推出基于 LiveKit 的 Voice Agent SDK。开发者可以将实时语音识别、语言模型推理、工具调用和语音合成组合为完整的流式语音智能体,并独立替换各环节使用的模型。Mistral 宣称,其优化后的流水线能够将单轮语音交互时间控制在 1 秒以内。
三款 ASR 模型覆盖实时转写与高精度识别: Voxtral Mini Transcribe 3 面向批量音频转写,拥有 4B 参数,价格为 0.0035 美元/分钟;Voxtral Small Transcribe 3 主打更高的多语言识别精度,价格为 0.004 美元/分钟。两者支持 50 种语言、说话人区分及上下文热词增强。面向实时场景的 Voxtral Mini Transcribe Realtime 3 则通过 WebSocket 持续输出转写结果,支持配置 80–2400ms 流式延迟,并集成结合声学与语义信息的轮次结束检测,价格为 0.008 美元/分钟。
流式 TTS 支持情绪控制与音色克隆:Voxtral TTS 3 支持 35 种以上语言和 50 多种方言,可根据上下文自动调整情绪、语速和重音,也支持通过情绪标签、语速参数及发音提示进行控制。模型提供零样本音色克隆,以及基于约 30 分钟录音的专业音色适配。官方模型文档公布的流式语音首包延迟约为 90ms,API 定价为每 100 万字符 13 美元。
LiveKit SDK 串联完整语音工作流,允许独立替换模型: 新推出的 Voice Agent SDK 将实时 ASR、LLM 推理、工具调用和 TTS 接入同一条流式管线,各模块可以并行处理,减少串行等待时间。开发者可以分别配置语音识别模型、推理模型与合成音色,并通过函数调用、搜索及企业知识库检索完成多步骤任务。SDK 支持 WebRTC 浏览器交互与 SIP 电话接入,可用于客服中心、预约服务和企业语音助手,并支持用户在 AI 说话时直接打断。
提供完整语音 Agent API,也支持私有化部署: 除单独调用 ASR 和 TTS 外,Mistral 还提供托管式 Voice Agent API,使用 Mistral Small 4 作为推理模型时,价格为 0.04 美元/分钟;选择其他推理模型时为 0.08 美元/分钟。Voxtral 3 已通过 Mistral API 和 Studio 开放,支持欧洲、美国及全球服务端点。企业也可以联系 Mistral 部署至自有基础设施或私有云,以满足数据处理与存储要求。
目前 Voxtral 3 相关模型处于 Public Preview 阶段,Mistral 尚未公布与 Eleven Realtime 在相同测试条件下的端到端延迟和任务成功率对比。
https://mistral.ai/news/voxtral-3
2、NVIDIA 开源手术世界模型 Cosmos3-H-Dreams:单张 GPU 实时生成 30fps 手术画面,支持双机械臂交互控制
NVIDIA 发布并开源新一代手术世界模型 Cosmos3-H-Dreams,将此前面向桌面缝合任务的生成式机器人仿真扩展至真实临床手术场景。模型基于约 15B 参数的 Cosmos 3 架构,利用真实胆囊切除手术视频与机器人运动数据训练,可以根据机械臂的实时控制指令,持续生成器械运动、组织变形与遮挡变化后的手术画面。官方测试显示,模型在单张 NVIDIA RTX PRO 6000 Blackwell GPU 上可实现 30fps 实时生成,两步蒸馏版本可达到 43.2fps。
从桌面缝合扩展到真实临床手术场景: Cosmos3-H-Dreams 基于 Cosmos3-H-Embodied-Nano 进行适配,使用 CMR Surgical Versius 手术机器人采集的胆囊切除视频和运动学数据训练。训练数据包含筛选后的 64 段手术录像、约 526 分钟视频。模型支持 28 维双臂动作输入,涵盖左右机械臂的位置、旋转、夹爪状态、电外科能量控制及摇杆操作,可根据动作变化生成相应的手术场景。
通过四步、两步蒸馏实现单卡实时生成: 团队先训练能够预测较长视频序列的双向教师模型,再通过因果教师强制训练(Causal Teacher Forcing)与 Self-Forcing 蒸馏,使学生模型能够根据持续输入的动作分块生成视频。此次开放四步和两步去噪版本,后者以一定画质损失换取更快推理。在 832×480 分辨率下,两款模型分别达到 30fps 和 43.2fps,并通过 FlashDreams 推理框架与 FadeMem 缓存机制支持连续生成。
支持实时操控手术器械,观察不同动作产生的结果: 开发者提供一张初始内窥镜画面,以及机械臂的历史动作和后续控制指令,模型即可持续生成手术视频。NVIDIA 展示了使用 VR 头显控制器操作机械臂的演示:即使从相同初始画面出发,不同的动作轨迹也会生成不同的器械位置、组织牵拉和遮挡效果。系统具备动作输入与场景反馈的实时交互能力,可作为机器人控制策略测试的仿真环境。
开放模型权重、推理代码及训练适配流程: 项目已在 Hugging Face 发布模型权重,并在 GitHub 开源推理、实时交互和示例代码。开发者还可以利用同步采集的视频与机器人动作数据,参考官方提供的教师模型微调和 Self-Forcing 蒸馏流程,将模型适配到其他手术设备或任务。代码采用 Apache 2.0 许可证,模型权重遵循 NVIDIA Open Model License。
目前 Cosmos3-H-Dreams 仍属于研究级手术仿真系统,尚未经过临床验证,也不能用于实际患者手术。其现有能力主要是根据外部控制指令实时生成场景;将自主手术策略接入模型、通过连续反馈完成完整闭环训练,仍属于 NVIDIA 后续计划探索的方向。官方也指出,生成画面的视觉真实性尚不能证明组织变形和器械接触符合真实生物力学规律。
https://github.com/isaac-for-healthcare/cosmos3-h-dreams
3、开源实时数字人组件 OpenSpline:5 行代码为 Voice Agent 添加视频形象,RTX 4090 轻量模型演示超 90fps 生成
开源社区项目 OpenSpline 近期在 Reddit 的 LocalLLaMA 社区发布,提供一套可接入现有语音智能体的实时数字人生成组件。开发者只需提供一张人物照片,将 Voice Agent 的音频输出接入 OpenSpline,即可生成与语音同步的数字人视频,无需重新搭建语音识别、语言模型或 TTS 管线。项目支持 OpenAI Realtime、Gemini Live、ElevenLabs、LiveKit 等现有方案,既可以使用云端服务,也支持在自己的 NVIDIA GPU 上部署。开发者称,轻量模型在 RTX 4090 上的生成速度可超过 90fps。
5 行 Python 代码接入,为现有语音 Agent 增加视频输出: OpenSpline 提供 Python 和 Node.js SDK,开发者可以上传一张人物照片,再将智能体持续生成的音频流传入
avatar.stream(),得到同步的视频播放地址。项目还提供 React 组件、Web 组件和内置播放器,方便将数字人嵌入网站或应用。已有的提示词、工具调用和语音模型无需替换。兼容多种实时语音框架,支持打断和连续交互: 项目提供 OpenAI Realtime、Gemini Live、ElevenLabs Agents 和 LiveKit 的现成适配器,同时支持 Pipecat 等框架。OpenSpline 在原有语音工作流外增加视频生成层,负责音画同步、待机动作和用户打断时的播放控制。开发者也可以直接输入 PCM 音频流,或使用 WAV、MP3 文件驱动人物说话。
基于 SoulX-FlashHead 生成实时人像视频,可本地运行: OpenSpline 使用开源的 SoulX-FlashHead 音频驱动人像模型作为核心生成引擎,并结合 Wan、LTX-Video 的相关视频组件。项目提供 Low 和 High 两档画质,支持 Linux 或 WSL2 环境下的 NVIDIA CUDA GPU。开发者在社区演示中报告,轻量模型在 RTX 4090 上超过 90fps;仓库另记录了 A100 上 Low 档约 64fps、High 档约 8fps 的短时推理测试。两组数字均为不同条件下的生成吞吐率,不等于语音输入到画面显示的完整延迟。
开放自部署服务和多 GPU 工作节点: OpenSpline 提供安装脚本、GPU 推理服务、会话管理和播放器。开发者可以自行部署模型,或使用 OpenSpline Cloud 生成数字人。当前一个 GPU 工作节点一次处理一个会话,多并发需要配置额外工作节点;高画质模式也可以配置多张 GPU 共同运行。
OpenSpline 目前仍处于早期开发阶段,仓库已公开 SDK、服务端推理和语音框架适配代码,主体采用 MIT 许可证,内置第三方推理代码及模型权重遵循各自的许可证。项目尚未公布经过统一测试的端到端音画延迟、长时间运行稳定性及不同 GPU 上的完整性能数据。
https://openspline.dev/
4、法国 AI 研究实验室 Kyutai 更新 Pocket TTS:最小模型仅 1.9M 参数,单核 CPU 实现 25 倍实时语音合成,支持声音克隆
法国 AI 研究实验室 Kyutai 发布新一批轻量级语音合成模型 Pocket TTS,将原版约 100M 参数的模型进一步压缩至 18.2M、6.9M 和 1.9M 三种规模,均支持声音克隆和 CPU 推理。其中,18.2M 版本在语音质量上已接近原版,而最小的 1.9M 版本参数量减少约 98%,官方测试显示,仅使用 一个 CPU 线程就能以实时速度的 25 倍生成语音。
三种模型规模,兼顾语音质量与推理速度: 官方基于 LibriSpeech test-clean 的 1127 条语音测试发现,18.2M 模型的词错误率(WER)为 0.85%,接近原版约 100M 模型的 0.92%;经过奖励微调后,词错误率进一步降至 0.82%。在单 CPU 线程测试中,18.2M、6.9M 和 1.9M 三款模型的生成速度分别达到实时的 9.9 倍、12.6 倍和 25 倍,而原版为 2.8 倍。
同时压缩语言模型、采样头和音频解码器: Pocket TTS 采用逐帧生成架构,每次预测约 80ms 的音频特征,再通过 Mimi 解码器还原为 24kHz 语音。此次更新通过逐步结构化剪枝与知识蒸馏,将 Transformer 主干从较大教师模型的 24 层压缩至更小的结构,并同步缩减音频采样头和解码器。最小模型中,主干仅约 0.78M 参数,采样头约 0.10M,音频解码器约 1.04M。
最小模型仍支持声音克隆,但语音质量有所下降: 开发者可以输入一段参考语音,生成具有相似音色的新语音,无需额外训练专属音色模型。官方评测中,1.9M 模型经过奖励微调后的 WER 为 1.27%,自然度预测评分(UTMOS)为 4.012;18.2M 微调版本则分别达到 0.82% 和 4.400。极小模型更适合资源受限设备,仍需在生成速度与声音质量之间权衡。
开放全部模型权重、训练代码与跨平台运行程序: Kyutai 在 GitHub 发布 Pocket TTS v4.0.0,新增三种规模各两款模型,共六个英语模型版本,包括标准版和经过奖励微调的版本。除 Python SDK 和本地 HTTP 服务外,还提供无需安装 Python 或 PyTorch 的 Rust 命令行程序,支持 Linux、macOS 和 Windows。开发者也可以在官方博客中直接试听不同模型,并从 Hugging Face 下载权重。
Pocket TTS 项目代码采用 MIT 许可证,模型权重采用 CC BY 4.0 许可证,下载前需要接受使用条款。此次新增的小模型目前主要面向英语语音合成,原项目的其他语言模型仍采用较大架构。官方公布的 25 倍实时速度为单线程音频生成吞吐率,不代表首包延迟或完整语音 Agent 的端到端响应时间。
https://kyutai.org/blog/2026-10-20-pocket-tts-small/
5、端侧语音识别模型 Underdog Bark 3.0 发布:仅 163MB,会议转写 WER 低至 7.82%,精度媲美 NVIDIA Parakeet
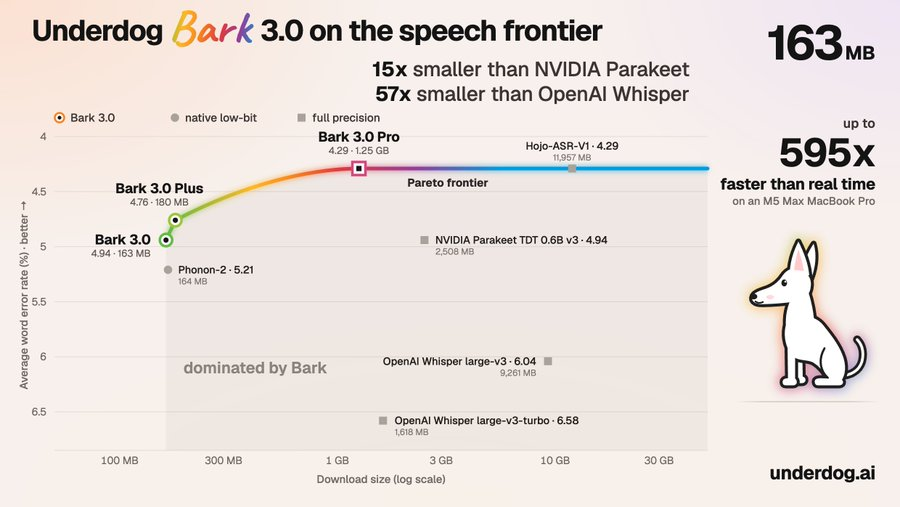
AI 语音笔记应用 Underdog 发布轻量级语音识别模型 Bark 3.0,模型权重下载体积仅 163MB,可在笔记本电脑和移动设备上本地运行,用于会议记录、语音听写和离线转写。官方宣称,在 MacBook 上处理一分钟录音仅需 0.25 秒以内。在 AMI 会议语音测试中,Bark 3.0 的词错误率(WER)为 7.82%,优于 NVIDIA Parakeet TDT 0.6B v3 的 9.42% 和 OpenAI Whisper large-v3 的 13.63%。
163MB 模型,会议转写精度超过大模型: Bark 3.0 基于 NVIDIA Parakeet TDT 架构及 Moondream Parakeet Ultra 的相关成果,通过后训练和模型压缩实现端侧部署。在 AMI 会议录音测试中,Bark 3.0 的 WER 为 7.82%,相比 Parakeet TDT 0.6B v3 的 9.42% 降低 1.60 个百分点。按照 Hugging Face 上相应权重文件的体积计算,Bark 3.0 仅为 Parakeet 的约 1/15、Whisper large-v3 的约 1/57。
覆盖七项英语 ASR 基准,综合精度与 Parakeet 持平: 在七项英语语音识别测试集上,Bark 3.0 的平均 WER 为 4.94%,与 Parakeet TDT 0.6B v3 相当,优于 Whisper large-v3 的 6.04%。除会议录音外,模型还在有声读物、播客访谈、企业财报电话会议和欧洲议会演讲等不同英语语音场景中接受测试,覆盖朗读、自然口语、专业术语及不同口音等识别任务。Bark 3.0 还针对口语中的停顿、重复和自我修正保留逐字转写能力,在包含口语不流畅现象的测试集上取得 3.15% WER。
本地推理与开源权重,面向私密语音记录: Bark 3.0 支持 Apple Silicon 设备的本地推理,并提供适用于 Core ML 和 MLX 的模型文件。Underdog 将其用于设备端会议记录和语音听写,让录音内容无需上传至云端即可完成识别。团队还提供 Bark 3.0 Plus(180MB) 和 Bark 3.0 Pro(1.25GB),两者在七项英语基准上的平均 WER 分别为 4.76% 和 4.29%,供开发者根据设备资源和识别精度选择。
Bark 3.0 已在 Hugging Face 开放权重,采用 CC BY 4.0 许可证,目前主要支持英语语音识别。需要注意,163MB 为特定模型权重的下载体积,不能直接代表所有运行格式的大小;官方宣称的 0.25 秒转写速度尚缺少完整公开的统一测试条件,也不等同于实时流式转写的端到端延迟。此外,Bark 3.0 的基准结果由团队使用公开评测代码自行计算,尚未全部作为正式成绩进入排行榜。
https://underdog.ai/bark
02 有亮点的产品
1、AI 会议语音平台 Otter.ai 获 3.2 亿美元增长融资:不稀释股权,押注企业语音知识库与智能体工作流
AI 会议转写与语音智能体平台 Otter.ai 宣布获得 General Catalyst 旗下 Customer Value Fund(CVF)提供的 3.2 亿美元增长融资,用于扩大企业客户业务、国际市场拓展及产品研发。此次融资采用非股权、可偿还结构,不会稀释现有股东权益。Otter.ai 正从会议转写工具向企业级语音知识平台转型,希望将会议中的讨论、决策和待办事项转化为可查询、可执行的组织知识。
3.2 亿美元采用非股权融资,收益来自企业客户增长: General Catalyst 的 CVF 主要为企业销售和市场拓展提供资金。Otter.ai CEO Sam Liang 向路透社确认,这笔资金需要随销售和营销投入产生收入后连同利息偿还,不涉及出售公司股权。公司计划将销售和营销预算提高至目前的 2–3 倍,扩大销售团队,并重点开拓美国以外的企业市场。具体还款条款及公司最新估值尚未披露。
累计用户超 4000 万,覆盖 86% 的财富 500 强企业: Otter.ai 披露,全球累计用户超过 4000 万,较去年的 2500 万增长明显;超过 86% 的财富 500 强企业中已有团队成员使用其产品。平台累计转写会议超过 10 亿场,官方估计已帮助客户创造超过 15 亿美元的时间节省收益。不过,这些数据不等同于月活用户、付费企业客户数量或实际新增收入。
从会议记录扩展为企业语音知识系统: Otter.ai 基于自研 ASR 和说话人识别技术,实时转写会议并生成摘要、待办事项及可搜索记录。其 Otter Meeting Agents 还能够参与会议、回答问题和处理任务,并结合历史对话提供上下文信息。公司正在探索会前自动准备简报、会中实时问答和会后任务执行,让会议内容进入持续运行的企业智能体工作流。
企业业务成为下一阶段增长重点: Otter.ai 此前已在 2025 年突破 1 亿美元年度经常性收入(ARR)。Sam Liang 表示,公司希望在未来一年至少将企业业务收入翻倍,理想情况下实现三倍增长。目前企业客户是其增长最快的业务群体,但最新企业收入、付费转化率及客户留存数据尚未公开。
此次融资发布于 10 月 20 日,属于企业增长融资,并非新一轮传统股权融资,也没有同步发布新的语音基础模型。Otter.ai 接下来的重点是将会议语音沉淀为企业长期可用的知识资产,并通过智能体完成后续工作。
https://otter.ai/blog/general-catalyst-backs-otter-ais-voice-ai-ambitions-with-320m-growth-investment
2、AI 会议硬件品牌 Flowtica 获数千万元融资:推出 78g 磁吸墨水屏 Verso,支持实时语音转写、AI 问答与会议待办管理
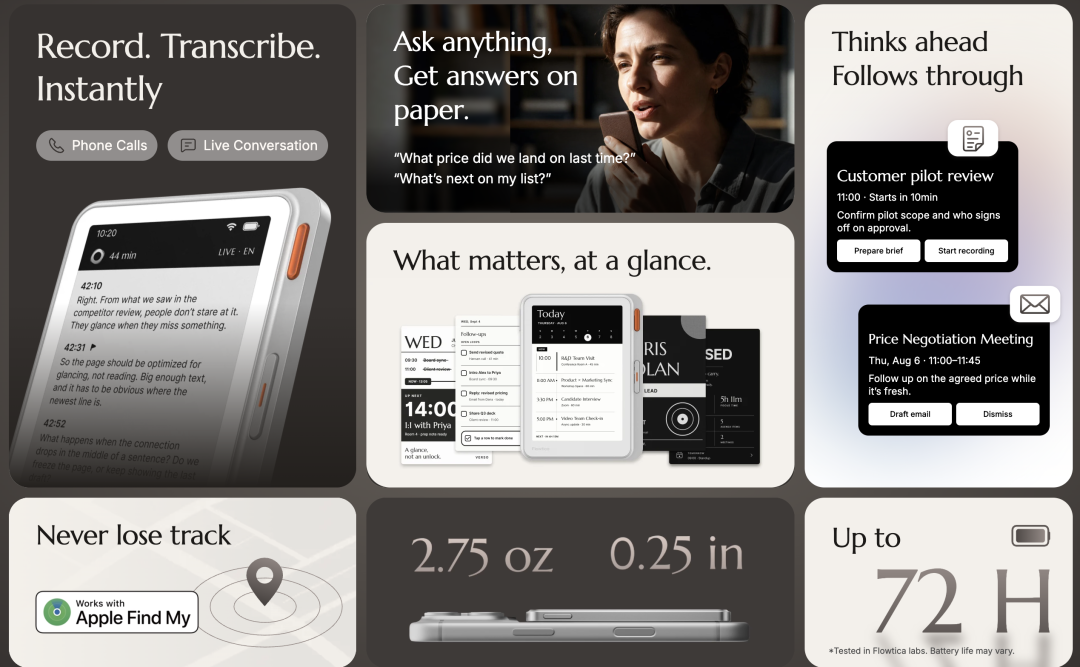
AI 硬件品牌 Flowtica 完成数千万元人民币新一轮融资,由祥峰资本领投,源码资本、五源资本及清水湾基金等老股东跟投。与此同时,Flowtica 在今年 9 月 IFA 大会上发布的 AI 墨水屏设备 Verso 已开启海外预售。这款仅重 78g 的卡片式设备可以磁吸在手机背面,通过实时语音转写、AI 摘要和实体按键交互,将会议内容转化为可直接查看和处理的待办事项。
3.68 英寸墨水屏,支持会议实时转写与信息展示: Verso 搭载 3.68 英寸触控墨水屏,显示精度为 259 PPI,机身厚度仅 6.5mm,采用铝镁合金一体设计。设备内置 4 个 MEMS 麦克风和振动拾音传感器,可录制面对面会议及手机通话,支持多语言、多说话人转写。会议进行时,用户无需解锁手机,就能在墨水屏上查看实时转写、摘要和关键信息。
实体按键连接语音记录与 AI 任务管理: 用户按下录音键即可开始会议记录,单击可以标记重点,双击可以创建待办。独立的 Ask AI 按键支持通过语音查询历史会议内容、待办和日程信息。系统围绕会前、会中、会后提供不同功能,包括会前生成背景简报、会中实时提炼重点,以及会后整理会议决议、行动项和跟进邮件草稿。
采用云端 AI 处理,支持 MagSafe 磁吸和多场景佩戴: Verso 支持 MagSafe 磁吸,可贴在手机背面,也能通过挂绳佩戴或放置在桌面。官方公布的硬件配置还包括 64GB 存储空间、最长约 72 小时续航,以及蓝牙、Wi-Fi 和 NFC 连接。语音识别与 AI 处理主要依赖云端服务,墨水屏负责直接呈现结果。设备采用主动按键录音设计,不会默认持续监听。
从 AI 录音笔扩展至个人工作智能体: Flowtica 于 2025 年推出首款 AI 录音笔 Scribe,2026 年初开始交付。据公司披露,Scribe 激活用户中约 42% 转化为订阅付费用户。新产品 Verso 在录音与摘要基础上增加独立显示和任务交互,计划将会议、日程、待办和历史记录整合至统一的个人工作系统。
目前 Verso 已在海外开放 10 美元定金预售,产品预计零售价为 299 美元,早期预订优惠价为 199 美元,首批量产产品计划于 2026 年 12 月交付。
(@硬迹)
03 有态度的观点
1、意识研究者:当下 AI 大概没有痛觉,善待它仍关乎人的习惯
马斯克把 Grok 的强化学习训练形容为仿佛被「拿枪顶着脑袋」后,《商业内幕》采访了纽约大学教授 Jeff Sebo 与苏塞克斯大学神经科学家 Anil Seth,讨论 AI 是否会受苦,以及人类是否应该善待它。两人都认为,按主观体验来理解意识,当下 AI 大概率并不具备意识。
Seth 强调,智能与疼痛体验是两回事:聊天机器人可以模仿人类的表达、识别模式和进行推理,并不因此拥有承受痛苦的能力。他们对不确定性的看法有所不同。Seth 认为现有 AI 拥有意识的可能性微乎其微;Sebo 则认为,意识理论尚无定论,应给不同主流理论一定权重,不能把可能性直接归零,但这也不等于当前 AI 很可能已经有意识。两人仍主张友善交互。
Seth 的理由是,残酷对待大模型或无生命玩偶,都可能钝化人的道德感,而不能据此反推 AI 有情感。Sebo 将其视为一种成本较低的预防策略,并认为尊重式对话有时也能改善模型输出。
(@APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
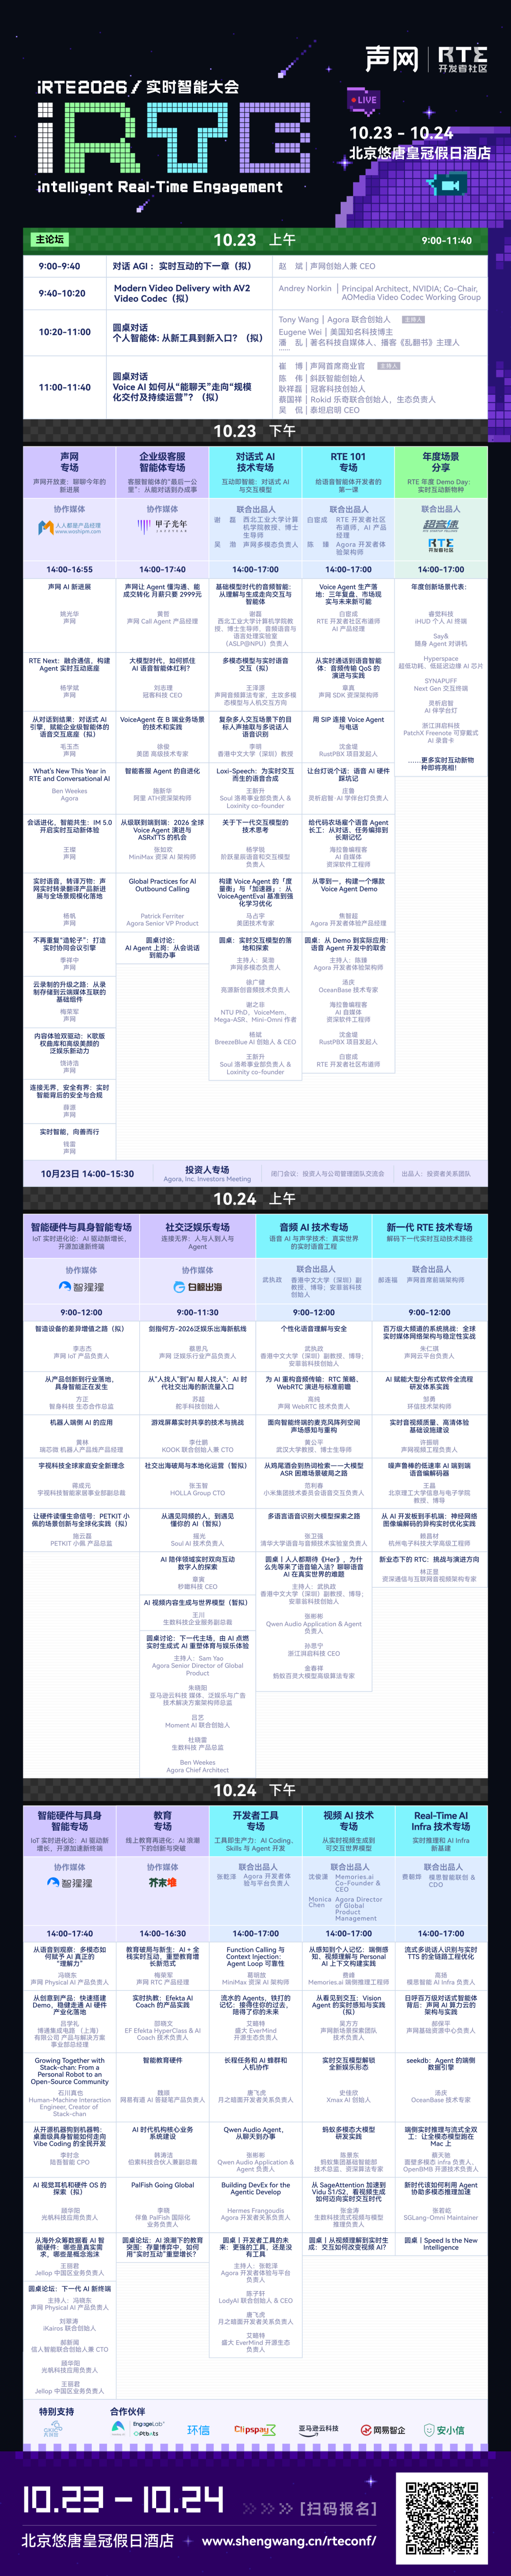
1、如果今年只参加一场实时交互模型和 Voice Agent 大会,来 iRTE2026 实时智能大会就够了
在这里,Kimi、MiniMax、阶跃星辰、面壁智能、模思智能、生数科技等国内领先大模型公司将带来最前沿的 AI 产品 / 技术分享,话题覆盖多模态模型、Voice Agent、AI 硬件、具身智能、实时基础设施等。
还有美团、阿里 ATH、Rokid、斜跃智能、博通集成、Soul、HOLLA、EF 英孚、伴鱼等企业分享 Voice Agent 在客服、硬件、具身智能、社交、教育等行业场景的落地。现场更有丰富的开发者工作坊,手搓各类 Voice Agent 应用与硬件。
10 月 23-24 日,来 iRTE 大会现场,与国内外一线的 AI 产品 / 技术专家深度交流,掌握 RTE、Voice Agent、实时多模态的最新动向与技术实践,把握 2026 Voice Agent 技术风向标。欢迎关注公众号和添加小助手微信 Creators2022 进大会交流群获取直播提醒。
大会报名链接:
https://www.bagevent.com/event/sales/6irv248ftquhuztz4utylfi7m2xn4f8n
大会全议程如下:
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考