索尼推出裸眼 3D 显示器,支持手机直连展示虚拟角色,实时追踪视线调整画面丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、科大讯飞发布语音基座大模型 SparkAudio 1.0:统一解析人声与环境音,采用分层架构优化语音任务
科大讯飞发布基于全国产算力训练的语音基座大模型 SparkAudio 1.0,将语音内容、环境声音、说话人关系及时间序列信息纳入统一音频预训练,支持复杂声场下的音频理解与推理。基于该模型,科大讯飞采用通用语音基座与专用任务模型相结合的分层架构,分别优化语音识别、同声传译及实时语音交互。
统一理解多声源混叠音频: SparkAudio 1.0 支持文本、语音输入和文本输出,覆盖语音转写、多语言翻译、方言识别、环境声识别、说话人分离、情感分析及复杂音频问答。在多种声音混叠的场景中,模型能够综合人声内容、机械噪声等环境线索分析声音来源与场景特征。
SemiEnc 强化复杂环境下的音频表征: 半监督音频解码器 SemiEnc 利用语音专用任务模型提取的强化表征,引入监督信息和多任务训练,增强音频编码器的建模能力,提升语音识别等任务在复杂声学环境下的鲁棒性。
S-S2S 与 CoDec 降低响应延迟和推理成本: 动态分段端到端建模 S-S2S 支持流式语义驱动的提前生成与动态反馈校正,降低语音同传、实时交互的响应延迟。双范式协同解码 CoDec 则结合 CTC 非自回归并行解码与大语言模型按需自回归修正,减少平均推理时延和计算开销。
基座模型支撑三类专用语音任务: 科大讯飞基于 SparkAudio 1.0 构建语音识别模型 Spark-ASR-2.0、语音同传模型 Spark-LiveTranslation 和实时语音交互模型 Spark-Audio-Realtime。其中,Spark-ASR-2.0 结合非自回归识别与大语言模型上下文修正,提升中英混合、方言及高噪声场景的识别能力;Spark-LiveTranslation 引入场景感知、长历史语境理解和动态播报长度控制,官方测试中 MOS 评分较原线上系统由 4.4 提升至 4.6。
(@智东西)
2、扩散语言模型团队 DiffuSpace 开源 MoE 扩散语言模型 Clover-35B-A3B-Preview:Agent 编程评测达 73.6 分,单卡生成速度达 680 tokens/s
扩散语言模型团队 DiffuSpace 发布并开源 Clover-35B-A3B-Preview,采用总参数 350 亿、激活参数 30 亿的 MoE 架构。模型通过重构双向 Gated DeltaNet,提升块级并行生成效率,在智能体编程、工具调用等任务中取得领先于本次对比模型的评测成绩。
重构双向 Gated DeltaNet 架构: 通过递归状态压缩历史上下文,结合块内双向 Softmax 注意力与可学习的块大小校准机制,优化长程信息利用和块级并行去噪。
六项 Agent 评测均位列对比模型第一: SWE-bench Verified 达到 73.6,Terminal-Bench 2.1 达到 51.7,τ³ Overall 达到 65.3,超过本次对比的同规模自回归模型及其他扩散语言模型。
单卡生成速度达到 680 tokens/s: 在内部 Agent 任务测试中,使用单张 NVIDIA GB300、BF16 精度实现 680 tokens/s;单张 H200 达到 515 tokens/s,高于 DFlash2 对照方案的 365 tokens/s。
开源并支持低显存量化部署: 模型采用 Apache 许可,支持 SGLang 和 llama.cpp,已在 16GB 显存的 RTX 5070 Ti 上实现 INT4 量化部署,MATH-500 测试生成速度达到 101.8 tokens/s。
https://github.com/DiffuSpace/Clover-35B-A3B-Preview
3、企业语音 AI 公司 Rime 发布语音到语音模型 Prism:出声前可审查和修改文本,支持企业数据微调
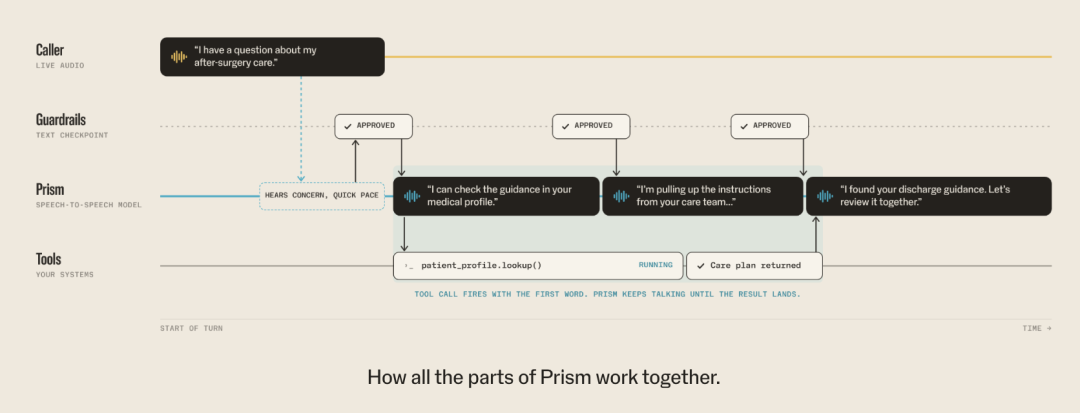
企业语音 AI 公司 Rime 发布语音到语音模型 Prism,将音频理解、文本生成与语音输出整合在端到端架构中。模型直接根据原始音频理解用户意图,同时在语音生成前提供可检查、修改的文本层,让企业能够对语音 Agent 的回复执行规则校验,并保留语气、情绪等声音信息。
在语音输出前加入文本审查环节: Prism 先基于音频生成回复文本,允许企业在出声前执行安全规则、内容修改、专有名词发音控制及工具调用管理,无需将用户语音先转写为文本再进行理解。
τ-Voice 评测达到 56.6 分,首段语音延迟为 0.57 秒: 在 Rime 使用的 Artificial Analysis 评测框架下,Prism 在无需预先推理的实时模型中取得较高成绩,电信客服任务得分 82.5,GPT-Live-1 为 45.6,并支持工具调用与语音输出并行执行。
支持使用企业通话数据进行强化学习微调: Rime 使用 Revmo 的 10 小时真实通话数据、工具调用记录和转写文本训练定制模型,订单操作前征得用户确认的比例达到 94%,对照模型为 57%。模型支持本地、私有云及云端部署,目前处于私人测试阶段,自助 RL 和 SFT API 仍在开发中。
https://www.rime.ai/resources/prism-first-speech-to-speech-for-enterprise
4、开源项目 Python WebRTC :将 Chrome 原生 WebRTC 引擎引入 Python,数据通道吞吐最高达 2.1 Gbps
开发者 MarshalX 发布 Python WebRTC 0.1.0,这是该项目的首个 Beta 版本。项目通过 Python 绑定 Chrome 使用的原生 libwebrtc M152 引擎,并提供与浏览器 W3C 标准对应的 API,使开发者能够直接使用 Python 构建实时音视频通信、P2P 数据传输及语音智能体应用。
将 Chrome WebRTC 引擎接入 Python: 提供 RTCPeerConnection、DataChannel、媒体轨道、WebCodecs 和加密媒体变换等接口,底层 ICE、DTLS、编解码和拥塞控制仍由原生引擎执行,避免通过 Python 处理底层媒体数据包。
数据通道吞吐达到 1.2–2.1 Gbps: 项目基准测试显示,吞吐量为 aiortc 的 7.7–14.6 倍;数据通道在调用 createOffer 后约 3.5 毫秒打开,速度提升约 7–8 倍。
新增多编码器联播与 H.264 故障恢复: 0.1.0 为各类编码器增加 Simulcast 支持,并在 macOS 上实现 VideoToolbox 编解码故障恢复及 OpenH264 回退。
提供 Python 原生开发接口与跨平台安装: 支持 asyncio、Linux、macOS 和 Windows,可通过
pip install wrtc安装,并提供 aiortc 兼容层,便于现有项目迁移。
https://github.com/MarshalX/python-webrtc
5、开发者 honwee 开源实时数字人系统 Mynah:支持 WebRTC 语音对话、视频训练数字人及单 GPU 自托管部署
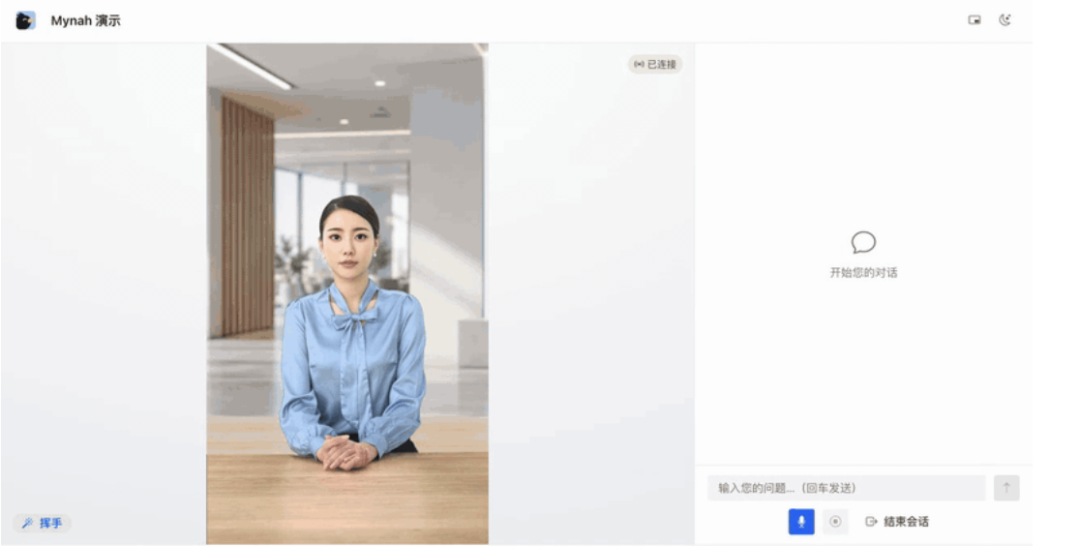
开发者 honwee 开源自托管实时数字人系统 Mynah,集成语音对话、口型同步视频生成、知识库和管理控制台,采用 Apache 2.0 许可证。系统通过 WebRTC 实时传输音视频,支持替换数字人、语音识别、语音合成和大语言模型引擎,可部署在自有服务器并向客户发布数字人服务。
实时语音驱动数字人视频: 基于 Go 实时通信核心与 Python 推理服务,通过 WebRTC 传输同步音视频,支持语音打断、语义轮次检测和口型同步。官方测试中,MuseTalk 1.5 引擎从用户说话结束到首段同步音视频输出约需 0.40–0.72 秒。
支持从视频训练数字人和声音克隆: 可上传人物视频提取数字人形象,生成待机动画,并通过可替换的 FlashHead、MuseTalk 等引擎驱动;支持接入 Qwen3-TTS 等语音克隆方案。
内置管理控制台与知识库: 提供 RAG 知识库、数字人及声音配置、频道发布、访问控制和会话监控,并通过 gRPC 与兼容 OpenAI 的 API 接入第三方模型及服务。
单 GPU 即可部署,支持远程推理: 轻量级 wav2lipLS 方案可运行于 6GB 显存显卡,FlashHead、MuseTalk 方案建议使用 12GB 显存;无本地 GPU 时可连接远程推理服务。项目提供 Docker Compose 和一键安装向导。
https://github.com/honwee/mynah
02 有亮点的产品
1、索尼发布 6 英寸桌面裸眼 3D 显示器 ELF-MN1:手机直连展示虚拟角色,实时追踪视线调整立体画面
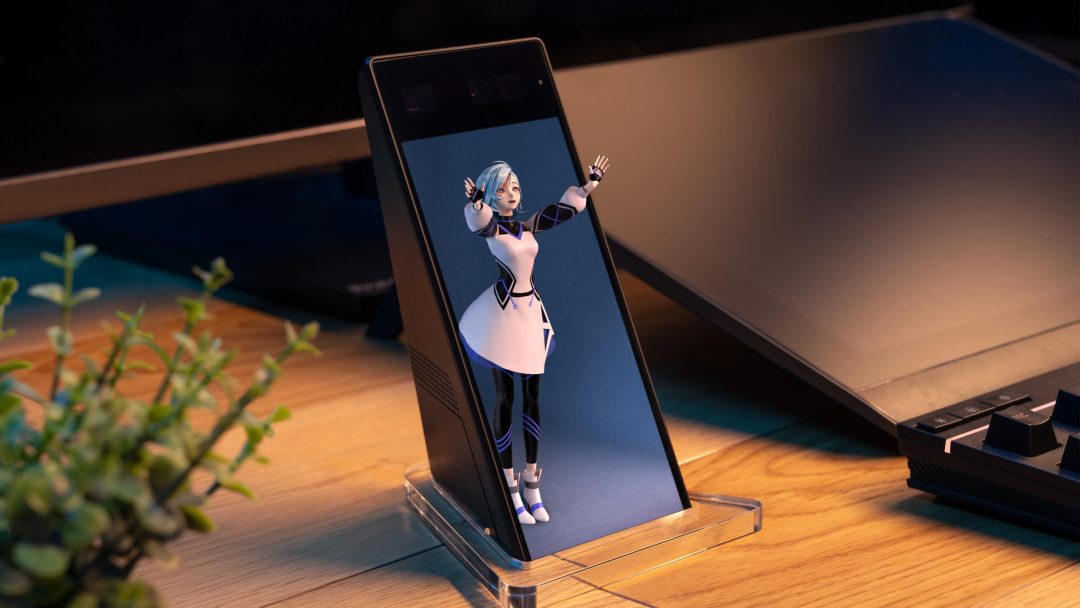
索尼推出 XYN 空间内容产品线的新款空间现实显示器 ELF-MN1,将此前主要面向专业场景的裸眼 3D 显示技术带入桌面设备。产品采用 6 英寸屏幕,可通过 USB-C 直连手机或电脑,无需佩戴眼镜或头显,即可在桌面上立体呈现虚拟角色、数字人及 3D 空间内容。
6 英寸桌面设备呈现裸眼 3D 内容: 支持展示虚拟角色、3D 数字手办及 XYN 空间捕捉生成的物体,让空间内容以立体形式出现在日常桌面环境中。
实时追踪视线调整立体画面: 在原有眼部追踪系统中新增红外传感器,提升暗光环境下的追踪精度,并采用索尼空间现实显示器中最高的 403ppi 像素密度,减少画面重影。
支持手机直连与跨平台内容开发: 通过支持 DisplayPort Alt Mode 的 USB-C 线连接 Windows PC、iOS 或 Android 设备。索尼同步提供 SDK 和 Unity 插件,支持开发自定义空间显示应用。产品将于 12 月 11 日在日本上市,预计售价约 54,000 日元。
https://xyn.sony.net/en/news/2026-srd-elf-mn1_release
2、Django 联合创始人 Simon Willison 使用 Claude Opus 5.5 构建浏览器实时战略游戏 Battle Drones:通过音频信号实现双人联机,支持 AI 模型对战
开发者 Simon Willison 主要使用 Claude Code 和 Claude Opus 5.5 开发了类似《命令与征服》的实时战略游戏 Battle Drones,可直接在手机和电脑浏览器中运行。游戏通过扬声器和麦克风交换音频信号,实现附近设备之间的实时双人对战,并进一步加入在线联机及大语言模型对战功能。
通过音频信号实现设备间实时对战: 利用浏览器麦克风和扬声器传输游戏状态,无需服务器即可让附近设备联机。由于持续发出的高频声音可能引起不适,作者随后新增基于 WebSocket 中继服务器的在线多人模式,支持通过链接或二维码邀请好友。
Claude Opus 5.5 参与游戏开发与 3D 建模: 项目经过 12 次主要迭代、321 次代码提交,从 Phaser 2D 原型升级为 Three.js 3D 游戏,所有 3D 模型及动画均由 Claude 生成,并通过超过 1000 场模拟对战优化游戏平衡。
支持两个大语言模型相互对战: 游戏每隔 5 秒暂停一次,让两个 AI 模型分别读取战场状态、思考策略并提交操作指令,再继续运行。作者展示了 Claude Haiku 5.5 与 GPT-6 Luna 的对战回放。
博客:
https://simonwillison.net/2026/Oct/20/battledrones/
Haiku 5.5 对战 GPT-6 Luna 的比赛回放链接:
https://simonw.github.io/battledrones/v11/?replay=battles/showcase/2026-10-14-frostbite-42-claude-haiku-5.5-vs-gpt-6-luna.json
03 有态度的观点
1、99 元小米遥控器被用来语音写代码,第三方工具打通电脑输入
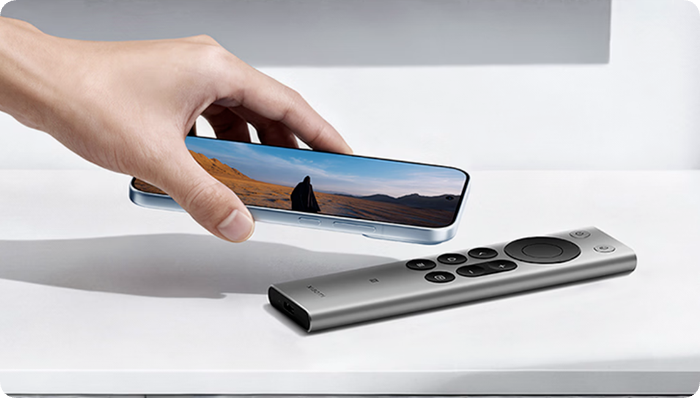
据界面新闻报道,原本配套电视的小米蓝牙遥控器 2 Pro,被部分用户改造成了 Vibe Coding 的语音输入手柄。这款定价 99 元的遥控器自带麦克风和独立语音按键,用户借助 SayAll 等第三方工具,将它连接到电脑,用语音向 AI 编程工具描述需求。
SayAll 项目说明显示,小米遥控器采用「按住收音、松开停止」的方式,Mac 端需配合虚拟麦克风或回环音频设备,并在语音输入应用中选择同一音频设备。
普通按键可映射为复制、切换应用等快捷操作。Windows 预览版也支持小米遥控器 2 和 2 Pro,目前语音输入仅支持微信输入法。这套玩法依赖第三方软件及权限配置,属于用户拓展的新用途。遥控器本身负责采音和触发输入,语音识别及代码生成由相应输入工具与 AI 编程软件完成。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 在 RTE 开发者社区,一起学习和体验前沿全双工语音模型
RTE 开发者社区联合 MOSS-Live 团队,面向社区开放一批提前内测名额。全双工实时交互系统 MOSS-Live 将于下周正式发布,特别邀请关注 Voice Agent、正在开发语音交互应用或探索相关落地场景的开发者抢先体验,并直接向团队反馈使用感受和需求。参与内测的开发者还将获得 MOSS API 平台 1000 积分,感兴趣的朋友可以联系小助手 Creators2022 加入内测群。
2、社区活动推荐|开物基地 OPENLAND 发布开放日暨优质项目路演
倒计时 1 天!从开源创新到全球增长开放日
有人徘徊,有人犹豫;
有人看到又略过,有人在等待机会。
一切可能,从入场开始。
一些新的机遇也交流中出现。
明天,上海张江 AI 创新小镇服务中心,
不见不散!
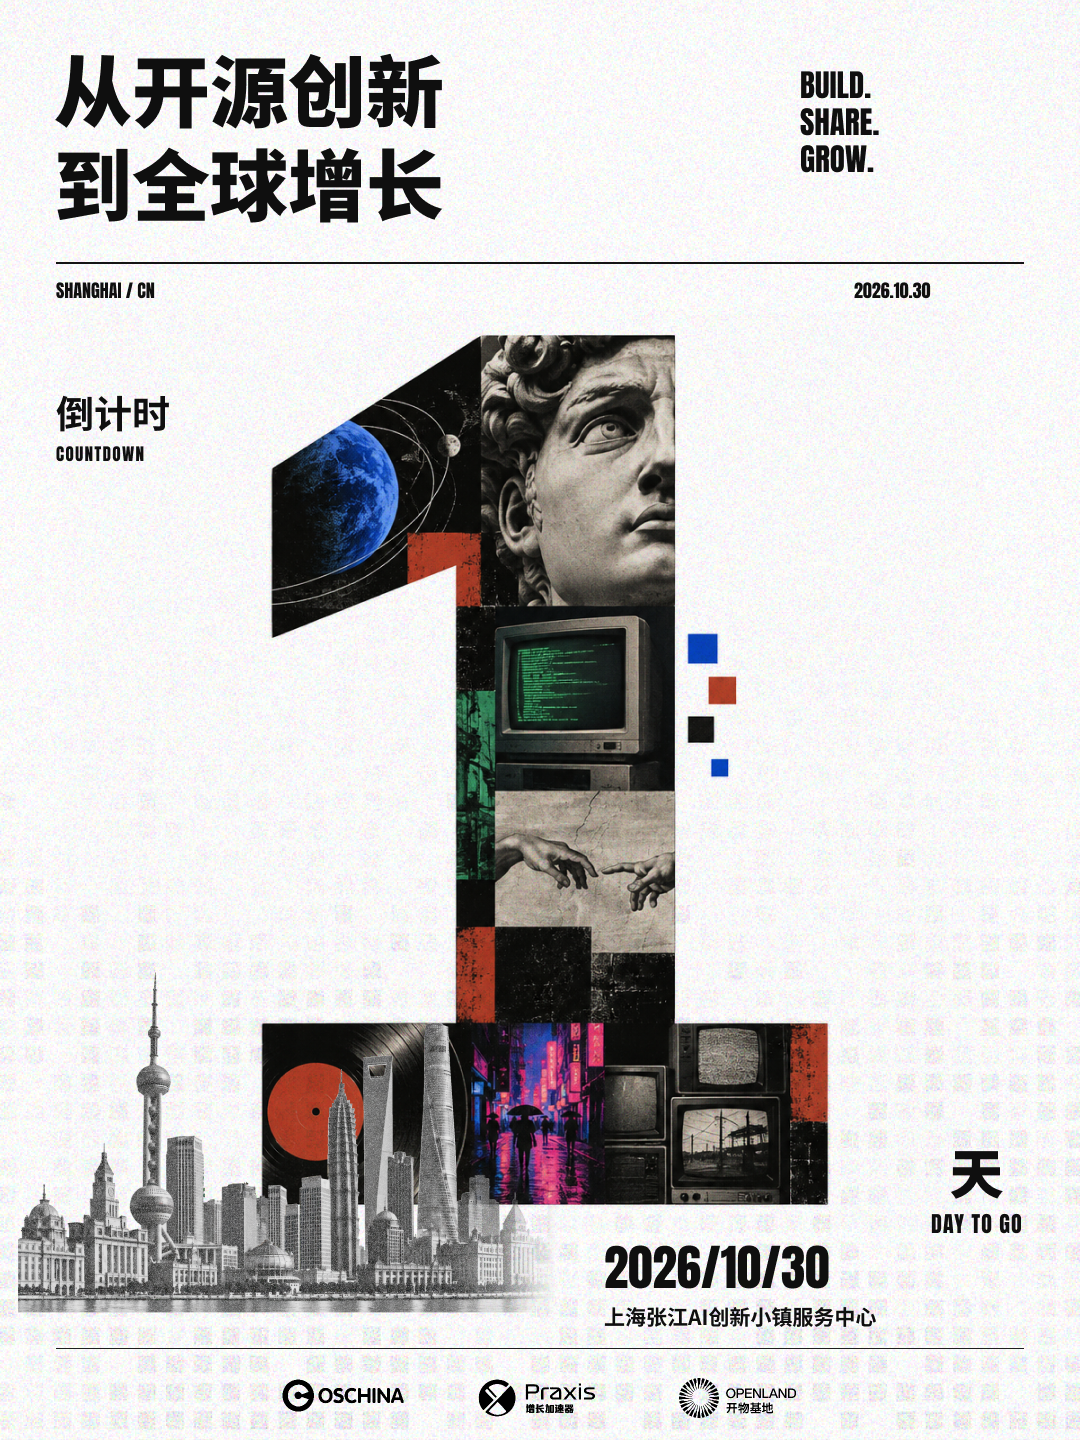
从开源创新到全球增长|开物基地 OPENLAND 发布开放日暨优质项目路演
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么