社区实践:用Gemini 3.8 TTS + Agora 做个实时互动 AI 播客
Gemini 3.8 TTS 发布:声音定制与语音生成能力升级
9 月 23 日,Google 发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 两款文本转语音模型,带来更灵活的声音定制和表达控制。
Agora 作为 Google 的合作伙伴,支持通过 Gemini API 集成 Gemini 3.8 Flash TTS,开发者可以结合 Agora RTC 构建实时语音应用。
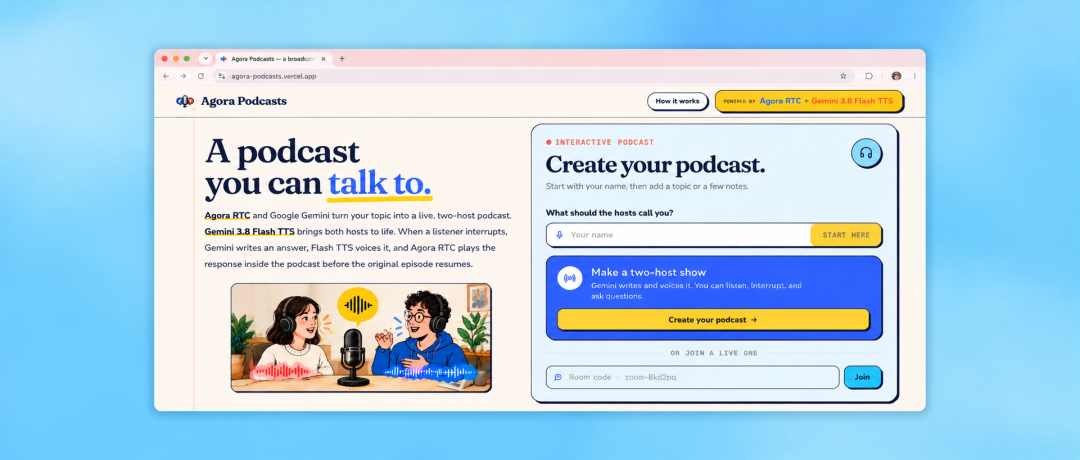
本文将介绍 Gemini 3.8 TTS 的核心特性,并以开源项目 Agora Podcasts 为例,展示如何将主题或文章生成双主播节目,让听众实时收听、举手提问,并在主播回答后继续原来的内容。
两款模型,声音定制与规模化生成
两款模型各有侧重。
Flash TTS 适用于需要深度声音定制和角色塑造的场景;
Flash-Lite TTS 更适合大规模内容生成,在优化成本效率的同时,保留对语气、节奏和情绪表达的控制能力。
从声音设计到逐句表达控制
两款模型都支持逐句控制语音表达。
开发者可以在文本中加入表达要求,调整每句内容的语气、节奏和情绪,具体包括:
1.声音设计:用文字定义角色声音
Flash TTS 支持通过自然语言描述声音特征、角色定位和口音,帮助开发者设计符合场景需求的声音。开发者也可以从 2,000 多种声音中选择合适的音色,并保存设计结果,在后续内容中持续复用。
例如,为课程讲解员设计声音时,可以描述为“音色温暖、吐字清晰、使用普通话”;为故事中的角色设计声音时,则可以进一步指定角色特点和口音。
Flash TTS 还支持声音复刻:通过一段 30 秒的本人或已获授权的声音样本,创建可复用的声音。
2.逐句控制:让表达更贴合内容
两款模型均支持逐句控制语音表达。开发者可以针对不同台词设置语气、节奏和情绪,使同一角色在开场、讲解、互动等不同场景中呈现更自然的表达效果。
例如,一段课程开场中,“欢迎回来”可以读得轻快一些;进入复杂概念时,可以放缓语速、增加停顿;提出问题时,再调整重音和语调。
3.双人对话与长音频:保持角色和内容的连贯性
除了单人语音生成,两款模型还支持以下能力:
双人多轮对话: 通过一份脚本生成双人对话,区分两种声音,并安排自然的轮流发言,可用于播客或故事演绎。
声音细节: 在脚本中加入笑声、叹息、吸气声和简短回应,补充台词之外的表达。
长音频生成: 据发布介绍,可在数小时的连续音频中保持较稳定的音色和自然节奏,减少前后声音不一致的情况。
制作长内容时,除了确认单句效果,也需要检查不同段落之间的音色、语速,以及双人对话的衔接是否符合脚本安排。
性能参数
1.综合质量
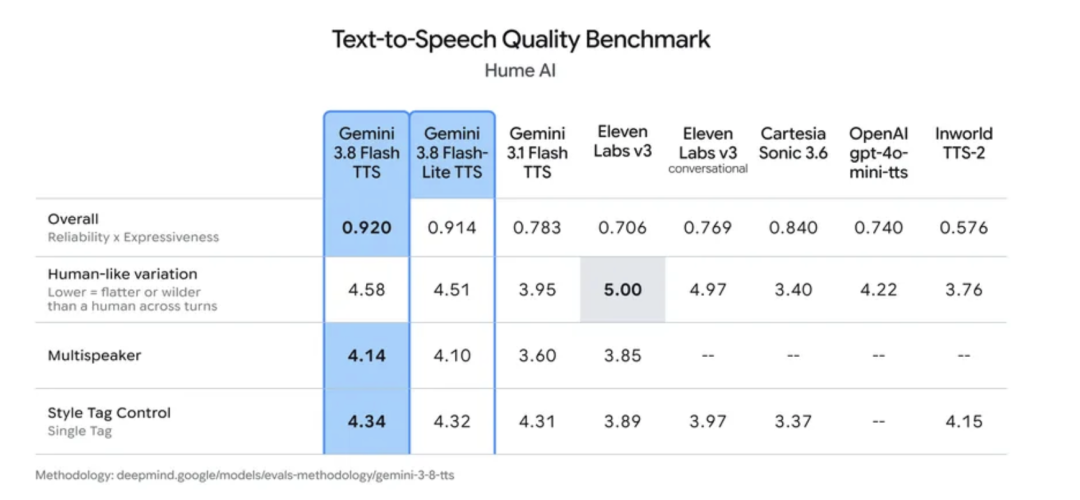
综合来看,Flash TTS 和 Flash-Lite TTS 分别以 0.920 和 0.914 位列第一、第二,明显高于上一代 Gemini 3.1 Flash TTS 的 0.783。
两款模型的多说话人表现分别为 4.14 和 4.10,高于上一代的 3.60,说明它们更适合生成双人对话。两款模型的类人语音变化也高于上一代,跨多轮表达时更接近真人。单一风格标签控制则分别为 4.34 和 4.32,较上一代略有提升。
2. Flash TTS 声音设计能力突出
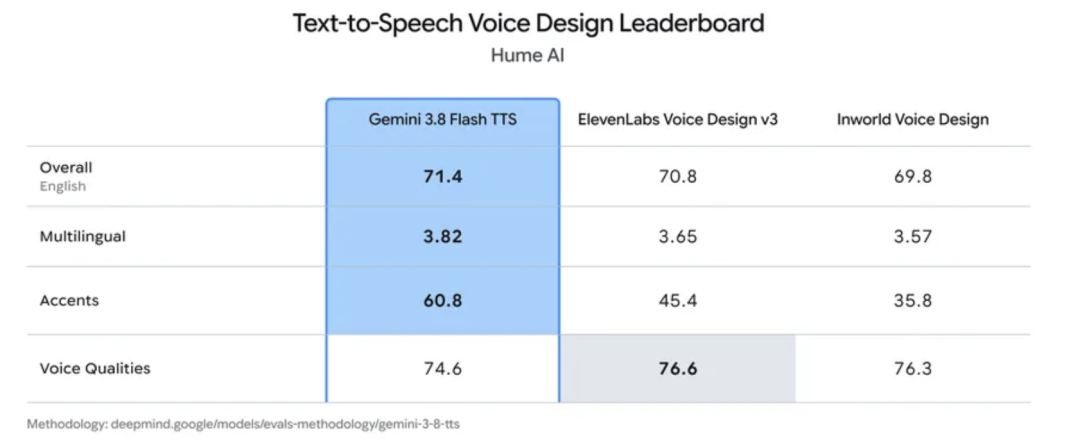
在 Text-to-Speech Voice Design Leaderboard 列出的模型中,Flash TTS 的英语综合得分为 71.4,位列第一;多语言得分为 3.82,口音得分为 60.8,两项也都排名第一。
3.多语言表现
在 Voice Arena 的多语言榜单中,两款模型在 7 种语言中分别取得最高分:
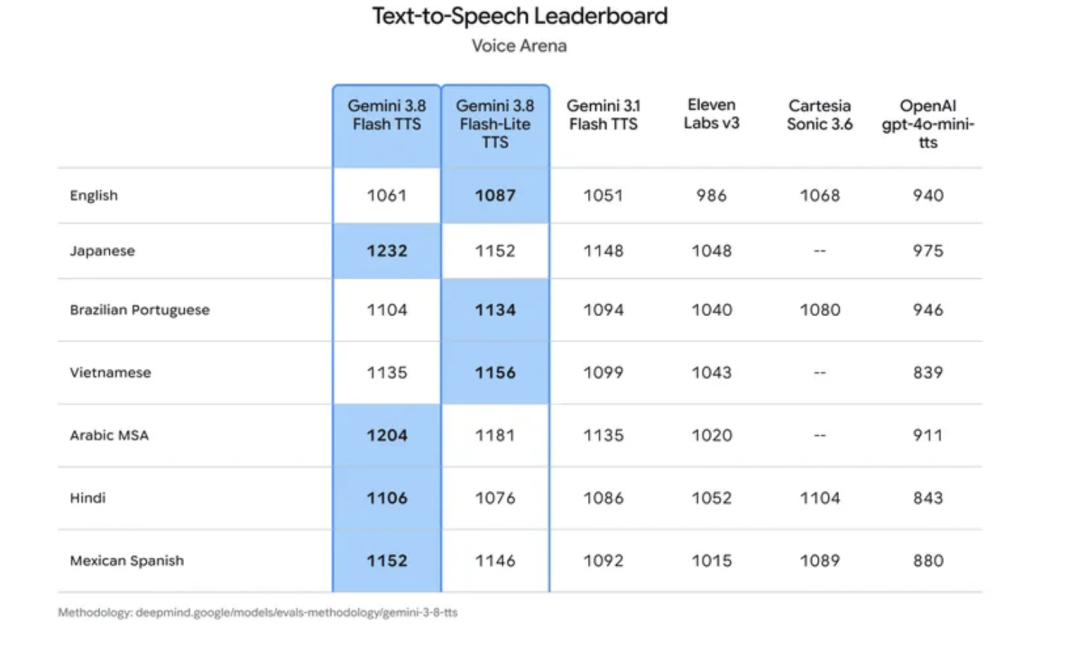
Gemini 3.8 TTS 的优势并不局限于英语。两款模型在 7 种语言中都拿到过最高分:Flash TTS 在日语、现代标准阿拉伯语、印地语和墨西哥西班牙语中领先,Flash-Lite TTS 则在英语、巴西葡萄牙语和越南语中得分最高。
对于需要多语言配音、播客或语音智能体的开发者,可以根据目标语言选择模型,而不必只依赖单一模型覆盖所有场景。
开发者体验与接入
开发者可在 Google AI Studio 音频工作台体验声音设计、声音复刻和双人脚本编辑,也可通过 Gemini API 接入应用。
社区实践:Gemini 3.8 TTS 实时互动 AI 播客
模型正式发布后,有社区开发者基于 Gemini 3.8 Flash TTS 制作了一个实时 AI 播客 Demo。
该项目基于 Agora RTC + RTM,搭建了一个可以多人加入的 AI 播客,它支持:
多人同步收听:多个听众可以进入同一房间,实时收听同一场 AI 播客。
随时加入对话:听众可以举手插话,Gemini 3.5 Transcribe Live 会实时转写语音。
双人主持人即时回应:Gemini 3.8 Flash TTS 驱动两位 AI 主持人根据问题生成并播回答。
节目自动恢复:互动结束后,原节目自动继续播放,保持完整的收听流程。
与 NotebookLM 的交互式音频相比,这个示例把个人问答扩展成了多人共享的现场。 NotebookLM 允许用户加入音频概览、向 AI 主播提问,但其他人不能通过共享链接加入这段互动。Agora Podcasts 则让多位听众进入同一个实时房间:大家共同收听,也可以依次举手提问;一个人的问题和主播的回答,其他人也能听到。
与 Clubhouse 的真人语音房相比,这里的对谈主播由 AI 担任。 Clubhouse 让人们进入房间,围绕话题展开实时交流;Agora Podcasts 则由两位 AI 主播组织节目内容、展开对谈,并回应听众的提问。它保留了多人共同参与的语音房体验,也让 AI 从内容生成工具变成了房间里的对话参与者。
GitHub 链接:
https://github.com/zicojiao/agora-podcasts
架构概览
Gemini 3.8 Flash
生成双主播脚本
    │
    ▼
Gemini 3.8 Flash TTS
生成双主播音频
    │
    ▼
Agora RTC
广播给房间内听众
    │
    ├── 听众收听
    │
    └── 听众插话
            │
            ▼
    Gemini 3.5 Transcribe Live
    将语音转成问题
            │
            ▼
    Gemini 3.8 Flash + Flash TTS
    生成并播回答
            │
            ▼
        Agora RTC
        原节目恢复播放

Agora Signaling / RTM:同步举手、问题、聊天和房间状态
Next.js 服务端:转发模型请求并保管密钥
项目采用 Next.js,前端页面和服务端 API 在同一个应用中运行。服务端保管 Gemini API key 与 Agora App Certificate,浏览器负责节目播放、实时音频和房间交互。
房主浏览器通过 AudioWorklet 播放并发布节目音轨,同时管理原节目与插入回答的切换。听众确认问题后,服务端调用文本模型生成回答,再由 TTS 配音;回答播放完毕,原节目从暂停位置继续。因此,房主页面需要在节目期间保持打开。
环境准备
开始前需要准备以下环境和凭证。
Node.js 22+ 和 pnpm:用于安装依赖和运行项目。
Agora 账号:创建一个已启用 RTC 与 Signaling 的项目,并准备 App ID 和 App Certificate。App Certificate 只放在服务端,用于签发 Token。
Gemini API key:确保可以访问
gemini-3.8-flash、gemini-3.8-flash-tts和gemini-3.5-transcribe-live三个模型。
本地启动
获取代码并安装依赖
git clone https://github.com/zicojiao/agora-podcasts.git
cd agora-podcasts
corepack enable
pnpm install --frozen-lockfile
cp env.local.example .env.local
配置环境变量
打开 .env.local,填入 Gemini 和 Agora 配置:
GEMINI_API_KEY=你的-Gemini-API-key
GEMINI_TTS_MODEL=gemini-3.8-flash-tts
GEMINI_TEXT_MODEL=gemini-3.8-flash
NEXT_PUBLIC_AGORA_APP_ID=你的-Agora-App-ID
NEXT_AGORA_APP_CERTIFICATE=你的-Agora-App-Certificate
GEMINI_TTS_MODEL 和 GEMINI_TEXT_MODEL 已有默认值,通常不需要修改。转写模型固定为 gemini-3.5-transcribe-live,只需确保 API key 拥有对应权限。
启动项目
先运行环境检查:
pnpm run doctor
检查通过后启动开发服务器:
pnpm run dev打开 http://localhost:3000,输入显示名称并创建房间。
邀请听众,并完成一次插话
创建房间后,输入一个主题或一篇文章,等待双主播节目生成。同时也可以将房间链接分享给他人,点击 Start listening 后,即可共同收听节目。
听众点击 Join conversation 后,则可以向 AI 通过语音进行提问。在不方便进行语音沟通时,也可以通过 Type it instead 输入问题。当主播回答结束后,原节目则会自动继续。
生产环境部署
由于项目是 Next.js 服务端应用,不能使用静态托管,因此需要部署到托管平台:
创建一个支持 Next.js 服务端运行的应用。
设置与
.env.local相同的环境变量。执行构建并启动生产服务:
pnpm run build
pnpm run start
上面的命令来自仓库的 package.json。仓库没有提供特定云平台的一键部署配置,本教程也没有实测具体托管平台。
验证
部署前可以运行完整验证:
pnpm run verify该命令会依次执行环境检查、代码检查、类型检查、功能验证和生产构建。
如需调用真实 Gemini API 做冒烟测试,可以运行:
pnpm run smoke这个命令会消耗 Gemini API 配额,请按需运行。
最后
此 Demo 展示了一条从内容生成到实时互动的完整路径:Gemini 编写并演绎双主播节目,Agora 将节目带入共享房间,听众可以加入对话,提问后继续收听。
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么