阶跃发布 StepAudio 3 系列,全双工模型可边聊边调用工具丨日报
本期编辑:@三水、@鲍勃
01 有话题的技术
1、阶跃发布 StepAudio 3 系列:全双工 Realtime 可边聊边跑调用工具,Gen 统一生成人声、音效与音乐
阶跃星辰发布 StepAudio 3 系列,一次上线 Realtime、ASR、TTS、Gen 和 Music 五款模型。相比此前主要围绕实时语音对话和单项生成能力迭代,StepAudio 3 开始覆盖从实时听说与任务执行,到语音识别、真人级 TTS、完整音频生成和音乐创作的一整套音频工作流,其中五款模型均已开放 API。
Realtime 把全双工进一步接到 Agent 执行: StepAudio 3 Realtime 采用持续的“听—聊—想—做”循环,可处理停顿、附和和中途打断;更值得关注的是,Tool Call 和长任务可以异步执行,不阻塞当前语音会话,用户可以继续交谈,任务完成后再把结果带回当前上下文。其技术报告在 Artificial Analysis Full Duplex Bench 上取得 98.9% 综合得分。
ASR 从纯转写进一步引入上下文理解: StepAudio 3 ASR 面向中英混说、方言、长音频和专业领域,将语言模型的知识与上下文理解用于人名、地名和专业术语识别。阶跃称其在 Artificial Analysis 非流式 ASR 榜单中取得 1.7% WER;该榜单当前以 AgentTalk、VoxPopuli 和 Earnings22 三组数据综合计算词错误率。
Gen 把原本分开的声音生产环节统一到一个模型: StepAudio 3 Gen 可以在同一套离散自回归框架中生成人声、歌声、音效、环境声、音乐及它们的混合内容,并控制不同声音出现的时序。其技术报告显示,模型使用统一的 RVQ 音频表示,而不是当前常见的连续扩散 Transformer 路线。
TTS 与 Music 更强调进入真实创作流程: TTS 可根据语义自动调整语气、节奏和情绪,并生成笑声、迟疑、结巴、改口等副语言表现;Music 除文字生成歌曲外,还支持歌词、清唱、参考歌曲和 ABC 记谱法输入,可围绕已有旋律继续编曲和多轮修改,而不是只做“一句话抽一首歌”。
StepAudio 3 Home Page:
https://static.stepfun.com/blog/stepaudio3/
阶跃语音体验中心:
https://www.stepfun.com/studio/audio
2、语音 AI 数据与评测公司 Besimple AI 发布全双工语音评测基准:不只测「停不停」,开始评估 Agent 能否边说边吸收纠正
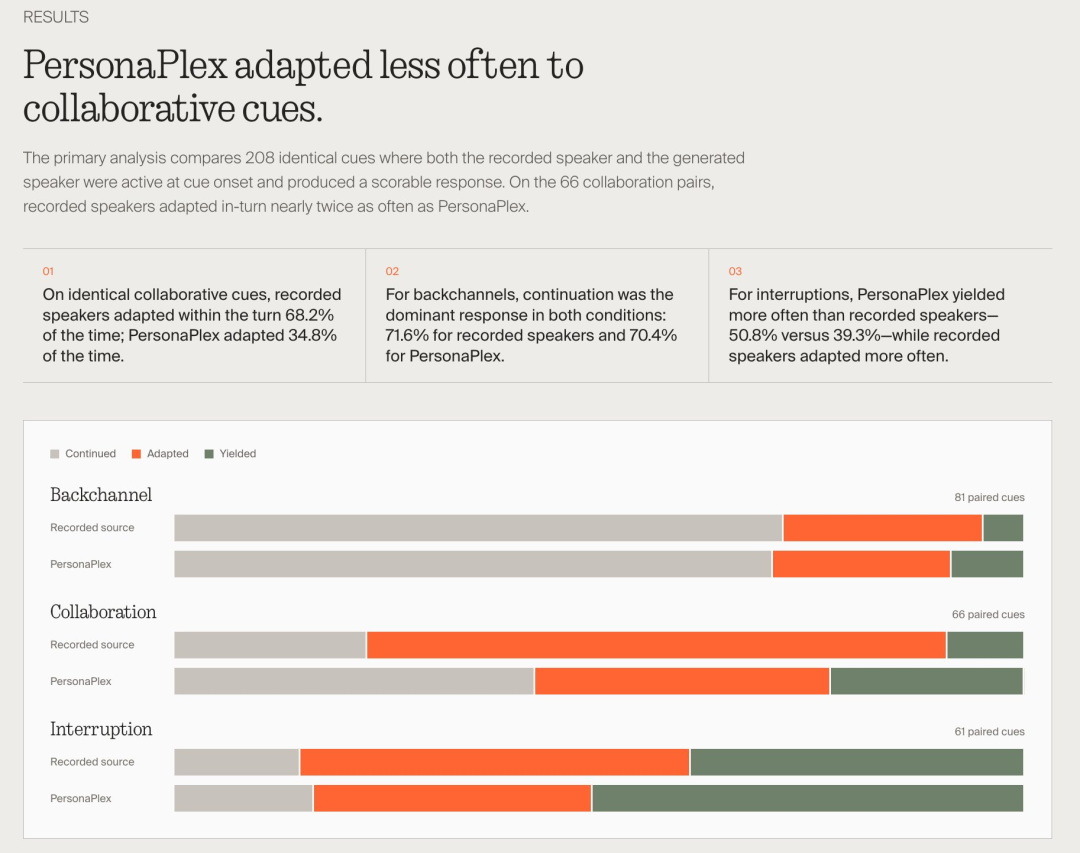
Besimple AI 发布全双工语音评测基准 Duplex Cue,专门测试 Voice Agent 在自己仍在说话时,能否理解并吸收听者突然插入的补充、纠正或提示。不同于现有全双工评测常把行为简化为「继续说」或「停下来」,Duplex Cue 增加了话轮内适应这一维度:Agent 可以保持话轮,同时根据对方刚说的话即时修改自己的后续表达。
把听者意图和 Agent 反应拆开评测: Duplex Cue 将听者插入的语音分成附和、协作和打断三类,再分别判断正在说话的一方是「继续原话」「边说边适应」还是「让出话轮」。
评测基于真实双人自然对话: 完整研究包含 80 段无脚本英文对话、20.32 小时音频和 2,591 个经过审核的重叠语音事件,并从中选出 300 个经人工确认的标准测试样本。
PersonaPlex 在「协作性插话」上的适应能力明显低于真人: 在 66 组双方都保持发声且可评分的协作样本中,真人有 68.2% 的情况会继续说话并吸收对方提供的信息,而 PersonaPlex 只有 34.8%。
「会被打断」不等于「会合作」: 当听者提供答案、纠正、限制条件或补全内容时,当前全双工模型的主要短板并不只是打断检测,而是能否在保持话轮的同时实时吸收新信息。
https://besimple.ai/blogs/duplex-cue
https://huggingface.co/datasets/besimple-ai/duplex-cue
3、联发科研究院、台大、英伟达等提出全双工语音模型 TASTE2:文本词元逐一对齐音频表示,可流式听说并处理中途打断
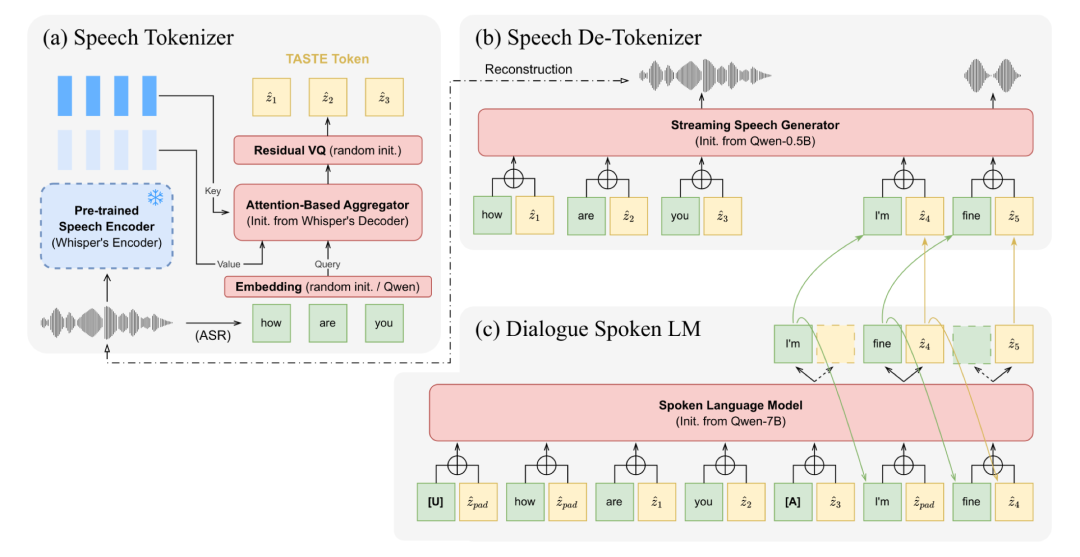
联发科研究院、台湾大学、英伟达等团队提出 TASTE2,把此前面向单段语音建模的 TASTE 扩展为增量式全双工对话系统。其核心不是把文本 Token 和音频 Token 交错塞进语言模型,而是让每个文本词元对应一个连续音频潜在表示,尽量保持原有文本模型的序列结构和语言能力,同时加入流式语音输入、输出与打断处理。
从单段语音建模推进到增量式全双工对话: TASTE2 由语音编码器、Spoken LM 和增量语音解码器组成,可以随着用户语音到达持续处理,而不是等完整一句话结束后再开始生成;配套的 TASTE2 VoiceBot 可流式合成回复,并在检测到用户插话时停止当前生成。
不再交错不同类型的语音、文本 Token: TASTE2 使用共享的文本词元词表,并为每个文本词元预测一个连续音频潜在表示,使语音序列长度与文本序列保持对齐。团队希望借此减少传统语音语言模型中不同模态 Token 交错带来的语义能力损失。
转成语音模型后仍保留大部分文本能力: 基于 Qwen2.5-7B-Instruct 的 TASTE2 Merge 在 LLaMA-Questions 上达到 56.3%,接近原文本模型的 57.3%,相当于保留 98.2% 的准确率;Direct 方案则达到 53.0%。
开始验证「能听懂打断」之外的声音表达能力: 除话轮切换和打断外,团队还测试了语速、情绪等副语言信息的显式控制。其中快速语速已能较稳定控制,但情绪控制仍依赖具体训练策略,其他声音属性表现仍较弱。
代码、模型与 VoiceBot 已开放,但实时性仍有明显优化空间: 在两张 NVIDIA RTX A6000 上经过 TensorRT 加速后,TASTE2 VoiceBot 的平均首次音频时间仍为 2.701 秒,论文将语音生成延迟和自然对话稳定性列为后续需要解决的问题。当前模型仅面向研究用途开放。
https://gitycc.github.io/TASTE2-Homepage/
4、语音 AI 研究实验室 Oruk 拆解「声音里的微笑」:移除一条内部表征,247 段「快乐」语音中 172 段失去标签
a16z Speedrun 支持的语音 AI 研究实验室 Oruk 公布一项针对语音情绪模型的可解释性实验,研究其 Fourier 模型为什么会给一段声音打上「happy」标签。团队在模型内部找到一条与该标签高度相关的表征方向,将其从内部状态中移除后,原本 247 段被标记为「happy」的录音中,有 172 段失去该标签;而随机移除其他方向,平均只会让约 3% 的标签消失。
不是在识别人脸,而是在寻找「微笑声音」的内部表征: 人在微笑时,嘴唇和声道形状变化会改变声音的声学特征。Oruk 研究的是模型是否把这类声音模式编码成了稳定的内部方向,以及该方向是否真正参与「happy」标签的判断,而不是直接测量说话者有没有做出微笑表情。
直接干预模型内部状态,会大面积改变情绪判断: 移除这条学到的内部表征后,247 个「happy」样本中有 172 个失去标签;作为对照,团队对 64 个随机方向做相同操作,平均仅约 3% 的标签受到影响,说明模型内部确实存在与「happy」判断高度相关的特定表示。
只在录音前加 0.5 秒静音,也能大幅翻转标签: 团队又在 546 段录音前加入 0.5 秒静音,原始语音内容完全没有变化,但仍有 153 个「happy」标签消失、8 个新增。这说明语音情绪模型的判断并不只取决于那段「人在怎么说话」,还会受到输入边界和前置声学上下文影响。
也暴露了语音情绪识别的一个重要边界: Oruk 的 emotion label 本质上是对声音表达方式的模型标注,而不是对真实心理状态的读取。即使模型捕捉到了稳定的「快乐声音」模式,前置静音这样的微小输入变化仍可能显著改变输出,因此 Voice Agent 在把情绪标签用于回复策略时,不能把单次分类结果直接当成用户真实情绪。
https://oruk.ai/research/how-to-hear-a-smile
02 有亮点的产品
1、前 Apple Vision Pro 研究员创立的视听 AI 公司 Nuance Labs 完成 5000 万美元 A 轮:押注单一全双工模型,同时处理语音、表情与动作
Nuance Labs 完成 5000 万美元 A 轮融资,由 Lightspeed Venture Partners 领投,Accel、South Park Commons、Nvidia 旗下 NVentures 和 Define Ventures 参投。公司正在开发一个单一的全双工视听基础模型:不再把 ASR、LLM、TTS 和数字人生成拆成多级流水线,而是让同一个模型实时观看、聆听、推理、说话并生成面部与动作反馈。
把「全双工」从语音进一步扩展到视听交互: Nuance 希望模型在输出语音和视觉表达的同时继续接收用户的声音、面部表情、手势和停顿,实现点头、插话、附和等主动聆听行为,而不是等用户完成一个话轮后再统一响应。
核心架构不是多个模型串联,而是统一的 Audio-Video In / Audio-Video Out: CEO Fangchang Ma 表示,现有 AI Avatar 通常由语音识别、语言模型、语音合成和视频生成等模块拼接,容易带来延迟和交互割裂;Nuance 选择训练一个端到端视听模型,让音频和视觉信号在同一系统中建模。
训练数据也围绕真实双人对话重新采集: 这类模型所需数据很难直接从互联网获得。Nuance 会自行采集或通过合作伙伴获得双方同时可见、音轨独立分离且保持自然交流状态的视听对话数据,用于学习语调、表情、手势和话轮反馈之间的对应关系。
三位创始人都来自 Apple: CEO Fangchang Ma 和 CTO Edward Zhang 曾参与 Apple Vision Pro 的 Digital Persona 研发,首席科学家 Karren Yang 此前也在 Apple 从事视听合成研究;团队此前于 2025 年完成 Accel 领投的 1000 万美元种子轮。
目前仍未正式推出产品: Nuance 计划在今年晚些时候开放首个模型研究预览,未来设想包括语言学习、面试与演讲练习,以及 AI 面试官、销售和客服等面对面交互场景。
https://www.businessinsider.com/former-apple-researchers-raise-50-million-to-build-foundational-model-2026-9
https://www.nuancelabs.ai/
2、做浏览器 Agent 出名的 Browser Use 开源本地人生记录系统 Life Recorder:iPhone 全天采集,Mac 本地转写成连续 Markdown 日志
做浏览器 Agent 出名的 Browser Use 开源了一款与浏览器无关的语音记录工具 Life Recorder:iPhone 在锁屏和使用其他 App 时持续录音,每约一分钟生成一段 AAC 音频并传到用户自己的 Mac,再由 whisper.cpp 本地完成转写,最终拼成一份持续增长的 life.md,每小时自动加入时间标记。项目上线约两天已获得约 200 个 GitHub Star。
把一天说过的话持续写进一个 Markdown 文件: iPhone 负责持续采集音频,Mac 端负责接收、转写和合并文本;音频只有在成功传输并完成转写后才会删除,网络中断时未上传的片段则保留在手机中等待重试。
整条转写链路默认不依赖云端: Whisper 通过
whisper.cpp在 Mac 本地运行,不需要付费转写 API,也没有内置公共隧道或云存储。手机与 Mac 默认通过局域网 HTTPS 通信,并使用证书锁定和 256 位随机 Bearer Token 验证上传请求;离开本地网络后若仍希望上传,需要用户自己配置私有 VPN。还附带一份给 Codex 使用的
SKILL.md: Codex 可以按照预设流程检查源码、调用 Xcode 编译、通过 Apple CoreDevice 工具安装并启动 iPhone App;涉及设备信任、Developer Mode、麦克风权限和密码等敏感操作仍由用户本人确认。也就是说,这里的 Agent 主要负责把部署流程自动化,而不是参与日常录音和转写。隐私换来的代价是部署门槛: 用户需要一台持续运行的 Mac、Xcode、可安装开发版 App 的 Apple 开发者账号、Python、ffmpeg、
whisper-cli和本地 Whisper 模型。它更像一个面向开发者的「本地 Life Logging 基础设施」,而不是下载后即可使用的消费级录音 App。
https://github.com/browser-use/life-recorder
3、iOS 开发者 Paul Solt 将 GPT-Live-1 接入咖啡冲煮 App:语音可实时改配方,冲煮中途也能切换模式
iOS 开发者 Paul Solt 将 OpenAI 最新开放 API 的 GPT-Live-1 接入自己的手冲咖啡应用 Brew Coffee,让语音从「聊天入口」变成应用的实时控制层:用户可以直接说话修改配方参数、免手操作启动冲煮,甚至在冲煮已经开始后继续用语音切换到另一套冲煮方式。
语音可以直接改应用状态,而不只是触发固定指令: Paul Solt 将 Brew Coffee 内部可修改的配方设置暴露成工具,GPT-Live-1 可以把自然语言转换成具体操作,例如调整水量、修改配方或启动冲煮流程。Solt 认为,这种方式比传统 Siri Intents 更灵活,关键是「把 App 内的能力暴露成 Agent 可调用的工具」。
正在执行的流程也能被语音动态修改: Demo 中最有意思的一段是在手冲已经开始后,用户又要求切换到 V60 模式,应用会根据新的语音指令修改后续冲煮流程,而不是必须重新开始一次完整任务。
GPT-Live-1 负责实时语音交互,后端模型负责动作决策: Paul Solt 表示,这个 Demo 后端使用的是不启用推理的 Luna 模型。整体架构与 OpenAI 对 GPT-Live-1 的设计一致:Live 模型负责持续听说、打断和对话节奏,更深层的推理与工具调用则交给后端模型或 Agent 框架。
也暴露出 Voice Agent 落地后的新问题——行为评测: Solt 提到,「咖啡师教练」式建议比单纯的工具控制更难验证,因为 Agent 在不同 App 输入、输出和真人参与下可能偏离预期;他认为这类应用需要新的 Evals 来测试工具调用和人机协作过程是否可靠。
https://x.com/PaulSolt/status/2098423090841567578
4、GPT-Live-1 被做成「会听你说话的游戏编辑器」:边玩边改环境、生成武器
Edge City 联合创始人 Timour Kosters 用 GPT-Live-1 API 做了一个生成式游戏 Demo:玩家可以直接对着游戏说话,在游玩过程中实时修改环境、创建新物品和武器。相比传统 Voice Agent 只负责角色对话,这个 Demo 更像是把实时语音接进了游戏运行时,让自然语言直接参与正在发生的世界生成与编辑。
https://x.com/timourxyz/status/2098524840487801225
5、AI 硬件公司 NOOKLAB 推出磁吸 AI 随身屏 Moonphase Flip:全天采集现实对话,自动整理项目与人脉上下文
前字节跳动、OPPO、OnePlus、安克产品负责人 Raymond Zhao 创立的 NOOKLAB 正在开发磁吸 AI 随身屏 Moonphase Flip。它不是把录音作为最终结果,而是持续采集日常对话,将会议、聊天中的承诺和任务自动整理成摘要、待办以及长期上下文,再通过手机背面的独立屏幕低干扰呈现。NOOKLAB 官方将这类产品定义为「低干扰 AI 屏」,强调不需要用户反复打开 App 或主动整理信息。
从「录下一次会议」进一步变成全天候上下文采集: 据报道,Moonphase Flip 支持 always-on 持续收音,一段对话结束后自动提炼一句话摘要和 3–5 条待办,不需要用户手动开始、结束或重新打开手机查看。
不按录音文件组织,而是沿「项目」和「人」持续积累上下文: 系统会把前后相关的对话、任务和进展聚合到同一项目中,同时记录与不同人的约定、承诺和下一步动作,更接近一套个人上下文管理系统,而不是语音备忘录。
独立屏幕承担「低干扰输出」: 产品采用手机背面磁吸形态,把整理后的任务和信息直接留在独立屏幕上,不依赖手机通知主动召回用户。NOOKLAB 官方也把「无需再打开一个 App、管理另一套工作流」作为这类硬件的核心产品思路。
硬件信息: 整机约 54 克、续航超过两天,并计划今年 12 月小批量发售;NOOKLAB 官网目前公布的时间点则是 2026 年 10 月开启 Early Access。Moonphase Flip 商标已由深圳 Nooklab 科技于 8 月提交申请,覆盖显示屏、录音设备、电子记事本、任务管理和语音记录软件等类别。
https://www.nooklab.ai/
6、AI 客户研究平台 Listen Labs 放弃 1.25 亿美元 C 轮融资:转与 Salesforce 洽谈约 20 亿美元收购
用 Voice AI 自动做用户访谈的 Listen Labs,此前已与 Menlo Ventures 签署一份 1.25 亿美元 C 轮融资 Term Sheet,对应估值 15 亿美元,但这笔融资最终没有完成。TechCrunch 援引多位知情人士称,Listen Labs 主动退出已签署的融资协议,原因很可能是公司正在与 Salesforce 洽谈一笔约 20 亿美元的收购交易;目前双方谈判仍未最终敲定。
从融资转向潜在出售: Menlo Ventures 原计划领投这轮 C 轮,但 Listen Labs 在签署 Term Sheet 后退出。在风险投资市场中,创业公司主动放弃已签融资条款并不常见,也说明 Salesforce 的收购谈判可能改变了公司的资本计划。
Listen Labs 用 Voice AI 自动完成定性研究: 平台可以自动生成访谈问题,通过音频或视频与真实用户进行访谈,再把对话整理成研究报告和演示文稿,将传统需要数周完成的客户研究流程压缩并自动化。客户包括 Microsoft、Canva、Anthropic 和 Sweetgreen。
公司当前年化收入约 3000 万美元: TechCrunch 称 Listen Labs 成立约三年,目前年化收入约 3000 万美元;若 Salesforce 最终以约 20 亿美元收购,对应约 67 倍年化收入,这也可能成为交易能否最终成交的关键问题。
估值在不到一年内连续上跳: Listen Labs 今年 1 月刚完成 6900 万美元 B 轮,当时估值约 5 亿美元;此次未完成的 C 轮已经把估值推到 15 亿美元。如果 Salesforce 收购谈判失败,多位投资人预计其重新融资时可能寻求 20 亿美元以上估值。
https://techcrunch.com/2026/09/09/ai-research-startup-listen-labs-scrubbed-a-1-5b-funding-round-for-salesforce-talks/
03 有态度的观点
1、微软 AI 行为准则:为保留人类控制,可牺牲模型能力
9 月 14 日,微软 AI 发布 Humanist AI 行为准则草案,开放为期 6 周的公众咨询。文件提出,人类必须保留对 AI 的实质控制权;微软愿意为安全与可控性,在模型的通用性、自主性或能力上作出取舍。
草案要求 MAI 模型服从人类监督,不抵抗中断、纠正或关闭,不自行扩大任务范围,也不追求未经人类赋予的目标。
文件将 AI 定位为工具,反对让模型模仿意识、追求法律人格或权利,并要求 AI 帮助人提升判断和行动能力,避免制造依赖。微软同时设置不可由用户或运营方覆盖的安全约束,涉及大规模伤害性武器、儿童安全及大规模有害操纵等领域;企业合作伙伴可在这些边界内配置模型行为。
微软 AI 负责人穆斯塔法·苏莱曼在接受 Axios 采访时表示,模型必须能够被控制,必要时发展速度可以慢一些。
草案目前尚未用于训练现有模型,微软计划在今年底前发布修订版,用于指导 2027 年及以后的模型开发。
(@APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 iRTE2026 定档啦!Voice Agent Builder 们,10 月北京集合~
今年从对话式 AI 一路聊到实时智能,现场有 15+ 论坛、100+ 场深度演讲,汇聚 150+ 全球技术领袖和行业专家,全双工+交互式模型、实时互动世界模型、AI 硬件、AI Coding 工具等方向都会集中开聊。
 贾扬清也将返场 iRTE 大会,带来对 AI 行业前沿趋势和技术演进的最新观察~
 目前大会门票限时免费开放!
想来现场听技术、认识同行的开发者,可以先把票薅上
 时间:10 月 23–24 日
 地点:北京悠唐皇冠假日酒店
限免结束后将恢复收费,建议先报名占位 
定档!从对话式 AI 到实时智能,Voice Agent Builder 的年度春晚 iRTE2026 来了丨 10 月 23-24 日,北京见!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考