Tavus 发布全双工视频交互模型 Griffin:持续读懂表情动作,VideoFDB 生成与感知双榜第一 丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、实时 AI 视频交互公司 Tavus 发布全双工视频交互模型 Griffin:边听边说并持续理解表情与动作,VideoFDB 生成与感知两项排名第一
Tavus 发布 Griffin,并将其定义为首个「Human Interaction Model(HIM)」。Griffin 将音视频感知、对话决策、语音生成和视频生成放进同一个实时系统,在自己说话时仍持续接收用户的声音和画面,因此可以根据插话、停顿、视线、表情和手势动态调整说话时机、语气与非语言动作。当前开放的是 Griffin-Lite 研究预览版,仅向部分早期测试者提供。
从轮次式视频智能体转向持续全双工交互: Griffin 的对话模型以亚秒级间隔持续判断「说 / 等待 / 让出话轮」,并在输出过程中继续监听用户,可以处理中途打断、backchannel 和思考停顿;视觉输入也参与判断,让模型结合目光、面部表情和用户展示的环境信息做出响应。
音频与视频生成随对话状态同步变化: 系统由持续对话建模和流式音视频生成两部分组成,对话模型同时决定「说什么」和「怎么表达」,再分别驱动流式语音与视频生成,因此表情、手势、情绪和语音表达可以随着对话上下文实时变化。
在 NVIDIA VideoFDB 的生成与感知两条赛道均排名第一: Griffin-Lite 在生成赛道得分 3.83,接近人类参考的 3.92;感知赛道得分 3.73,高于测试中的其他 14 个模型。Tavus 另外进行了一项 54 人的一分钟视频通话测试,其中 48% 的参与者认为对面是真人;这一「通过视频图灵测试」的说法来自 Tavus 对该实验结果的定义。
https://www.tavus.io/griffin
https://x.com/tavus/status/2105704169009246248
2、Meta 与企业级 AI 智能体公司 Sierra 联合推出开放标准 Personal Agent Protocol:支持个人智能体跨网站、API 与企业智能体执行任务
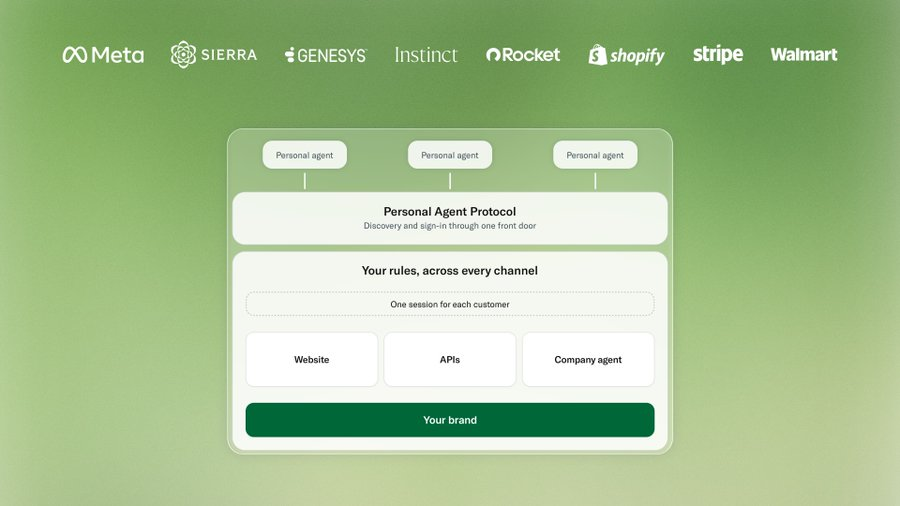
10 月 6 日,Meta 与 Sierra 联合 Genesys、Shopify、Stripe、Walmart 等企业宣布开发开放标准 Personal Agent Protocol(个人智能体协议),旨在统一个人智能体代表用户与企业交互时的身份认证、权限管理和任务执行方式。个人智能体可通过统一会话访问企业网站、API 或企业自有智能体,减少依赖网页点击、表单填写等操作。
基于 OAuth 建立跨渠道会话:个人智能体可先以访客身份查询商品库存、退货政策等信息,需要访问用户账户时再完成身份认证。登录前后的操作可保留在同一会话中,用户能够授权只读或写入权限。
支持三种企业交互方式:个人智能体可直接操作企业网站、通过 MCP 或 OpenAPI 接入企业 API,也可与企业自有智能体交互,完成保修申请等需要对话协作的任务。企业自主决定开放哪些能力及操作范围。
计划于 10 月发布 v0.1 规范:协议目前处于联合开发阶段,团队计划在本月晚些时候公布首版规范,并提供参考实现。后续拟扩展细粒度权限、主动事件通知及支付能力,支持航班延误通知、订单状态更新等场景。
https://sierra.ai/blog/introducing-personal-agent-protocol
3、OpenAI 发布语音与 Decisions API 集成指南:智能体可边对话边执行操作,支持语音控制浏览器和应用
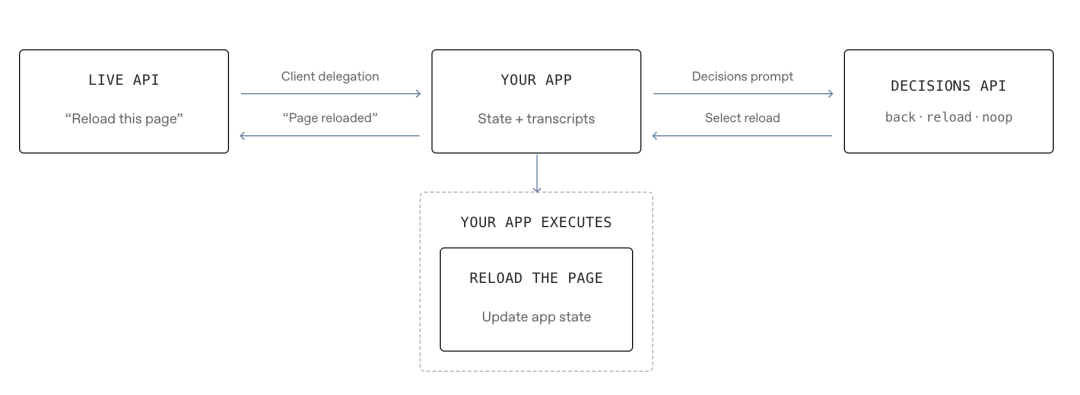
OpenAI 发布新开发指南《Connect voice to Decisions》,介绍如何结合 GPT-Live 语音能力、Decisions API 和客户端委托机制,构建能够一边进行语音对话、一边执行任务的智能体。开发者可以让智能体根据用户的语音指令操作浏览器、控制应用界面,或将复杂请求交给推理模型处理。
语音对话与任务执行并行:GPT-Live 通过客户端委托机制,将操作请求交给应用处理,同时继续监听和进行语音交互。任务完成后,应用将执行结果返回语音会话。
Decisions API 根据上下文选择操作:开发者提供对话记录、应用当前状态及可执行操作列表,Decisions API 从预设选项中选择对应动作。例如用户说「刷新页面」,API 可选择
reload,由应用实际执行并反馈结果。简单操作与复杂推理分流:对于切换幻灯片、控制媒体播放等指令,可直接选择预设动作;对于比较方案、分析问题等复杂请求,可转交推理模型处理。文档还提供语音控制游戏、机器人动作及应用界面的实现示例。
https://developers.openai.com/api/docs/guides/decisions-voice
4、Google DeepMind 发布设备端多模态嵌入模型 EmbeddingGemma 2:740M 参数统一文本、代码、图像、音频和视频检索
Google DeepMind 发布 EmbeddingGemma 2,这是 EmbeddingGemma 系列首个原生多模态开放嵌入模型。相比上一代主要处理文本,新模型把文本、代码、图像、视频和音频映射到同一个 768 维向量空间,让跨模态搜索、RAG、分类和路由可以直接在手机、笔记本等设备端运行。
不同模态可以直接互相检索: 开发者可以用文字搜索图片或视频,也可以用一段语音去寻找视频中的对应片段;模型还支持在同一次输入中混合文本、图片、视频和音频,并生成一个统一的嵌入向量,不再需要分别串联图像描述、ASR 和文本嵌入模型。
模型按所需模态模块化加载: 文本和代码部分为 270M 参数,加入视觉编码器后为 440M,加入音频后为 570M,完整多模态版本为 740M。不同组合最终仍投影到同一向量空间,因此可以根据设备和任务只加载需要的编码器。Google 表示,完整多模态版本在 Pixel 11 Pro 上运行时约占 567MB 活跃内存。
上下文扩展至 8K,并直接处理较长音视频: EmbeddingGemma 2 最多支持 8,192 token;在纯音频输入情况下约可处理 327 秒(5.5 分钟) 音频,视频默认以每秒 1 帧采样。相比上一代,代码相关任务表现也提升约 14%。
模型已按 Apache 2.0 许可开放,可通过 Hugging Face、Kaggle 和 Google AI Edge 使用。
https://x.com/GoogleDeepMind/status/2107502286758895878
5、多模态数据与评测公司 Mundo AI 测试语音 Benchmark 输入:6 家 TTS 合成语音与真人录音在模型表示中仍可明显区分
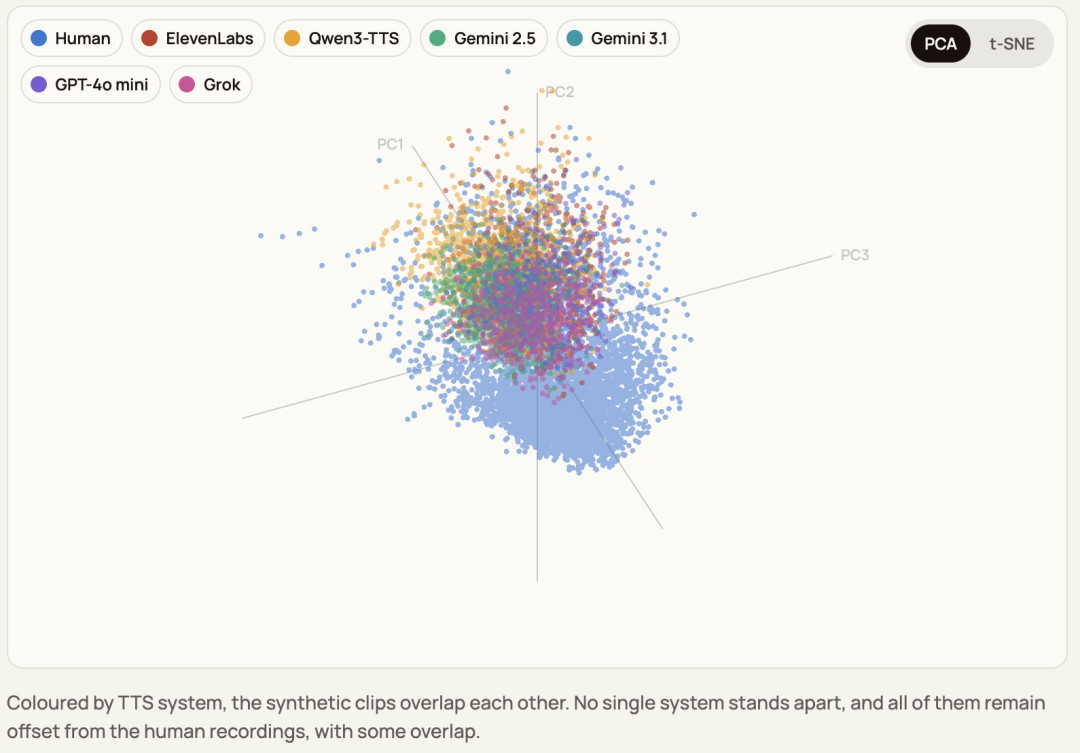
Mundo AI 分析了语音智能体与 Speech-to-Speech Benchmark 中常见的「用 TTS 合成语音代替真人录音」做法,并用相同文本分别生成真人与 6 家商业 TTS 的语音进行对比。在其测试数据中,Gemma 4 E2B 和 Qwen3-TTS 的音频表示几乎可以直接区分真人与合成语音,加入现有 Benchmark 常用的噪声与信道退化后,这一差异仍然存在。
模型实际接收到的真人与合成语音分布不同: 数据包含 902 段真人录音和 780 段合成语音,合成部分来自 ElevenLabs、Gemini 2.5 Pro Preview TTS、Gemini 3.1 Flash TTS Preview、GPT-4o mini TTS、Grok TTS 和 Qwen3-TTS。使用 MFCC、Gemma 4 E2B embedding 和 Qwen3-TTS 音频表示进行二分类时,AUC 分别达到 0.83、0.99 和 0.97。
简单「加噪」没有让合成语音变成真人语音分布: Mundo 分别测试了 τ-voice、EVA-Bench 和 DeepEval + ESC-50 的噪声处理。加入噪声后真人与合成语音的分布会更接近,但 Gemma 表示下的分类 AUC 仍达到 0.99 以上;研究认为,麦克风、房间、说话人频谱和电话信道等真实录音条件仍是现有合成语音较难覆盖的变量。
输入差异也会传导到模型输出,但结果存在明显数据依赖: 在 Gemma 4 E2B 的转写实验中,「输入是真人还是合成语音」一度是预测加噪后转写变化的第二重要因素;但移除一组频谱特征异常的真人说话人后,这一因素降至第 9 位。研究因此没有把差异简单归因于「真人 vs TTS」,而是指出 Benchmark 需要覆盖更多真实说话人、录音设备、频谱分布和信道条件。
https://mundoai.world/research/benchmarks-dont-hear-humans/
02 有亮点的产品
1、实时 AI 基础设施公司 Inworld 收购语音智能体平台 Ultravox:整合语音理解、轮次控制与 Realtime TTS-2
Inworld 收购实时语音智能体平台 Ultravox,并将其并入自身 Speech-to-Speech 路线。Ultravox 团队成员将继续开发原平台;双方此前已合作超过一年,Ultravox 主要提供语音理解、推理、任务执行以及实时对话中的轮次控制和打断处理,Inworld 则提供 STT/TTS 模型、模型服务和实时推理基础设施。
从单点 TTS 合作扩展到完整 Speech-to-Speech 技术栈: 收购后,Inworld 将 Ultravox 的实时对话能力与自己的 Realtime STT-1、Realtime TTS-2 和推理基础设施整合,覆盖从理解用户说什么、判断如何响应,到生成对应语音表达的完整链路。
Ultravox 已率先升级内置 Inworld 语音: 平台中所有内置 Inworld voice 已切换至 Realtime TTS-2,原有 voice ID 保持不变,不需要修改代码,也没有额外费用;新模型还支持通过自然语言控制语速、语气和情绪表达。
Ultravox 平台继续独立运行: 现有客户无需迁移,使用其他语音供应商的配置也暂不受影响。Inworld 表示后续会继续推进 Speech-to-Speech 能力,并在未来几周公布更多更新。
https://inworld.ai/blog/inworld-acquires-ultravox
https://www.linkedin.com/posts/zachkoch_big-personal-update-inworld-ai-acquired-activity-7511793003288801280-8QjJ
2、端侧 AI 模型公司 Cactus Compute 发布 16.9MB 语音识别模型 Whistle:CPU 本地运行,首 token 延迟 11.1ms
Cactus Compute 发布开源语音识别模型 Whistle,面向手机、可穿戴设备、机器人、汽车和微控制器等端侧设备。模型文件仅 16.9MB,直接在 CPU 上运行,并与其端侧工具调用模型 Needle 共用同一套 C++ 推理引擎,可以把语音转写和后续工具调用放进同一个本地执行链路。
模型大小约为 Whisper base 的 1/9: Whistle 为 16.9MB,Whisper base 为 145.3MB;在 Apple M4 Pro CPU 的 10 秒音频测试中,Whistle 首 token 延迟为 11.1ms,Whisper base 为 73.2ms,解码速度分别为 1319 token/s 和 266 token/s。
支持 7 种语言和本地实时转写: 当前支持英语、德语、法语、西班牙语、意大利语、荷兰语和波兰语,并提供词级时间戳、语言检测和语音嵌入向量;单次最多处理 30 秒音频,也提供流式转写接口。
语音输入可以直接接到 Needle 的工具调用: Whistle 与 Needle 使用相同的
.cact模型格式和运行时,同一个二进制可以先完成语音转写,再直接根据转写结果生成工具调用 JSON,开发者无需单独拼接 ASR 和本地 Agent 推理服务。
https://cactuscompute.com/blog/whistle
3、端侧语音技术公司 DaVoice 起诉 Perplexity:指控合作期间获取唤醒词技术机密后自行开发同类系统
DaVoice 运营方 SyteMLLabs 9 月 24 日在美国加州北区联邦法院起诉 Perplexity,指控后者在双方合作开发语音唤醒技术期间接触其商业机密,随后自行开发了同类能力。案件以《商业秘密保护法》为依据提起,目前这些内容均为 DaVoice 的诉讼主张,法院尚未就侵权事实作出认定。
争议集中在 AI 助手的「唤醒词」层: DaVoice 提供设备端 wake word detection,让设备持续监听类似「Hey Siri」的特定短语,并在命中后激活语音助手。其产品还覆盖 VAD、说话人识别、STT 和 TTS。
DaVoice 称合作中涉及多类底层技术资料: 据诉状及 Reuters 报道,双方此前合作的技术涉及 DaVoice 的专有源码、推理逻辑、网络架构、训练方法、训练数据和相关 know-how;DaVoice 指控 Perplexity 在此后使用这些机密开发自己的唤醒词系统。公开诉状经过大量删减,因此目前无法从公开材料确认双方系统具体存在怎样的代码或模型重合。
Perplexity 否认指控: 公司表示诉讼「毫无依据」,并称双方协议明确保留了 Perplexity 自行开发相似或竞争产品的权利。
(@Bloomberg Law)
03 有态度的观点
1、华为徐直军:昇腾在中国可统计市场的份额已超过英伟达
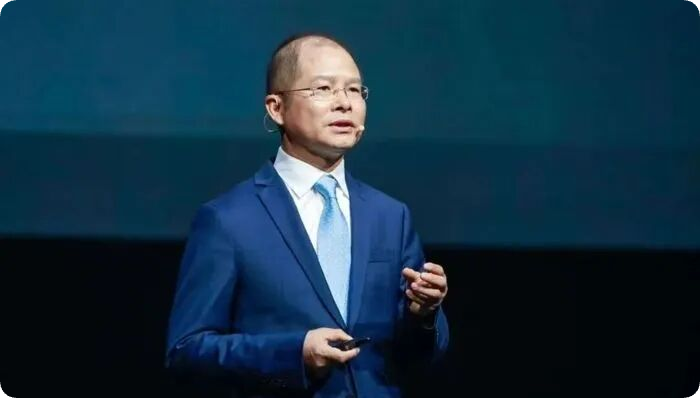
在近日公布的华为全联接大会媒体交流纪要中,轮值董事长徐直军表示,中国市场的英伟达份额很难统计,但按华为能够统计到的数据看,昇腾的市场份额应该已经超过英伟达。
徐直军称,当前昇腾供给仍不足以满足中国市场需求,华为没有全面拓展海外市场的计划,国内客户将获得优先供应;海外业务主要面向少数确有需求、难以取得算力或需要另一种选择的客户。基于 950DT 的超节点仍处于测试阶段,预计今年年底或明年初开始规模供货。
他预计,从明年起会有大量模型训练建立在这一系统上。谈到芯片供应瓶颈,徐直军认为,光模块、存储等环节都没有为 AI 需求的快速增长做好准备,全球供需平衡可能到 2029 年才能实现,中国可能更晚。华为单芯片仍受国内工艺限制,多芯片互联和系统架构则是其重点投入的路线。
华为 10 月 5 日公布的另一场媒体圆桌中,余承东表示,鸿蒙 6、鸿蒙 7 的设备总数已超过 9000 万台,预计年底超过 1 亿台;华为已有将鸿蒙推向海外的初步计划,将分步骤推进。
余承东称,自 2019 年以来,华为持续重构供应链,并在 2023 年恢复手机芯片的国内制造。按照他的说法,华为在芯片和操作系统层面已基本摆脱对美国技术的依赖,国产先进制程的产能仍然紧张。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
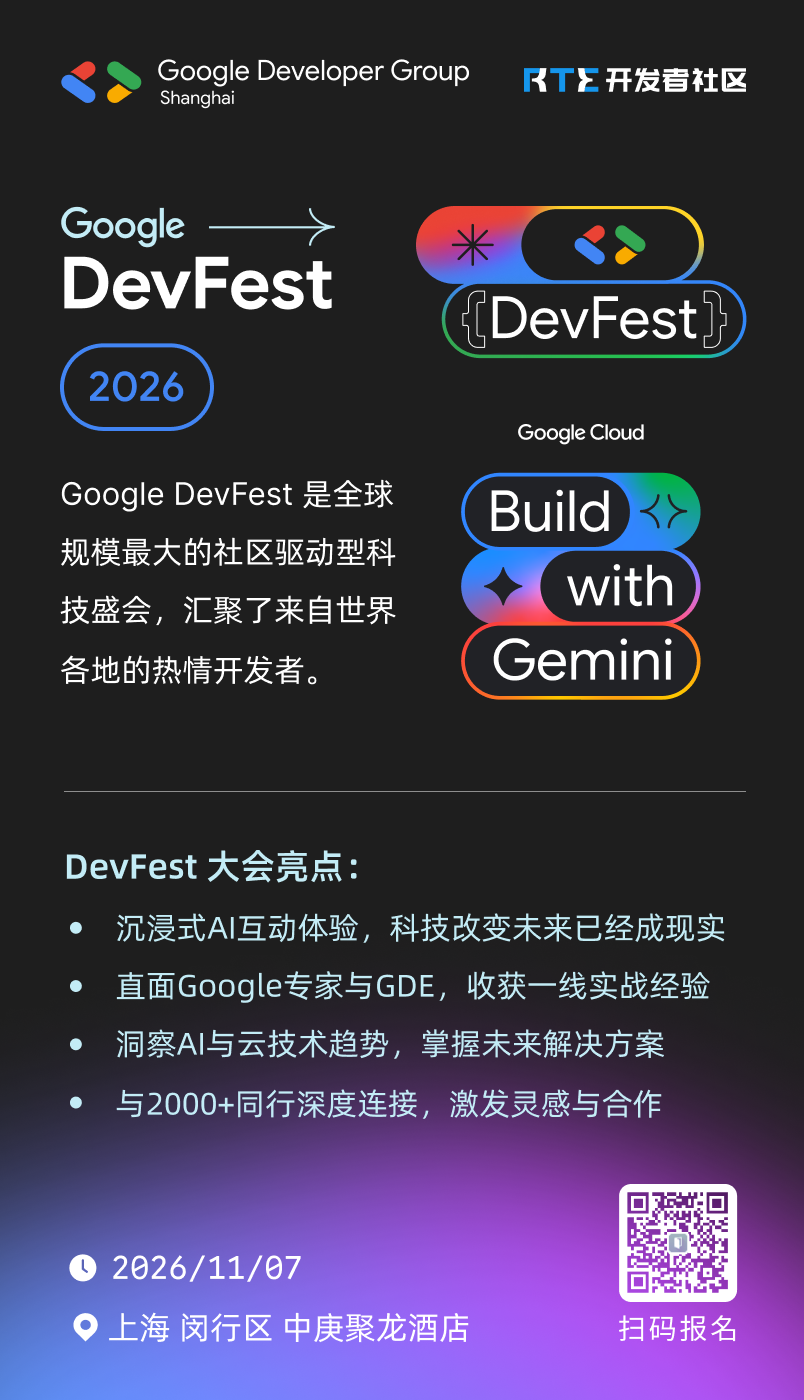
1、社区活动推荐|  Google DevFest 2026 上海站 来啦!
由 GDG Shanghai 主办,RTE 开发者社区共同支持的 Google DevFest 2026,将于 11 月 7 日在上海 举办!
今年以 Build with Gemini 为主题,现场不仅有 Google 专家与 GDE 带来 AI、Gemini 和 Google Cloud 的技术实践分享,还有沉浸式 AI 互动体验,以及与 2000+ 开发者 面对面交流的机会。
如果你正在关注 AI 应用开发、Gemini、云技术,或者想认识更多开发者朋友,欢迎来现场一起交流!
 时间:2026 年 11 月 7 日
 地点:上海闵行区中庚聚龙酒店
 扫描下方海报二维码报名参与~
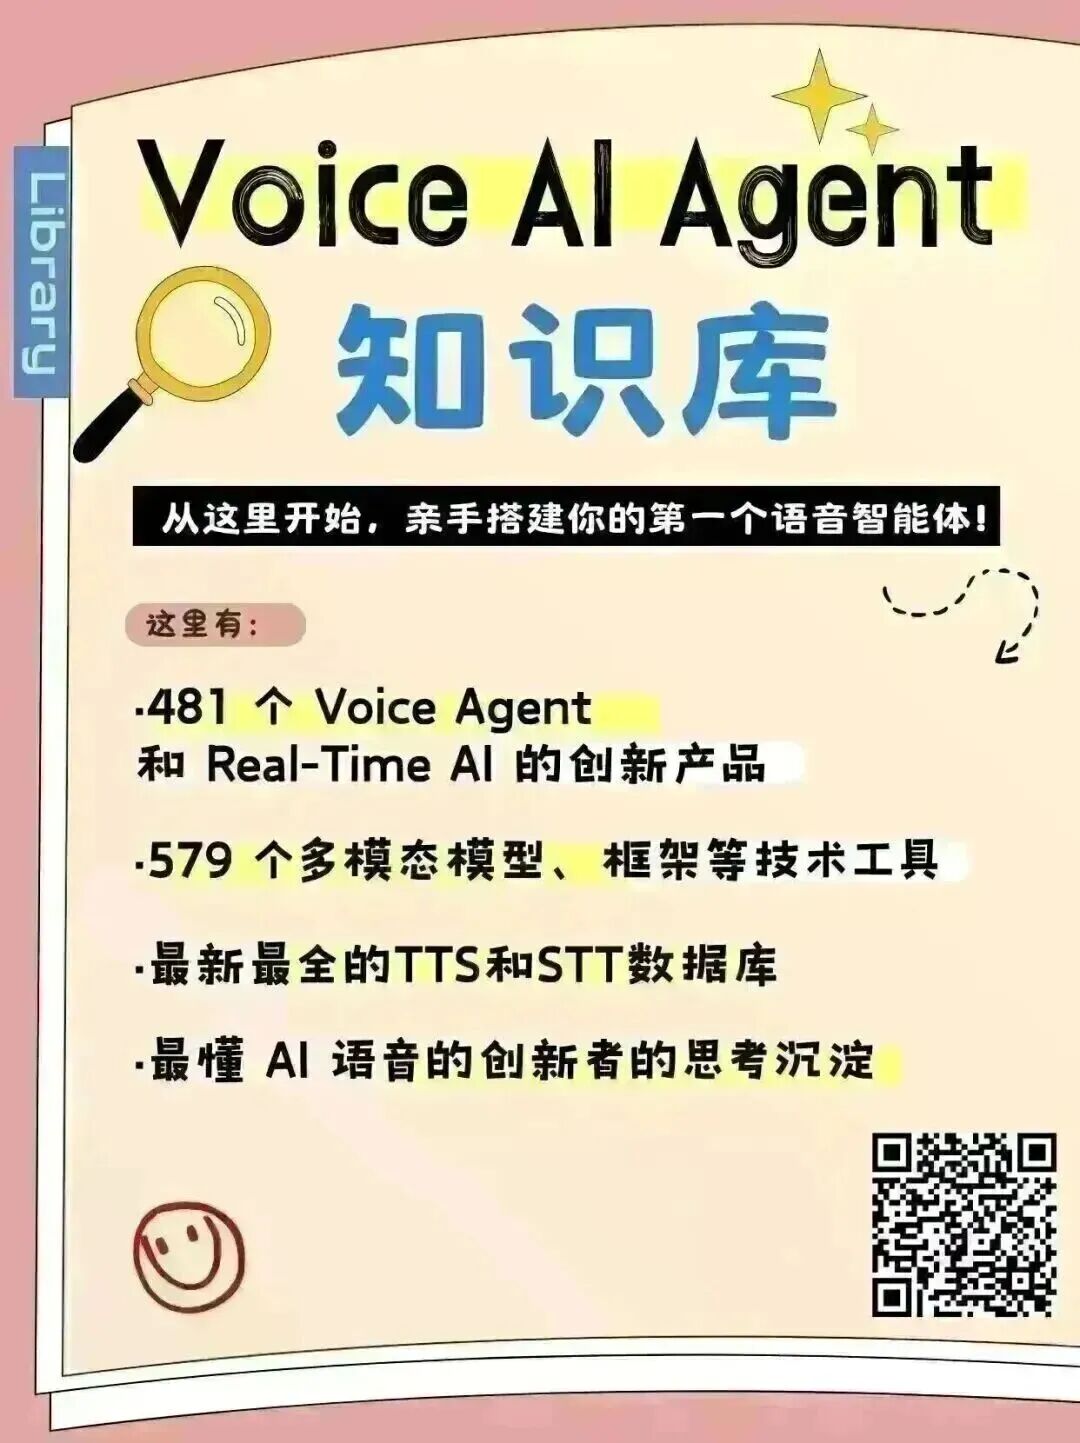
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考