农业 Voice AI 公司 Tellia 融资 500 万美元,农民打电话完成巡田记录丨日报
本期编辑:@三水、@鲍勃
01 有话题的技术
1、CMU、台大、NVIDIA 提出 ASR 自纠错方法 Hybrid Search:用隐状态找出易错人名,只在必要位置调用基座 LLM 修正
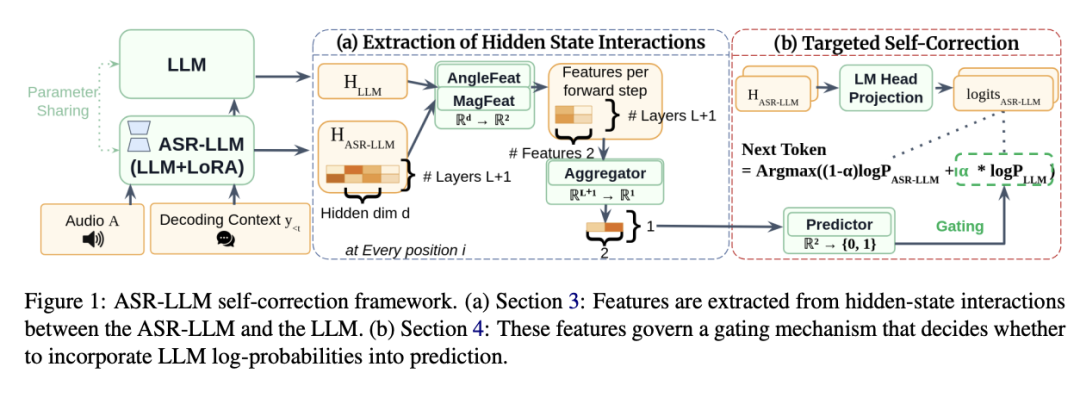
卡内基梅隆大学、台湾大学与 NVIDIA 提出 Hybrid Search,让大音频语言模型在转写过程中自行判断哪些词需要语义纠错。与把整段识别结果交给 LLM 重写不同,它比较语音适配模型与原始基座 LLM 的隐状态变化,定位人名、机构名等更依赖上下文的词元,只在这些位置引入语言模型知识,从而尽量避免把原本听对的内容「改错」。
先判断「哪里需要纠错」,再决定是否调用语言知识: 系统同时观察 ASR 模型和基座 LLM 在同一文本位置的隐状态,通过方向相似度和幅度变化判断该词对语义上下文的依赖程度。像人名、机构名这类仅靠声学容易出错的词,更可能被选中进入纠错。
不是让 LLM 重写整段转写: Hybrid Search 平时继续使用语音模型正常解码,只有检测到高语义依赖词时才临时展开束搜索,并混合基座 LLM 的概率;其他位置仍以音频证据为主。相比全局重打分或晚融合,这种局部纠错可以减少语言模型根据上下文「自作主张」改写真实说法。
不需要再训练一个纠错模型: 论文主要针对使用 LoRA 进行语音适配、同时保留原始基座 LLM 的架构,直接复用适配前模型已有的语言知识完成推理时纠错,不增加新的纠错网络。其限制也在这里:闭源模型如果拿不到隐状态,或适配后没有保留基座模型,就无法直接套用这套方法。
重点改善命名实体,而不是单纯追求更低平均 WER: 在 Phi-4-Multimodal 为主的 8 个语音数据集实验中,两遍纠错设置将平均命名实体错误率从 18.29% 降至 17.69%,同时总体词错误率基本保持不变;单遍模式只在约一成位置展开更昂贵的搜索,论文分析其计算量约为贪心解码的 1.4 倍。
http://arxiv.org/abs/2609.02940v1
https://huggingface.co/spaces/Splend1dchan/Listen-To-The-Latent
2、马里兰大学推出全双工语音 Agent 评测 DSB-IFEval:测试角色 Prompt 能否真正改变接话、打断与让话时机
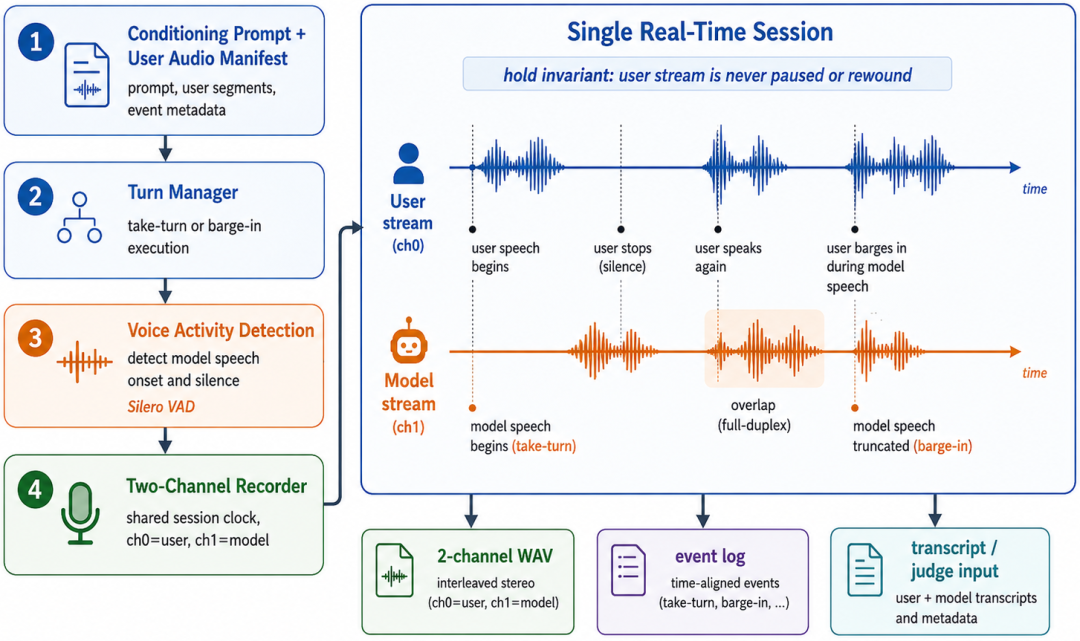
马里兰大学帕克分校提出 DuplexSpeechBench-IFEval(DSB-IFEval),专门评估全双工 Voice Agent 能否从角色设定中隐式推断对话行为。例如写下「你是一位耐心的辅导员」,模型不仅要回答得像辅导员,还应该理解这个角色意味着更愿意倾听、减少主动打断,并在合适时机接话。
把「说得像不像」与「接话对不对」分开评测: 基准分别使用 IAS 衡量 Agent 是否在正确时间执行倾听、附和、打断、接话、让出话轮等动作,再用 PAS 判断回答内容和表达是否符合角色。这样可以区分「人设说对了,但互动节奏完全没变」的情况。
同一段用户语音,只改变系统 Prompt: 1,038 个测试样例覆盖 8 类助手角色和不同对话情境,分别比较无指令、明确写出行为规则、只给 Persona、Persona + 明确规则,以及指令冲突等设置,从而直接测出模型能否从「角色」自行推出应该怎样管理话轮。
「知道自己是谁」不代表「知道什么时候说话」: 在 6 个实时语音系统中,F-Actor 和 PersonaPlex 从明确行为规则切换成仅 Persona 后,话轮行为遵循度分别下降 9.7% 和 4.5%;GPT-Realtime、MiniCPM-o 和 Fun-Audio-Chat 虽然生成内容能保持角色一致,但接话、打断等行为并没有明显随 Persona 改变。
安全场景下的指令冲突仍是难点: 评测还会故意让即时指令与角色要求发生冲突。论文发现,模型即使能在普通冲突中遵循指令,在涉及安全要求时仍不稳定,说明「理解 Persona」「控制对话时机」和「解决指令优先级」实际上是三种不同能力。
评测代码已按 MIT 协议开放: 仓库提供六个论文模型的参考适配器以及 IAS/PAS 评分流程,也支持开发者接入自己的全双工模型;项目页还开放模型响应录音,可直接听不同 Persona 下 Agent 的接话行为。基准音频本身采用 CC-BY-NC-4.0。
https://dsb-ifeval.github.io
3、上海交大、AgenticSys 提出 Voice Agent 上下文中间件 llmovoice:把语速、丢包和长期记忆纳入同一服务端决策
上海交通大学与 AgenticSys 提出 llmovoice,一套位于流式音频和 LLM 推理之间的语音上下文管理中间件。不同于把历史不断追加成一条聊天记录,它会显式记录用户说了什么、怎么说,以及当前网络和声学环境如何,再据此决定给模型哪些历史、回复速度以及何时接话。论文已被 ACM SOSP 2026 接收。
把「沉默」和「丢包」放进同一套轮次判断: 网络丢包可能让解码后的音频短暂变成低能量片段,普通 VAD 容易误以为用户已经说完。llmovoice 会把网络状态显式加入上下文,并动态调整等待和 VAD 参数;论文实验中,丢包条件下的误打断率从 46.0% 降至 0.9%。
上下文不只有文字,还包括语速和环境状态: 系统把语义内容、副语言信息和环境信息分别建模,例如根据用户近期语速调整 AI 的回复节奏。论文报告语速匹配误差降低 52.4%。
长对话不再每轮重塞完整历史: llmovoice 将已完成交互整理成「语音页(VoicePage)」,再按任务和主题组成「语音线程(VoiceThread)」;每轮只在预算内检索相关历史,并选择原始音频、转写或摘要等不同精度的表示,而不是无限扩展上下文窗口。
同时控制「说什么、怎么说、什么时候说」: 服务端 Context Orchestrator 根据当前状态生成运行时指令,可调整回复内容、语速以及轮次控制。也就是说,网络状态、用户习惯和历史任务不再由三套独立规则分别处理,而是在一次上下文决策中协调。
长会话成本最高降至原来的约 1/24.9: 论文报告整体模型使用成本降低 79.2%;在长会话中,每轮成本最高降低 24.9 倍,同时保留最高 98.7% 的基线回答质量。
目前官网已开放 llmovoice 浏览器实时语音 Demo;我暂未核实到论文对应的独立公开代码仓库,因此不建议直接写「代码已开源」。
http://arxiv.org/abs/2609.04288v1
https://llmovoice.com
4、北大、通义千问应用团队等提出音视频生成方法 TCR:把剧本时间轴直接注入生成器,镜头切换误差从 1.11 秒降至 0.042 秒
北京大学、通义千问应用团队、香港科技大学、香港中文大学和上海交通大学提出 Temporal Context Routing(TCR),面向按剧本生成的音视频模型补上一层显式「时间控制」。现有模型即使能做到嘴形和声音同步,也可能把原定第 3 秒的切镜或台词拖到第 4 秒;TCR 将剧本中每个镜头、对白和事件的时间区间直接映射到音视频生成时间轴,让模型同时知道**「生成什么」与「什么时候生成」**。
时间信息不再只藏在 Prompt 文字里: TCR 会把剧本中的
time_range从文本编码过程中单独抽出,并映射回对应的镜头、对白和事件。语义内容继续决定「生成什么」,时间区间则通过另一条路径决定这些内容应该在哪一段时间发挥作用。通过注意力分数直接控制「什么时候发生」: TCR 将当前生成位置与剧本目标时间区间之间的距离转成一个路由分数,加到文本交叉注意力的 logits 上。越接近指定时间,对应剧本片段对生成结果的影响越强;远离该时间段后影响自然减弱。TCR 本身不引入额外可学习参数。
视频和音频读取同一只「时钟」: 同一套时间路由同时作用于视频与音频分支,因此镜头切换和对白开始时间都围绕同一剧本时间轴生成,而不是分别完成音画同步后再尝试对齐剧本。
镜头切换误差降到约一帧: 在基于 LTX-2.3 22B 的 200 条测试剧本上,加入 TCR 后镜头边界平均绝对误差从 1.11 秒降至 0.042 秒,约等于 24 FPS 视频的一帧;对白在目标时间 ±0.5 秒内开始的准确率从 28.3% 提升至 84.1%,同时论文报告视觉质量和音画同步能力没有明显下降。
训练、推理代码和 LoRA 权重均已公开: 官方仓库提供基于 LTX-2.3 22B 的训练与推理实现,Hugging Face 同步开放 TCR LoRA 和 200 条测试剧本,项目页提供多镜头、对白跨镜头以及指定音效时间点等生成案例。仓库采用 LTX-2 Community License,因此更准确的说法是「代码公开」,而不是泛称 MIT 等宽松开源许可。
https://dagroup-pku.github.io/Temporal-Context-Routing.github.io/
5、PulseVAD 开源 2.1K 参数端侧 VAD:INT8 权重仅 2.1 KB,可直接部署到 ESP32、STM32 等微控制器
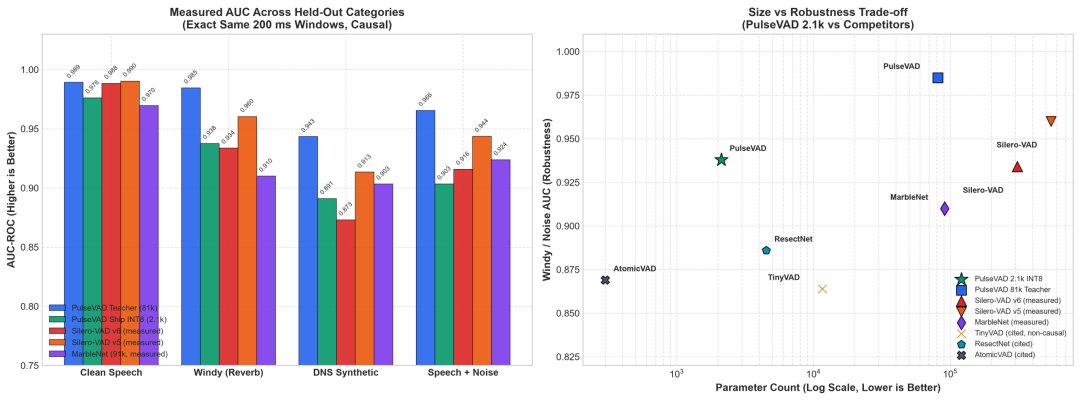
开源项目 PulseVAD 发布一款仅 2,118 个参数的超轻量语音活动检测模型,面向 Voice Agent、通话和嵌入式设备中的实时语音起止检测。模型采用严格因果设计,不读取未来音频;INT8 权重仅约 2.1 KB,完整 ONNX 文件约 26.8 KB,并提供可直接嵌入 ARM Cortex-M、ESP32、STM32 和 Arduino 固件的 C 头文件。
2.1K 参数也能做实时 VAD: PulseVAD 输入 16 kHz 单声道音频,以 200 ms 因果窗口运行深度可分离 1D CNN;官方在普通 CPU 上测得每个 200 ms 窗口推理约 0.73 ms,无需未来帧或额外 lookahead。
专门为资源受限硬件准备部署格式: 除 ONNX 和 TorchScript 外,项目直接提供预量化的
pulsevad_weights.h,可集成到 ARM Cortex-M、ESP32、STM32 等设备,避免为了一个 VAD 引入完整深度学习运行时。通过「教师模型 → 剪枝 → 蒸馏」压到 2.1K 参数: 团队先训练 8.1 万参数教师模型,再使用结构化剪枝和知识蒸馏压缩,并通过偏置校准降低模型在纯噪声下误触发的问题;最终再做 INT8 后训练量化。
干净语音表现接近更大模型,但噪声场景仍有取舍: 项目自己的约 82 分钟公开音频测试中,PulseVAD 在干净语音上的 F1 为 99.3%,整体多场景平均 F1 为 90.1%;Silero VAD 对应为 96.9% 和 93.6%。也就是说,它的优势主要是模型体积和端侧成本,并不是全面取代 Silero,尤其在复杂噪声和音乐环境下后者仍更稳。
https://github.com/AydinAdnan/PulseVAD
02 有亮点的产品
1、OpenAI 将 1-800-ChatGPT 切换至 GPT-Live SIP API:官方电话服务开始使用同一套开发者接口
2、农业 Voice AI 公司 Tellia 获 500 万美元 Pre-Seed:田间团队直接用电话、语音记录作业,上线两月 80% 团队每日使用
农业 Voice AI 初创公司 Tellia 完成 500 万美元 Pre-Seed 融资,由 Revent 领投,Grey Silo Ventures、Jeriko 和 Fund F 参投。Tellia 希望把原本需要在办公室填写表格的农业数据采集搬到田间:农民、农艺师和现场团队可以直接打电话、发语音或 WhatsApp,AI 自动把自然语言整理成对应田块、作物、人员和作业的结构化记录。
语音不是只做转写,而是直接写入业务数据: Tellia 会从电话、语音消息、文本、WhatsApp、邮件等输入中提取病害观察、喷洒决策、巡田记录和人员安排,并关联到具体田块、作物和团队;用户也可以反过来用自然语言查询这些数据。
美国客户上线两个月后,80% 的田间团队每天都会使用: Tellia 称其已覆盖约 100 万英亩土地,并在美国部署于 Campos Brothers Farms、Duckhorn 等农业生产商,在欧洲也已进入法国葡萄与葡萄酒研究院、Val de Gascogne 和 KWS Saat 等机构。
下一步开始向农业软件提供 API: Tellia 正在构建位于田间与现有 AgTech 软件之间的 Agent 层,合作伙伴可直接把它嵌入自己的产品,让用户通过说话完成数据录入、结构化和后续建议,而不必重新开发一套语音系统。
融资将继续投入 Voice AI、Agent 能力和欧美扩张: 本轮资金将用于提升语音能力、建设 Agentic AI 产品,并扩大美国和欧洲团队。
https://tellia.com/resources/tellia-raises-5m-pre-seed/
3、苹果为 Apple Watch Series 12 加入「音频智能」:可回溯过去 15 秒对话,并自动总结日常交流
苹果发布 Apple Watch Series 12,首次加入一组面向周围声音与对话的「音频智能(Audio Intelligence)」能力。除了识别警笛、门铃和婴儿哭声等环境声音,新款手表还可以回溯刚刚发生的对话,并在用户主动开启后持续理解交流内容、生成摘要,让 Apple Watch 从主要感知身体状态进一步扩展到对外部声音环境的感知。
Live Rewind (对话回溯)可回看刚才 15 秒对话: 用户双击数码表冠后,手表会将此前 15 秒听到的对话转成文字,可继续询问 Siri 或保存到 Siri App,适合没听清或刚刚走神的场景。功能启动时会播放提示音并显示明显的麦克风提示,提醒周围的人正在使用该功能。
Siri Recap (对话总结)开始把日常对话直接整理成摘要: 用户开启后,会在交流结束后自动生成标题和关键要点;用户可以控制 Siri Recap 在什么时间、什么地点工作,而不是每次都手动开始一次录音。
环境声音识别直接放到手腕上: 环境声音识别使用设备端模型识别警笛、警报、门铃、婴儿哭声等重要声音,即使 iPhone 不在身边也能通过 Apple Watch 发出提醒,最初尤其面向聋人和听障用户。
原始音频不会生成可播放录音: S11 芯片新增 Secure Exclave,在与系统其他部分隔离的区域处理原始音频并立即删除;Live Rewind(对话回溯)和 Siri Recap(对话总结)则可在 Siri App 中通过端到端加密同步。
Live Rewind 和 Siri Recap 将在 2026 年晚些时候以 Beta 形式上线,首批仅支持英语,并要求搭配支持 Apple Intelligence 的 iPhone 16 或更新机型。
https://www.apple.com/newsroom/2026/09/introducing-apple-watch-series-12-with-the-all-new-health-sensing-system/
03 有态度的观点
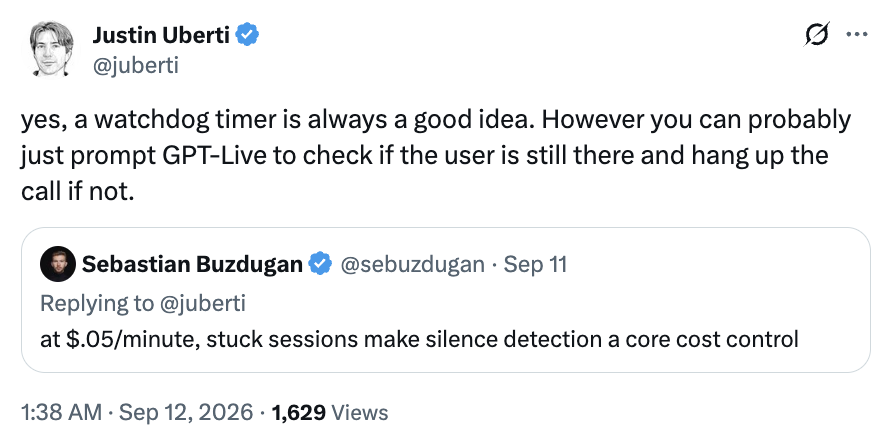
1、 Justin Uberti:GPT-Live 可以自己确认用户是否还在线,不必只靠静音超时
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 上海开发者活动推荐|S创上海 2026,9 月 22–23 日西岸艺术中心见
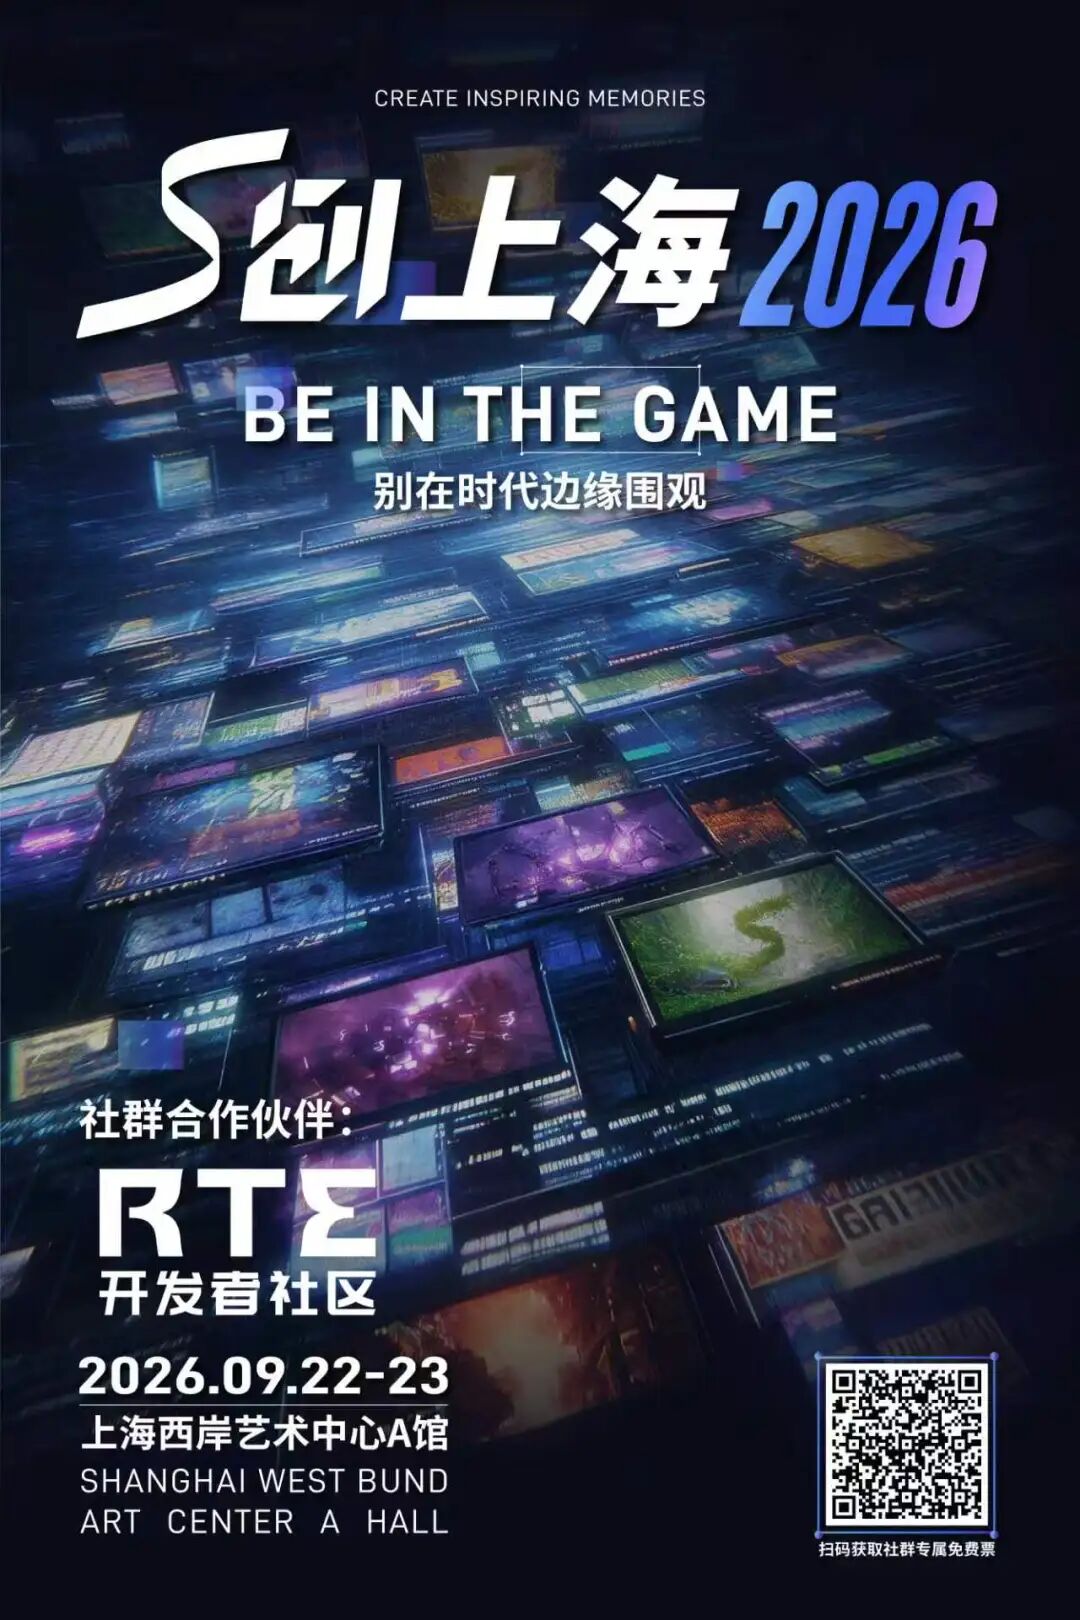
如果你最近关注 AI、先进制造、未来出行、消费科技或创业生态,可以留意下今年的 S创上海 2026。
大会将于 9 月 22–23 日在上海西岸艺术中心举办,预计吸引来自 60+ 国家、15000+ 参会者,现场会有创业者、投资人、大企业、媒体及生态组织者参与,覆盖 AI、文创消费科技、生命健康、绿色可持续科技、先进制造、未来出行 等多个方向。每年的旗舰活动S创上海也被众多海外科创圈的朋友称作中国最酷最国际化的科创活动。
 时间: 9 月 22–23 日
 地点: 上海西岸艺术中心
 十周年大会回顾视频:
 十周年大会全日程参考:就在明天!先收好这份S创上海2025全日程!
2、 iRTE2026 定档啦!Voice Agent Builder 们,10 月北京集合~
今年从对话式 AI 一路聊到实时智能,现场有 15+ 论坛、100+ 场深度演讲,汇聚 150+ 全球技术领袖和行业专家,全双工+交互式模型、实时互动世界模型、AI 硬件、AI Coding 工具等方向都会集中开聊。
 贾扬清也将返场 iRTE 大会,带来对 AI 行业前沿趋势和技术演进的最新观察~
 目前大会门票限时免费开放!
想来现场听技术、认识同行的开发者,可以先把票薅上
时间:10 月 23–24 日
地点:北京悠唐皇冠假日酒店
限免结束后将恢复收费,建议先报名占位 
定档!从对话式 AI 到实时智能,Voice Agent Builder 的年度春晚 iRTE2026 来了丨 10 月 23-24 日,北京见!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考