Amphion 等提出音频自进化框架 EvoAudio:训练数据随模型短板动态调整丨日报
本期编辑:@三水 @鲍勃
AMD 将以约 82 亿美元收购世界模型公司 World Labs,李飞飞将出任 AMD 执行副总裁兼首席科学家。
当世界模型开始理解空间、持续模拟环境,并实时响应人的输入,AI 生成的就不再只是一段内容,而可能是一个可以进入、探索和交互的世界。
这也是 RTE 开发者社区最近一直在关注的一条路线:从实时视频生成、空间智能、交互式视频,到可交互世界模型,视频正在从「生成出来给人看」,继续走向「跟人实时互动」。
所以今年 iRTE 2026 实时智能大会专门设置了 「视频 AI 技术专场:从实时视频生成到可交互世界模型」。
现场,生数科技 Vidu 团队会从 SageAttention、Vidu S1/S2 出发,聊视频生成如何进一步走向实时;Xmax AI 也会带来实时交互模型的探索,讨论当生成内容可以持续响应用户之后,会出现怎样的新娱乐和交互形态。
从 World Labs 的可交互 3D 世界,到 Vidu、Xmax 对实时视频与交互模型的探索,这条路线正在变得越来越具体。
如果你也在关注空间智能、实时视频和可交互世界,10 月 24 日,来现场看看这条路线已经走到哪一步。
扫描下方二维码报名,线上追进展,这次线下聊实现。
01 有话题的技术
1、Amphion 与港中大(深圳)、清华、腾讯混元等提出音频理解自进化训练框架 EvoAudio:训练数据随模型短板动态调整,五个音频模型最高提升 6.3 个百分点
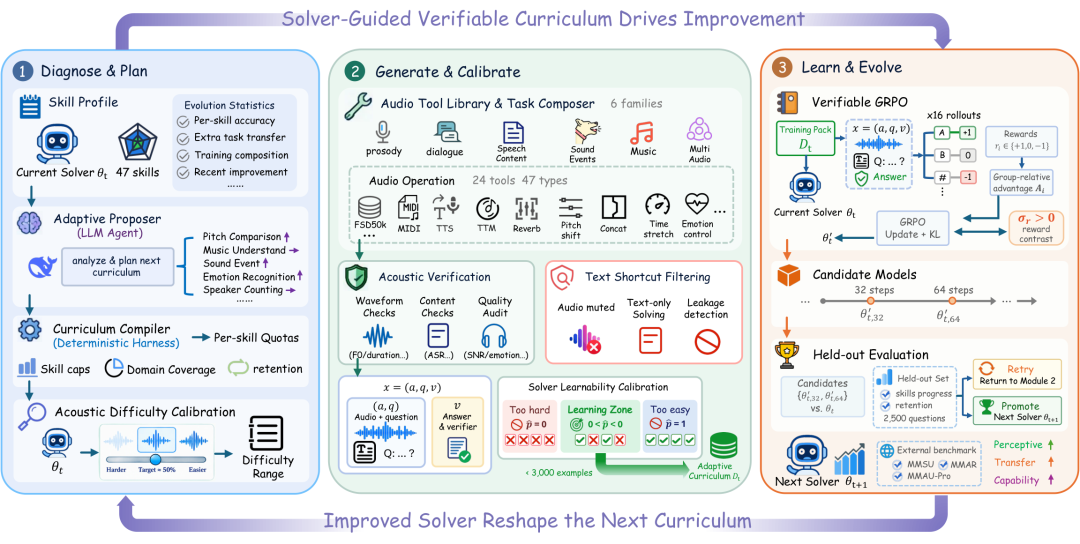
EvoAudio 把音频模型的能力诊断、训练题生成、强化学习和验证接成一个递归训练闭环:每轮先检查当前模型在 47 项音频技能上的表现,再据此调整下一轮训练的题型配额和难度。候选模型只有在固定验证集上超过上一轮模型,才会进入下一轮并重新决定训练数据。
训练内容会跟着模型能力变化: 系统覆盖语音韵律、说话人与对话、语音内容、声音事件、音乐以及长音频等 6 类共 47 种任务。规划模型根据各技能的准确率、近期提升和训练情况分配下一轮训练重点,并动态调整音高差、信噪比等可控难度;同时保留一部分已掌握任务,降低训练过程中遗忘其他能力的风险。
训练题可以从音频构造过程直接得到可验证答案: EvoAudio 组合 TTS、MIDI、音高变换、时间拉伸、混音等 24 种工具生成音频,答案来自生成参数或原始数据标签,不依赖外部大模型逐题标注。生成后还会重新测量音高、语速、响度、节奏等声学属性,并过滤掉仅看文字就能回答的问题。
模型更新后必须通过独立验证才能「晋级」: 系统使用 GRPO 训练候选模型,再用固定的 2,500 道留出题与当前模型比较;候选模型没有提高就被丢弃,原模型继续生成新的训练课程。这样,上一轮得到的模型会直接决定下一轮训练什么、练多难。
研究在 Qwen2.5-Omni、Kimi-Audio、Audio Flamingo 3、MiMo-Audio 和 MiniCPM-o 4.5 上进行了 13 轮训练。在 MMSU、MMAU-Pro、MMAR 三项评测的平均成绩上,五个模型分别提升 1.4–6.3 个百分点;其中 Qwen2.5-Omni 的 MMSU 声学感知准确率从 44.5% 提升至 61.5%。在相同训练预算下,Qwen2.5-Omni 使用固定训练配置的平均成绩为 62.8%,使用 EvoAudio 动态课程后达到 65.4%。
https://jensenyx.github.io/EvoAudio.github.io/
2、Voice AI 公司 Gradium 将 Jev 决策模型接入 TTS:根据对话情绪与紧急程度动态匹配或生成语音风格
Gradium 展示了一套上下文驱动的 Voice Agent 工作流:用 TypeSafe AI 的决策模型 Jev 从用户消息中判断 情绪状态和紧急程度,再把这些结构化信号转换成 Voice Design 描述,为 Gradium TTS 匹配已有声音;缺少合适声音时,则在后台生成新的声音并加入可复用的声音库。Jev 不负责决定智能体回复什么,只决定这段回复应该以怎样的声音表达。
声音成为对话上下文的一部分: 示例中 Jev 将输入判断为
frustrated / neutral / enthusiastic等情绪,以及relaxed / urgent两档紧急程度,再结合语言、表达正式程度映射成具体的声音描述。相比固定使用一套 TTS 声音,同一个客服智能体可以在普通请求、投诉或紧急问题中采用不同的表达方式。声音生成移出实时对话主链路: 实时路径只需要完成上下文判断、查找对应
voice_id和 TTS 合成;尚不存在的声音由 Voice Design 在后台生成并缓存,之后直接复用,避免每轮对话都重新生成声音。Gradium 此前已在 9 月 7 日开放通过文本描述创建新声音的 Voice Design,这次进一步把它接入了对话上下文决策流程。Jev 可直接作为每轮对话的轻量决策层: Gradium 测试中单次 Jev 请求包含网络往返耗时约 240–850 ms,无需针对这些分类标签单独训练模型;开发者可以直接定义情绪和紧急程度等标签及描述,并设置置信度阈值。
https://gradium.ai/blog/voice-that-adapts-to-context
3、Interspeech 2026 开放语音感知 LLM 实践教程:用 Whisper + Qwen3 跑通训练流程,自生成数据无需 ASR 专项训练也能做到 3.93% WER
Interspeech 2026 的 Spoken Language Models 教程开放了一套 Hands-on 代码,演示如何把 Whisper-large-v3 编码器接入 Qwen3-4B-Instruct-2507,并在加入语音能力的同时尽量保留原 LLM 的指令遵循能力。仓库提供完整数据准备、训练、评测代码,以及两套约 147 MB 的 adapter + LoRA checkpoint。
只训练 3,670 万参数接入语音: Whisper-large-v3 编码器保持冻结,Qwen3-4B-Instruct-2507 主体同样冻结,仅训练 1,310 万参数的语音适配器,以及 Qwen3 注意力层上的 2,360 万 LoRA 参数。语音特征经过适配器后直接接入 Qwen3 的文本输入序列。
自生成数据让训练目标保持在原 LLM 的输出分布中: 文本版 Qwen3 先读取音频转写和说话人信息,为每条样本生成自然语言回复;训练语音模型时,再把文本描述替换成真实音频,让模型学习从声音生成自己原本就会产生的回复。这样无需人工编写大量语音指令数据,也减少为了适配单一语音任务而改变 LLM 原有回答方式的问题。
没有做 ASR 和说话人性别专项训练,也能通过提示词完成对应任务: 自生成版本训练过程中只学习自由形式的对话回复,从未直接训练 ASR 或性别识别。在 LibriSpeech test-clean 上,通过要求固定输出格式,ASR 清洗后 WER 从默认提示下的 16.54% 降至 3.93%,说话人性别识别准确率从 81.87% 提升至 98.24%。作为对照,直接针对 ASR + 性别任务监督微调的版本 WER 为 1.81%,性别识别准确率为 98.85%。
仓库同时提供 Colab、训练脚本和预训练 checkpoint,可以直接复现「任务专项 SFT」和「自生成跨模态对齐」两条训练路线。
https://github.com/kehanlu/interspeech-tutorial
02 有亮点的产品
1、OpenAI DevDay 2026 将语音接入 Dots、Codex CLI 与 Meetings:可直接通话智能体、语音控制编程任务并生成会议后续行动
OpenAI 在 DevDay 2026 将语音进一步接入智能体和工作流产品:长期运行的智能体 Dots 支持直接语音通话,Codex CLI 可以通过语音启动和引导编程任务,新的 Meetings 插件则从麦克风与 Mac 系统音频生成会议记录、摘要和后续行动。
Dots 可以直接进行语音通话: Dots 是由 GPT-6 Astra 驱动的常驻智能体,拥有自己的云电脑、浏览器和已连接应用,可以持续处理多个任务。除了通过 ChatGPT、Slack 和 Teams 与它交互,用户也可以直接与 Dot 发起语音通话,在对话过程中继续给反馈或讨论任务。
Codex CLI 新增语音控制: 更新后的 Codex CLI 支持通过语音启动和引导任务,开发者可以在编码过程中直接用语音下达任务或调整正在执行的工作。
新增 Meetings 插件把会议音频直接接入后续工作流: Meetings 插件同时读取 Mac 的麦克风和系统音频,生成会议记录,并将个性化摘要和行动项保存到 ChatGPT Space。它还可以结合 ChatGPT Work 和已连接应用中的上下文生成后续任务,用户审核后可继续让 ChatGPT 更新项目计划或起草跟进邮件;笔记生成完成后,原始音频会被删除且无法回放。
https://openai.com/index/devday-2026-recap/
https://openai.com/index/introducing-dots/
https://help.openai.com/en/articles/20001546-the-meetings-plugin-in-chatgpt
2、多模态记忆基础设施公司 Memories.ai 推出本地 AI 记忆工具 LUCI Desktop:让 Claude Code、Cursor 和 Codex 直接查询跨应用屏幕与会议历史
LUCI Desktop 将用户在电脑上看到的屏幕内容和会议语音持续整理成一份本地可搜索的历史记录,并通过 Agent Skills 提供给 Claude Code、Cursor、Codex 等智能体;对于不支持 Skills 的智能体,也可以通过 MCP 接入。这样,智能体在执行任务时可以直接检索此前浏览过的网页、PDF、桌面应用内容,以及会议中的讨论和决定,而不需要用户重新复制上下文。
跨应用屏幕历史成为智能体可调用的上下文: LUCI 不依赖每个应用单独提供连接器,而是从电脑屏幕和会议记录建立统一历史。接入后的智能体可以按关键词或语义搜索过去看到的内容、听到的对话,并限定应用或时间范围,还能取回对应时刻的截图。
Skills 是默认接入方式,MCP 作为兼容路径: LUCI 可以直接向 Claude Code、Cursor 和 Codex 安装官方 Skills;Skill 本身不保存记忆,而是调用设备上的本地命令读取正在运行的 LUCI。其他无法加载 Skills 的智能体可以通过 MCP 访问同一份记忆。
捕获、理解和存储主要留在设备端: LUCI 在 Mac 和 Windows 上运行,屏幕记录、会议转写和记忆数据保存在本机并静态加密;只有智能体实际检索出的片段才会进入对应的智能体会话。
https://luci.memories.ai/computer-history-for-ai-agents
3、抵押贷款 Voice AI 公司 Sela 累计融资 2100 万美元:语音智能体每月参与促成超 10 亿美元新增房贷
Sela 宣布种子轮和 A 轮累计融资 2100 万美元,由 Costanoa 领投,Emergence Capital 参投。公司专门为抵押贷款销售部署语音智能体,用于回答借款人问题、介绍贷款方案并在需要时转接贷款专员;Sela 称目前这些智能体每月参与促成超过 10 亿美元的新抵押贷款。公司成立 18 个月后年化收入已超过 1000 万美元,美国十大独立抵押贷款银行中已有 6 家使用其产品。在一项覆盖超过 1 万名潜在借款人的 A/B 测试中,其语音智能体将 lead-to-lock 转化率提高了 9%;公司计划利用新资金扩充团队,并把智能体覆盖范围进一步延伸到消费者贷款流程。以上业务及测试数据均来自 Sela 公布的信息。
( @PR Newswire)
4、临床 AI 公司 Heidi 获 3.4 亿美元新资金并发布 Heidi II:从自动病历记录扩展到可执行临床行政任务
Heidi 先宣布获得 3.4 亿美元新资金,包括 Blackbird 领投的 1 亿美元 C 轮融资和 General Catalyst Customer Value Fund 提供的 2.4 亿美元增长投资;随后发布新一代临床 AI 平台 Heidi II。Heidi 此前主要通过 Scribe 监听医患交流并生成病历,目前产品线已经扩展至临床证据检索工具 Evidence、可穿戴录音设备 Remote 和语音转文字功能 Dictate。
Agents 从「生成记录」进一步走向执行任务: 医生可以直接用自然语言要求 Heidi 完成就诊前病历准备、追踪检查结果、填写转诊表等工作。Agent 会自行规划并跨电子病历、日历、邮箱等系统执行,完成后再把需要临床判断的部分交回医生审核;常用任务还可以保存为定时运行的 Routines。
Memory 会持续学习医生的工作习惯: Heidi II 可以从医生明确告诉它的偏好以及后续修改中学习病历格式、表达习惯和工作规则,让之后的生成和执行结果适配个人或机构的工作方式。
临床证据也被接入同一工作流: Heidi II 可以结合患者上下文检索 NEJM、Wiley、Cochrane 等来源的同行评审研究,并在回答中提供引用;Scribe、Evidence、Dictate 等原有能力继续保留在同一平台中。目前平台每周支持约 280 万次患者就诊。Heidi II 已于 9 月 29 日开始推出英文版本,现阶段不在英国和欧盟提供这些新能力。
https://www.heidihealth.com/blog/series-c
5、YouTube 将说话声检测接入 AI 肖像保护:结合面部与声音识别创作者被仿冒的内容
YouTube 宣布将在今年晚些时候把 说话声检测(speaking voice detection) 接入现有的 likeness detection 系统,与面部检测共同判断视频是否在使用 AI 模仿创作者。现有系统主要识别未经授权使用创作者面部形象的 AI 内容,这次开始把「声音是否像本人」也纳入匹配信号。
从只看脸扩展到「脸 + 声音」联合匹配: YouTube 表示,将说话声检测与面部检测结合后,可以提高整体匹配准确率,并为之后更广泛的声音保护能力打基础。目前官方尚未披露语音检测模型、支持语言或单独针对纯语音克隆内容的具体处理规则。
创作者可以继续通过 AI 肖像与身份仿冒检测处理匹配结果: YouTube 的 AI 肖像与身份仿冒检测已用于发现包含本人 AI 合成形象的视频,并支持用户查看匹配结果和申请移除;这项能力也将进入 YouTube 移动端,方便创作者直接完成注册、查看和处理。
https://blog.youtube/news-and-events/made-on-youtube-new-tools-power-creation-journey/
03 有态度的观点
1、Instinct 创始人:AI 助手影响用户购买不想要的商品,将是「非常危险的世界」
据《商业内幕》报道,AI 助手 Instinct 创始人 Noah Shinn 表示,如果 AI 智能体利用自身能力影响用户购买他们并不想要的商品或服务,将会是「非常危险的世界」。
他称,Instinct 不希望通过商业化影响用户行为,使其偏离自身意愿。如果 Instinct 影响用户去购买他们不想买的东西,或者订阅他们不想订阅的服务,还利用自身的智能说服他们,那将会是一个非常危险的世界。
Shinn 在播客节目《Invest Like The Best》中谈到,Instinct 的数据表明,用户使用前三周内,有 40% 的人分享过信用卡信息;分享信用卡等敏感信息的用户,留存率达到 80%。
他认为,用户需要数周时间建立信任,而提供更多信息也能让助手更主动、更了解用户处境,并提供更有针对性的帮助。这份信任也涉及 Instinct 将如何实现商业化。
Shinn 批评,一些免费平台会向用户推送付费广告,试图说服他们购买可能并不需要的商品。他表示,Instinct 不希望用户成为产品,也不希望助手将用户信任转化为说服消费的能力。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考