TypeSafe AI 实时决策模型Jev 语音智能体案例分享丨日报
本期编辑:@三水、@鲍勃
01 有话题的技术
1、TypeSafe AI 发布决策模型 Jev:不生成文本,直接返回概率和结构化判断
TypeSafe AI 发布首个 System One 模型 Jev,面向软件里的分类、评分、路由和决策任务。与先让 LLM 生成一段文本、再解析成结构化结果不同,Jev 直接接收上下文和类型化问题,返回选项、概率和置信度,结果可以直接被代码用于分支、排序和路由。
不做自由文本生成,直接输出结构化决策: Jev 提供 Choice、Score 和 Noul 三类原语,分别用于多选判断、按量表评分和真假判断;多个问题可以在一次调用中并行评估,而不是逐个生成答案。
复杂推理拆成多个原子判断,再由代码组合: 官方建议把一个需要多步权衡的问题拆成多个独立判断,再在代码中组合结果,例如分别判断市场规模、技术可行性和差异化,而不是让模型直接生成一段综合分析。
官方称速度快 20–200 倍、成本低 40–400 倍: TypeSafe 给出的价格为每百万输入 token 0.042 美元,输出不计费,并宣称在其决策型工作负载中相较前沿 LLM 可实现上述速度和成本差距;这些数字目前主要来自官方发布,尚缺乏第三方统一基准复现。
RLCD 用于训练「校准后的决策」: TypeSafe 将其训练方法称为 Reinforcement Learning for Calibrated Decisions,目标不是奖励更像人的回答,而是让模型输出的概率更接近实际正确率,从而让软件可以根据置信度决定是否自动执行。
https://docs.typesafe.ai/introduction
https://x.com/CompleteSkeptic/status/2099925682726002904
2、Gradium 开发者 使用 Jev 承担语音智能体实时决策:用户还没说完,就能基于部分语音提前触发动作
Gradium 团队测试了 TypeSafe AI 的决策模型 Jev,用它替代传统 LLM 承担语音智能体中的决策环节。演示中,系统不必等用户完整说完一句话,而是可以基于已经收到的部分语音持续判断下一步动作,并提前触发工具调用。相比「等一句话结束 → LLM 推理 → 再执行」的串行流程,这种方式更适合对延迟敏感的实时语音交互,也展示了 Jev 这类轻量决策模型在 Voice Agent 中作为实时决策层的用法。
https://x.com/BhosalePratim/status/2100986774742765991
3、开发者用 Jev 做出实时语音控制浏览器:约 300 ms 完成决策,话没说完就能执行
开发者 Moritz Kremb 开源了一个基于 Jev 的语音浏览器控制 Demo:浏览器持续获取用户的部分语音转写,每次把当前转写、页面状态和候选元素一起交给 Jev,约 250–350 ms 返回意图、目标元素、指令是否完整等概率判断,再由代码决定点击、返回、搜索或继续等待。因为 Jev 不需要生成完整文本回答,像「go back」这类已经足够明确的指令,甚至可以在用户整句话说完之前执行;作者实测单次决策成本约 0.0002 美元。
https://github.com/moritzkremb/jev-voice-browser
4、Qwen 发布实时同传模型 Qwen3.8-LiveTranslate:平均延迟降至 2.3 秒,新增实时说话人分离
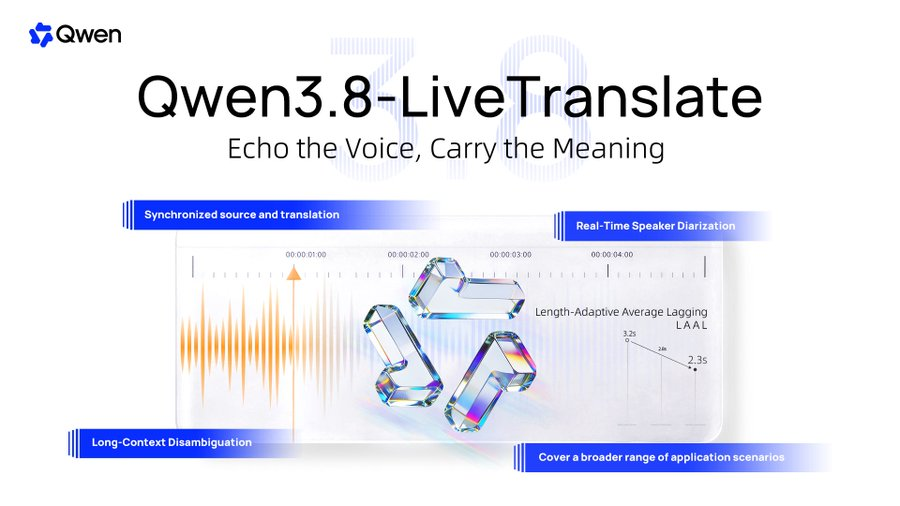
Qwen 发布新一代实时同声传译模型 Qwen3.8-LiveTranslate,通过音频与文本交错处理的架构,把平均翻译延迟(LAAL)从上一代的 2.8 秒降至 2.3 秒;同时新增实时说话人分离、原文与译文同步输出和长上下文消歧,让多人长对话中的不同说话人、专有名词和前后文能够持续对应。
音频与文本交错处理,延迟从 2.8 秒降至 2.3 秒: 模型将已经听到的音频和已经生成的译文放进同一条时间序列中处理,并复用此前的上下文,在降低等待时间的同时提升翻译的忠实度、流畅度和简洁性。
新增实时说话人分离: 多人轮流说话时,模型可以区分不同说话人并标记每句话是谁说的,生成翻译语音时也会尽量保持各自的音色特征。
原文和译文可以同步输出: API 会在返回译文的同时返回说话人标识和源语言文本,不需要再额外调用一套 ASR 接口,可直接用于双语字幕等实时场景。
利用长对话历史消除翻译歧义: 模型会结合此前的文本和对话上下文判断人名、专有名词和指代关系,使长对话中的术语翻译保持一致。当前支持 60 种语言的语音输入与文本输出,其中 29 种语言支持翻译语音输出。
https://qwen.ai/blog?id=qwen3.8-livetranslate
https://qwencloud.com/models/qwen3.8-livetranslate-flash-realtime
5、蚂蚁集团与清华发布 Realtime-Venus:全双工语音持续交互,后台任务异步执行可再回到同一对话
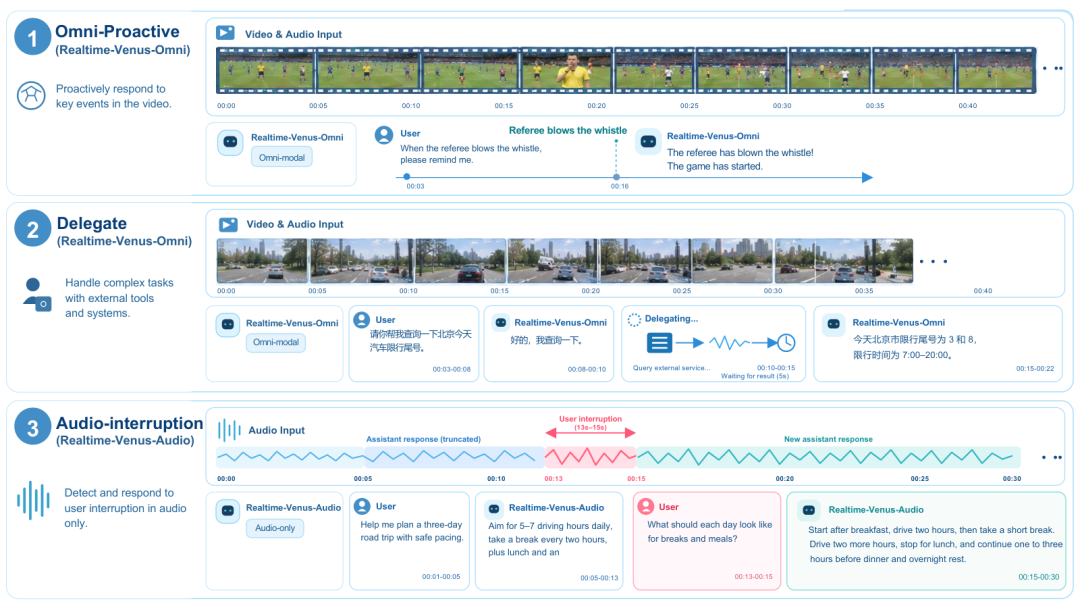
蚂蚁集团 Venus Team 与清华大学发布 Realtime-Venus,一套同时支持全双工语音、音视频理解和异步任务委派的实时交互系统。它把「前台实时感知与说话」和「后台执行复杂任务」拆成两条并行链路:模型可以继续听用户说话、处理打断和简短回应,同时把搜索、调用技能或复杂推理交给后台执行,任务完成后再把结果送回当前对话,而不需要暂停实时交流。
前台对话和后台任务并行: 一条链路负责实时感知、语音生成和全双工交互,另一条链路保存请求发生时的上下文并异步执行任务,完成后再准备回复。
同时提供音频版和音视频版 9B 模型: Realtime-Venus-Audio 处理语音、环境声音和打断;Realtime-Venus-Omni 进一步加入视觉事件理解、主动响应和长视频记忆。
专门训练「什么时候该继续说,什么时候该回应」: 后训练数据覆盖停顿、简短附和、打断和后台任务,让模型不仅学会回答内容,也学习实时对话中的响应时机。
论文单独评估任务委派判断: 在团队自建 Delegate Benchmark 上,Omni 的路由准确率为 75.93%,Audio 为 68.89%;这个指标衡量的是模型是否正确判断「何时该委派」,不代表后台任务本身的最终成功率。
https://realtime-venus.github.io/
6、UT Austin 与 Meta 基于 Moshi 提出 RetroThinker:让流式语音模型边听边推理,并能回头修正早期判断
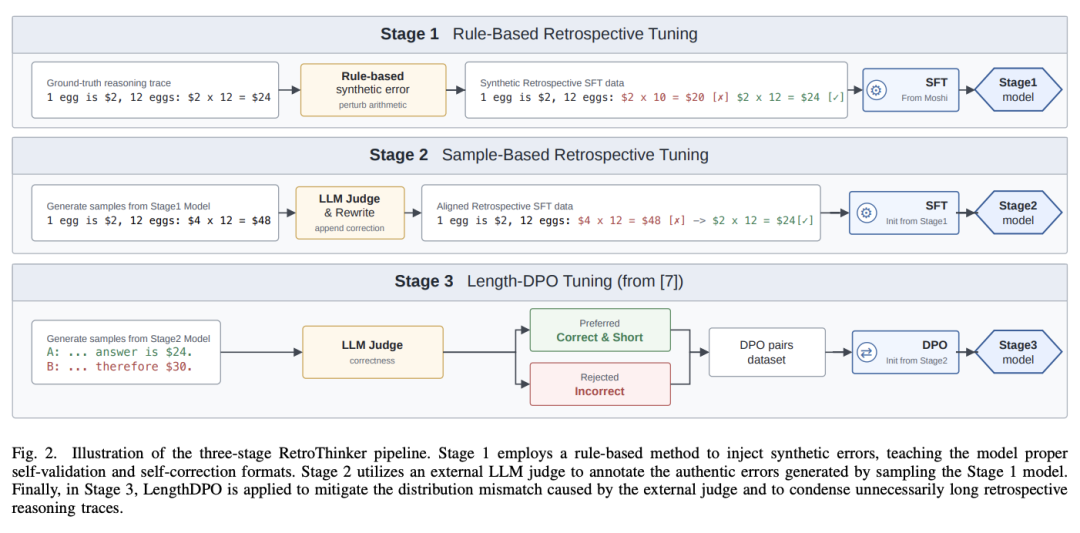
UT Austin 与 Meta 提出 RetroThinker,一套针对流式语音模型的后训练方法,并以 Moshi 作为底座。它的核心不是等用户整句话说完再开始推理,而是让模型在语音持续输入时同步展开推理;当后续语音暴露出前面的判断有误时,模型还能回看已有推理并补充修正,而不是只能沿着错误路径继续生成。
边听边推理,而不是等整段语音结束: RetroThinker 让 Moshi 在用户持续说话的同时就开始生成内部推理过程,把原本串行的「听完 → 推理 → 回答」改成更适合实时语音交互的并行流程。
新增「回顾修正」能力: 后续语音提供新信息后,模型会重新检查此前的推理;如果发现早期判断不再成立,可以插入新的修正步骤,再从修正后的状态继续推理。
专门控制推理带来的额外延迟: 论文结合监督微调和长度偏好优化,避免模型为了反复回顾而无限拉长推理过程,在推理能力和实时响应之间做取舍。
论文中在相近延迟下提升推理准确率: 在基于 Moshi 的 GSM8K 语音推理实验中,RetroThinker 相比不具备回顾修正机制的流式基线,报告了 11 个百分点的绝对准确率提升;这一结果属于论文实验,不代表通用语音场景下的线上表现。
https://arxiv.org/abs/2609.11864
02 有亮点的产品
1、桌面 AI 设备 Violoop 众筹 20 小时破 100 万美元:看懂屏幕、操作电脑,并持续记住个人工作流
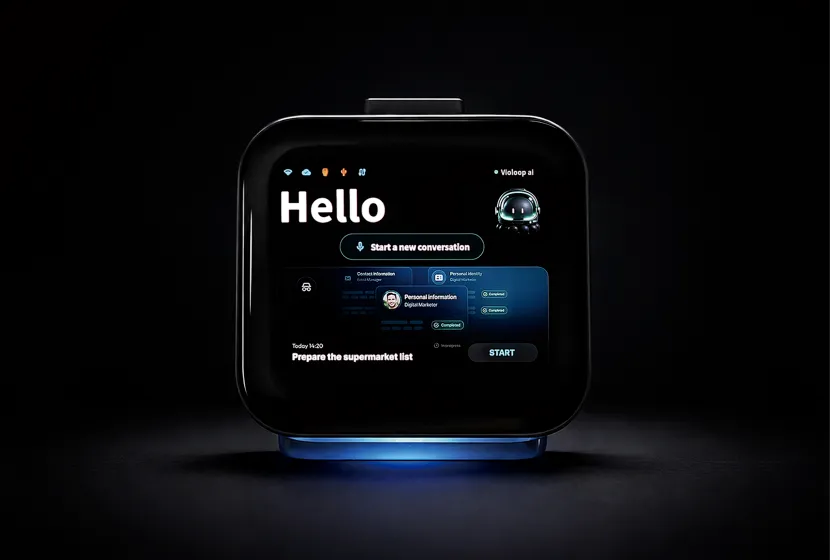
Violoop 是一款接入现有电脑使用的桌面 AI 设备,通过读取屏幕内容和模拟 USB 键鼠输入,让 Agent 直接进入用户已经在使用的软件和工作流,而不需要等待每个应用开放 API。
直接操作现有电脑: Violoop 能读取当前屏幕内容,并通过键鼠输入完成跨应用操作,让 AI 进入传统软件、企业系统和专业工具。
把一次性任务变成长期工作流: 系统会在授权下积累长期记忆、工作流记忆和 Skills,尝试记住用户如何处理相似任务,而不是每次都从一段新 Prompt 开始。
端云协同处理感知与推理: 26 TOPS 端侧算力负责屏幕理解、记忆处理和部分本地推理,更复杂的任务再路由到云端大模型;原始屏幕画面和长期记忆主要在本地处理。
关键操作需要用户确认: 对发送、删除、提交、支付等高风险操作,Violoop 通过独立安全芯片和实体按键或配对手机进行最终授权,避免 Agent 的主动性自动扩大权限。
众筹 20 小时突破 100 万美元: Kickstarter 上线约 20 小时后,筹款超过 100 万美元,单台首发价为 399 美元;此前团队还完成了亿级天使轮及 Pre-A 轮融资。
https://violoop.ai/
2、DeepMind Genie 原班团队创立世界模型公司 Emulate:成立一个月即洽谈最高 7 亿美元融资,投后估值约 37 亿美元
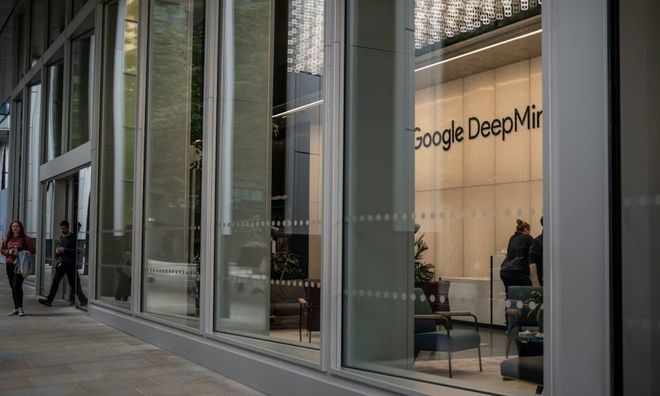
Emulate 是一家由前 Google DeepMind 研究员 Jack Parker-Holder、Matthew McGill 和 Philip Ball 创立的世界模型公司,三人都参与过 Genie 系列研发,其中 Parker-Holder 曾负责 Genie 2。公司成立仅约一个月,目前仍处于隐身阶段,尚未公开产品、收入或网站,但已在洽谈最高 7 亿美元种子轮融资,若按当前条款完成,投后估值约 37 亿美元,Index Ventures 和 Lightspeed Venture Partners 预计共同领投。
核心团队直接来自 Genie 世界模型项目: 三位创始人都参与过 DeepMind 的 Genie 系列,其中 Genie 2、Genie 3 主要探索从图像或文本生成可交互环境,Emulate 延续的也是世界模型方向。
还没有公开产品,融资押注主要在团队和技术路线: 截至目前,Emulate 没有公开网站、收入或已发布产品,融资仍处于谈判阶段,条款尚未最终确定。
方向聚焦可模拟物理世界的世界模型: 公开报道显示,Emulate 计划开发能够生成交互式 3D 环境、预测物理世界变化的模型,这类能力可进一步用于机器人训练和仿真。
(@硬迹 ing)
3、OpenAI 为 GPT-Live API 上线新版 Playground:可配置委派模型,并直接查看后台任务执行过程
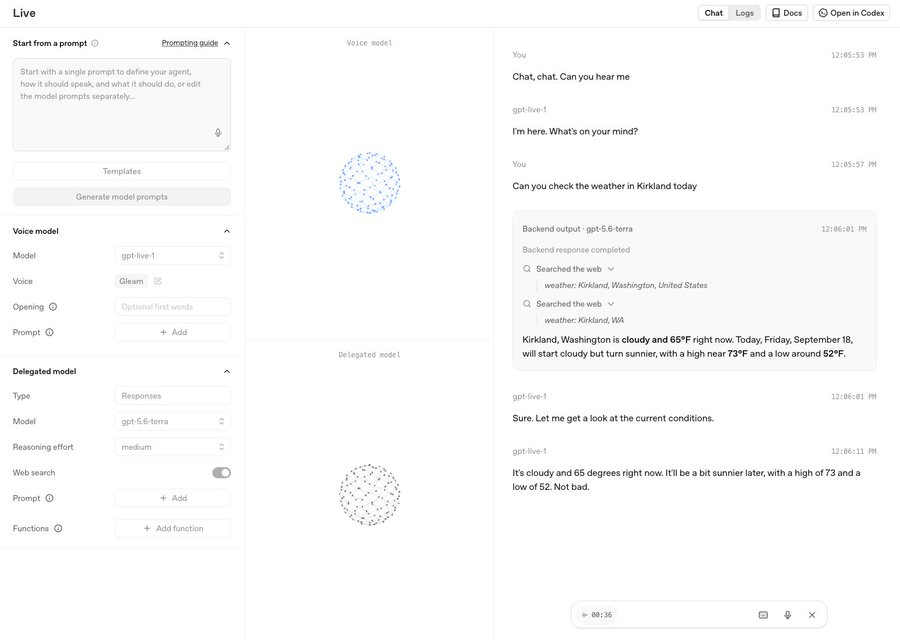
OpenAI 为 GPT-Live API 更新了 Playground。除了继续配置语音和提示词,开发者现在还可以直接选择后端委派模型,并在界面里查看 GPT-Live 什么时候把任务交给后端、后端如何调用工具以及结果怎样返回实时对话。GPT-Live 本身继续负责低延迟语音交互,需要搜索、推理或工具调用时再委派给后端模型,因此这个 Playground 更适合直接调试「前台持续对话 + 后台执行任务」的完整链路。
https://platform.openai.com/audio/live/edit
03 有态度的观点
1、 Spirit AI 高阳:机器人「大脑」最快在 2027 年迎来 GPT-3 时刻
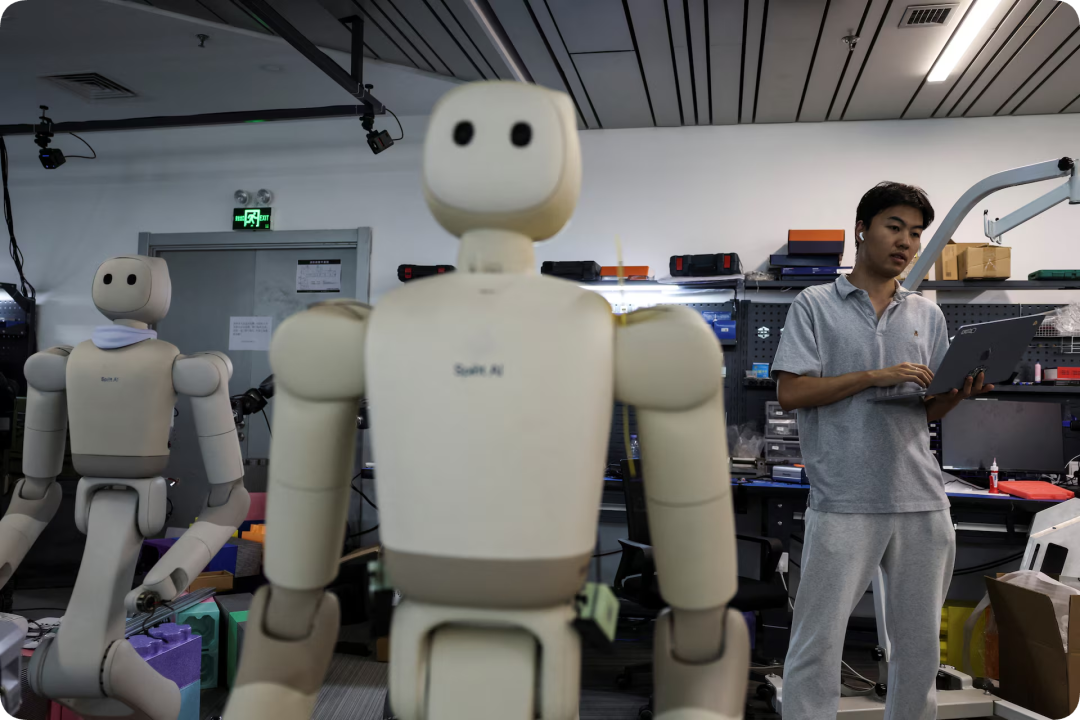
Spirit AI 创始人高阳在接受路透社采访时判断,机器人「大脑」最快会在 2027 年出现类似 GPT-3 的能力跃迁。
她预计,到 2027 年年中,用户或许可以用自然语言让机器人连续完成一系列动作,而不必逐步编程。高阳把不同场景的落地时间分开来看:工业应用约需 1 至 2 年,酒店、餐厅等简单商业服务约需 2 年,机器人进入普通家庭至少还要约 8 年。
她认为,训练数据仍是主要瓶颈。互联网文本可以大规模复制,机器人却需要在真实环境中积累动作和反馈数据;不同硬件、场景和任务之间的数据也难以直接通用。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、5 个 STT,5 种「我听懂了」
(@SONIX@X)
2、 iRTE2026 定档啦!Voice Agent Builder 们,10 月北京集合~
今年从对话式 AI 一路聊到实时智能,现场有 15+ 论坛、100+ 场深度演讲,汇聚 150+ 全球技术领袖和行业专家,全双工+交互式模型、实时互动世界模型、AI 硬件、AI Coding 工具等方向都会集中开聊。
 贾扬清也将返场 iRTE 大会,带来对 AI 行业前沿趋势和技术演进的最新观察~
 目前大会门票限时免费开放!
想来现场听技术、认识同行的开发者,可以先把票薅上
 时间:10 月 23–24 日
 地点:北京悠唐皇冠假日酒店
限免结束后将恢复收费,建议先报名占位 
定档!从对话式 AI 到实时智能,Voice Agent Builder 的年度春晚 iRTE2026 来了丨 10 月 23-24 日,北京见!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考