AMD 约 82 亿美元收购 World Labs,李飞飞出任执行副总裁兼首席科学家丨日报
本期编辑:@三水、@鲍勃
今天,AMD 将以约 82 亿美元收购世界模型公司 World Labs,李飞飞将出任 AMD 执行副总裁兼首席科学家。
当世界模型开始理解空间、持续模拟环境,并实时响应人的输入,AI 生成的就不再只是一段内容,而可能是一个可以进入、探索和交互的世界。
这也是 RTE 开发者社区最近一直在关注的一条路线:从实时视频生成、空间智能、交互式视频,到可交互世界模型,视频正在从「生成出来给人看」,继续走向「跟人实时互动」。
所以今年 iRTE 2026 实时智能大会专门设置了 「视频 AI 技术专场:从实时视频生成到可交互世界模型」。
现场,生数科技 Vidu 团队会从 SageAttention、Vidu S1/S2 出发,聊视频生成如何进一步走向实时;Xmax AI 也会带来实时交互模型的探索,讨论当生成内容可以持续响应用户之后,会出现怎样的新娱乐和交互形态。
从 World Labs 的可交互 3D 世界,到 Vidu、Xmax 对实时视频与交互模型的探索,这条路线正在变得越来越具体。
如果你也在关注空间智能、实时视频和可交互世界,10 月 24 日,来现场看看这条路线已经走到哪一步。
扫描下方二维码报名,线上追进展,这次线下聊实现。
01 有话题的技术
1、AMD 将以约 82 亿美元收购世界模型公司 World Labs:李飞飞将出任 AMD 执行副总裁兼首席科学家,世界模型团队进入芯片与系统研发体系
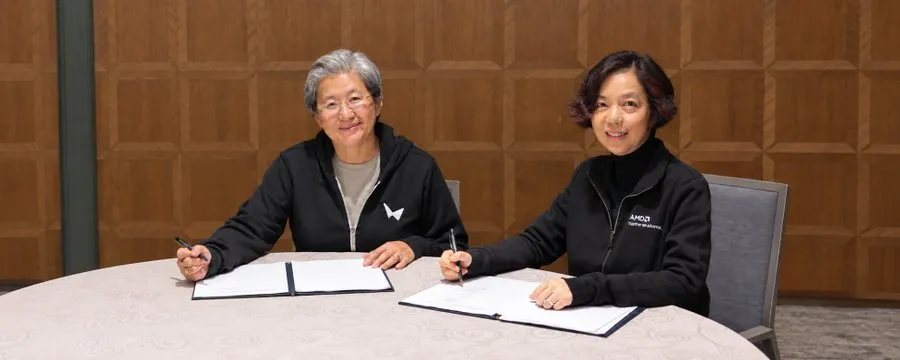
AMD 与 World Labs 签署最终收购协议,这笔全股票交易价值约 82 亿美元,预计在获得监管批准后于 2026 年底前完成。交易完成后,World Labs 创始人李飞飞将加入 AMD,担任执行副总裁兼首席科学家并直接向 CEO 苏姿丰汇报;World Labs 团队将继续推进世界模型研究。
World Labs 从 AMD 的模型优化合作伙伴变成内部研究团队: 双方此前已经围绕 AMD GPU 进行模型训练和推理优化;收购后,World Labs 的模型研究将进一步与 AMD 的硬件、软件和系统研发结合。
AMD 将世界模型能力纳入未来 AI 计算平台研发: World Labs 主要开发可从文本、图像和视频生成、重建和模拟交互式 3D 环境的空间智能模型;AMD 表示,这类模型对机器人、模拟和 Physical AI 等工作负载的计算需求,将直接影响其未来硬件、软件和系统路线。
World Labs 将继续作为前沿模型研究团队运作: 李飞飞加入 AMD 后,Justin Johnson 和 Ben Mildenhall 将继续与她共同领导 World Labs 团队,双方计划构建覆盖硬件、软件、平台和开放模型的端到端 AI 体系。
https://www.worldlabs.ai/blog/amd-announcement
2、YODAS v3 开源 110 万小时 48kHz 多通道语音数据:覆盖 147 种语言,可用于 TTS、音频编解码和空间语音训练
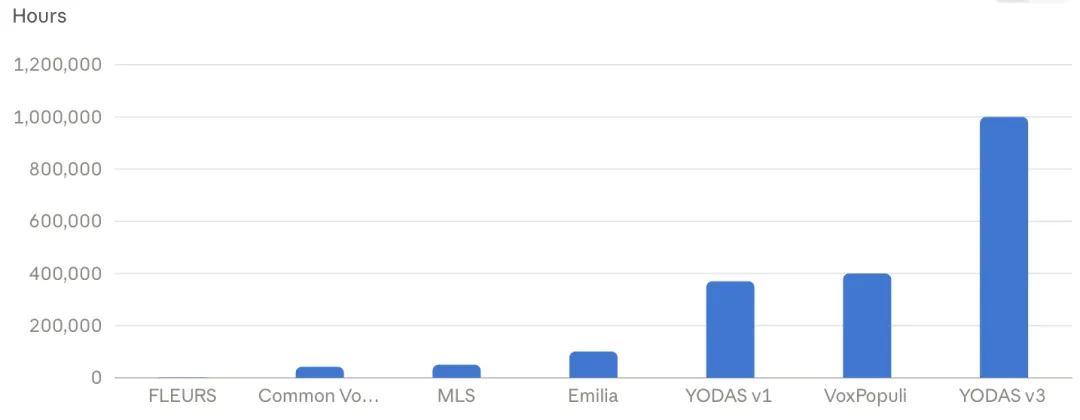
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。相比此前主要面向语音识别的 YODAS,v3 加入更高带宽、多通道和更丰富的时间戳标注,使同一套数据可以进一步用于 TTS、神经音频编解码、语音增强和立体声/空间语音生成。
高采样率不只是文件标称值: 团队根据实际频谱重新估算音频有效带宽,92% 的数据达到至少 32kHz 等效采样率,67% 达到 44kHz,可按音频质量筛选训练数据。
超过 70% 为真正多通道音频: 团队会检测左右声道是否实际不同,避免把复制的单声道算作立体声,为大规模立体声和空间语音模型训练提供数据。
同时提供转写、时间戳和翻译: 约 75% 的数据带有转写,其中 95% 带词级时间戳;约 60% 的非英语数据还提供带时间戳的英语翻译。数据以 CC BY 3.0 许可开放。
https://hf.co/blog/espnet/yodasv3
https://huggingface.co/datasets/espnet/yodas3
https://arxiv.org/abs/2609.29448
https://x.com/chenwanch1/status/2104412499395350674
3、Edge0 发布中英双语流式语音识别模型 Audio8-ASR-Infinite:滚动 KV 缓存支持 24/7 持续转写,延迟最低 240ms
Edge0 发布 Audio8-ASR-Infinite 预览版,面向中英文实时语音识别,提供 80、120 和 160ms 三档流式音频时钟,并可将转写延迟配置在 240–560ms。模型原生上下文为 30 秒,但通过滚动 KV 缓存持续淘汰旧状态,可在内存占用和推理延迟不随音频时长增长的情况下连续运行,用于会议、实时字幕和长期监听等持续转写场景。
流式粒度与延迟可以分别调节: 80ms 模式下模型每秒进行 12.5 次文本决策,120ms 和 160ms 分别为 8.3 和 6.25 次;开发者可以再单独设置目标转写延迟,在响应速度、识别效果和计算开销之间取舍。
30 秒滚动 KV 窗口支持不限时长输入: 推理时只保留固定长度的 KV 状态并重新校正位置编码,因此持续运行时缓存不会随对话长度不断增长。官方适配的 vLLM 推理实现支持 24/7 连续转写。
同时加入语义 VAD: 模型提供 0.5、1、2 和 3 秒多个预测时间范围的语义 VAD,可区分思考停顿、结巴与真正的对话结束,为实时语音 Agent 判断用户是否说完提供额外信号。
https://modelscope.cn/models/Edge0/Audio8-ASR-Infinite
4、Voice Arena 发布 Monsoon ASR 训练语料:覆盖 50 种语言、10 万+小时,Whisper Medium 泰卢固语语义 WER 从 92.7% 降至 16.1%
Voice Arena 发布多语种语音识别训练语料 Monsoon ASR,目前包含 10 万+小时、50 种语言、23 个国家的真实语音,覆盖南亚、东南亚、非洲、欧洲、中东及北非和美洲。数据主要来自双人真实对话中的即兴单人语音,每位说话人单独录制一个声道,重点覆盖口音、非正式表达、噪声和真实声学条件,而不是以朗读语音为主。
同一 Whisper Medium 仅更换训练数据,泰卢固语错误率大幅下降: Voice Arena 使用 Monsoon 微调同一个 7.69 亿参数 Whisper Medium,在 IndicVoices 泰卢固语测试上的语义词错误率从 92.7% 降至 16.1%,模型架构和参数规模没有变化。相关第三方汇总也记录了这一组结果。
数据采集主动增加词汇和声学多样性: 每种语言设计约 5000 个去重主题、覆盖 35 个日常领域,并加入数字、流程、专有名词、地点和产品等长尾内容;语音还会经过语言、说话人和非语音事件等分类筛选,而不是只保留干净录音。
增加数据量后仍未出现明显饱和: 在印地语、泰米尔语和泰卢固语上,使用相同 Whisper Medium 训练方案将数据量从 1000 小时增加到 2000 小时、约 3500 小时后,语义词错误率仍持续下降。Voice Arena 计划到 2027 年 2 月扩展至 100 种语言,长期目标是覆盖 1000 种语言;其官网也已将「Monsoon 扩展至 1000 种语言」列入后续计划。
https://voicearena.com/datasets/monsoon
4、Voice AI 公司 SoundHound 推出端侧智能体语音架构 OASYS Edge:LLM 语音智能体可完全在设备端运行,同一智能体可部署到云端、边缘或混合环境
SoundHound 发布 OASYS Edge,将基于 LLM 的语音智能体完整部署到汽车和智能设备本地,在无网络连接时也能继续完成对话、理解请求和多步骤任务。开发者可以在 OASYS 平台构建一次智能体,再根据硬件与业务需求部署到云端、端侧或混合环境。
端侧不再只处理固定语音指令: OASYS Edge 可在本地理解模糊请求、进行任务决策并协调多个系统。例如在汽车离线状态下,可完成路线规划、沿途地点选择和语音讲解;只有需要联网能力的任务才交给云端。
同一套智能体支持云端、端侧和混合部署: OASYS 此前已经提供智能体构建平台,OASYS Edge 进一步把完整智能体运行环境扩展到边缘硬件,厂商无需分别维护独立的云端和端侧智能体实现。
计划于 2026 年底开始部署: SoundHound 表示 OASYS Edge 将用于汽车和智能设备,目前已提供现场演示,并计划于 2026 年底开始部署。
( @SoundHound )
5、蚂蚁研究团队开源实时声纹验证模型 MECT:9.57M 参数支持 100ms 流式推理,VoxCeleb1 达到 SOTA
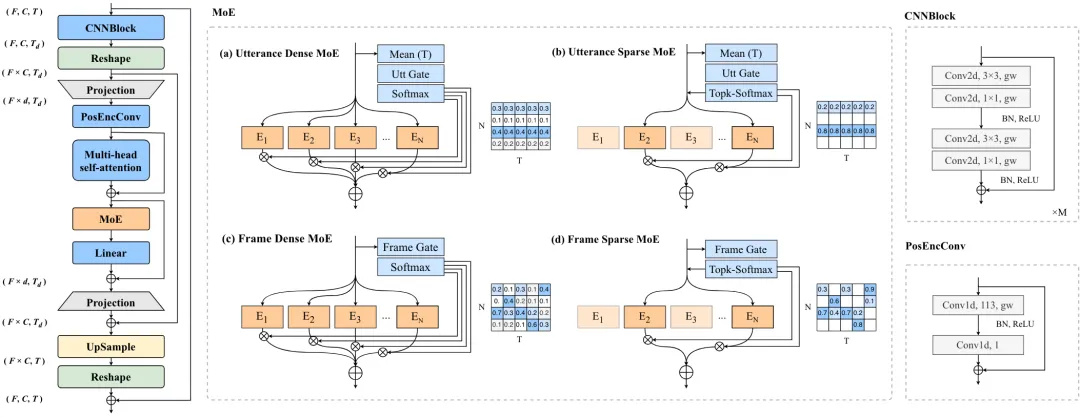
蚂蚁研究团队开源 AntSpeaker/MECT 声纹验证模型,将 MoE 引入 CNN-Transformer 声纹识别架构,并进一步提供支持实时场景的流式版本。MECT 系列模型参数量从 3.78M 到 9.57M,其中 MECT-B2 在 VoxCeleb1 上取得 SOTA;通过因果重训练得到的流式版本在 100ms 音频块下仍能保持接近离线模型的验证性能。
MoE 被用于小型全监督声纹模型: MECT 在 CNN-Transformer 主干中加入专家混合机制,并探索句子级、帧级以及稠密、稀疏路由等四种组合,在只增加少量参数的情况下提升声纹验证性能。
最大模型仅 9.57M 参数: 官方 GitHub 提供 3.78M、4.12M、8.26M 和 9.57M 四种规模,其中 MECT-B2 在 VoxCeleb1-O/E/H 上分别达到 0.27%、0.46%、0.85% EER;加入 VoxBlink2 训练后进一步降至 0.23%、0.29%、0.54%。
新增实时流式声纹验证版本: MECT-B2-Causal 通过因果重训练支持流式推理,论文报告在 100ms chunk 下仍保持较强性能,可用于实时会议、语音助手和端侧声纹验证等低延迟场景。
https://github.com/ant-research/AntSpeaker
6、世界模型公司 Odyssey 发布多智能体世界模型 Agora-2:最多 20 个人类与智能体共享同一实时生成环境,参与者数量较 Agora-1 提升 5 倍
Odyssey 发布 Agora-2 多智能体世界模型,可让最多 20 个人类用户和 AI 智能体进入同一个共享环境实时互动。相比 Agora-1 最多支持 4 名参与者,Agora-2 将参与规模扩大 5 倍,同时从单一环境扩展到多个环境,并支持更复杂、持续时间更长的交互。
所有参与者共享同一套世界状态: Agora-2 会持续维护一个显式共享状态,将所有参与者的位置、动作以及彼此造成的影响纳入模拟;每个人看到的是自己的视角,但其中一个人的动作会改变其他参与者随后看到的结果。
环境由世界模型实时生成,不依赖传统游戏引擎: 当前研究预览基于《Diablo II》的游戏捕获数据训练,模型根据参与者动作和环境状态实时生成画面,并学习角色移动、交互及彼此响应。
当前预览可支持 4 名人类与 16 个智能体同时交互: Odyssey 已开放可玩的多人研究预览,最多 4 名人类玩家可以与 16 个 AI 智能体进入同一个实时模拟环境。
https://odyssey.systems/introducing-agora-2
02 有亮点的产品
1、AI 辅助 PCB 设计平台 HeyPCB 上线多人实时协作:可在同一块板上同步布线、放置元件和编辑外壳
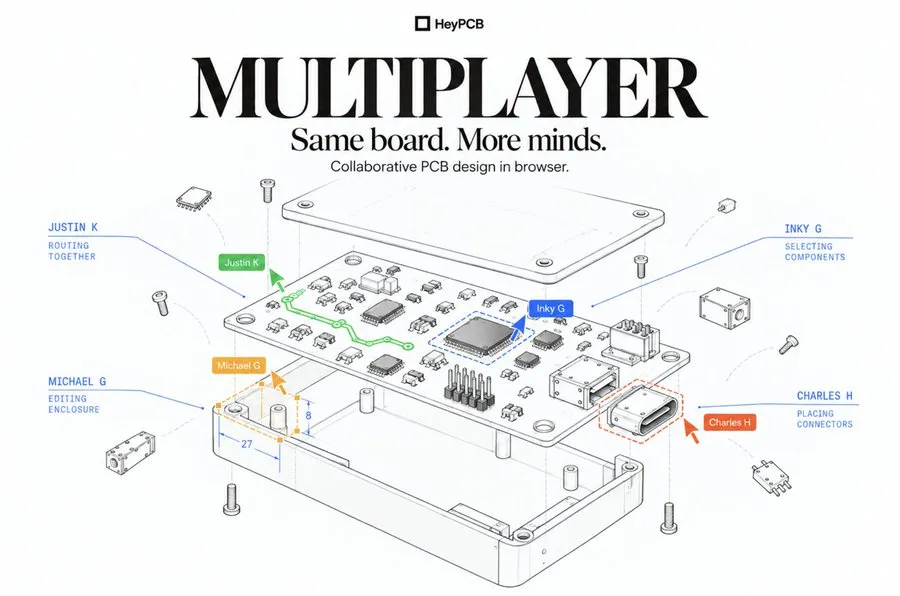
HeyPCB 推出 Multiplayer 多人协作模式,把原本偏单人使用的浏览器 PCB 设计流程扩展为多人共同编辑。团队成员可以直接打开同一个项目,在同一浏览器工作区里实时看到彼此的位置、光标和正在进行的操作。
同一块板可多人同步编辑: 协作者可以共同修改原理图和 PCB,包括布线、拖动和放置元件;官网演示中,多名成员同时在同一项目里编辑不同部分。
协作状态直接显示在编辑器里: 每名成员都有独立颜色和光标,元件选中、拖动、走线过程都会同步显示,还可以点击成员头像跟随对方当前视图。
无需导出或维护第二份副本: 项目可以通过邮件邀请或邀请链接共享,并设置可编辑或只读权限;保存后的原理图和 PCB 修改会同步到其他已打开的界面。
https://heypcb.ai/multiplayer
2、来电识别平台 Truecaller 推出 Scam Checker:诈骗检测从电话号码扩展到链接和消息,无需登录即可在网页查询
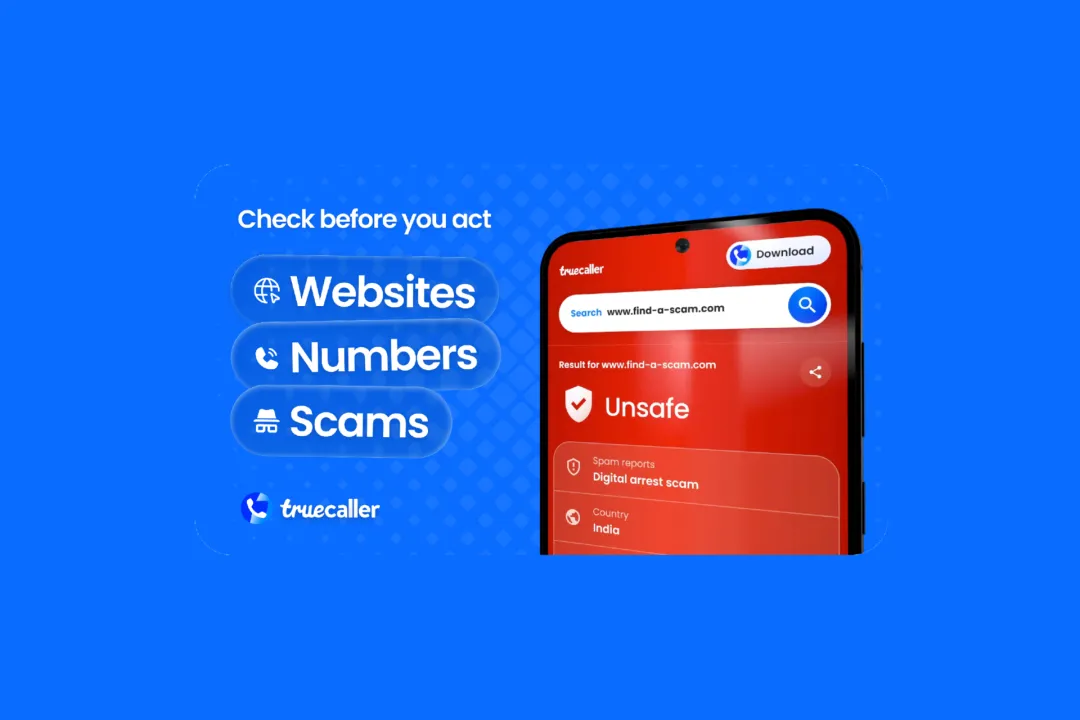
Truecaller 推出 Scam Checker,把过去主要用于来电识别和垃圾电话拦截的诈骗情报扩展到开放网页。用户无需安装 App 或登录账号,就可以提交可疑的电话号码、链接或消息,查看是否与诈骗有关;服务目前首先在印度上线,后续计划扩展到拉美、中东和非洲、东南亚。
检测对象从电话扩展到多渠道诈骗: Scam Checker 可以解析可疑消息中的电话号码和链接,也会展开短链接、跟踪重定向后的最终地址,再结合 Truecaller 自有风险数据库和其他欺诈信号进行判断。
把社区诈骗报告直接带到网页端: 服务会关联 Truecaller 的众包诈骗信息流 ScamFeed;Truecaller 表示印度目前已有约 2 万条诈骗报告,每周新增约 1,300 条。
后续还将支持截图分析: Truecaller 计划继续扩展 Scam Checker 可识别的诈骗类型,并加入截图上传能力,用于进一步分析可疑内容。
https://techcrunch.com/2026/09/27/truecaller-takes-its-scam-intelligence-to-the-open-web-as-it-looks-beyond-caller-id/
03 有态度的观点
1、英伟达推出 AI 智能体安全平台,用独立硬件监控越权行为
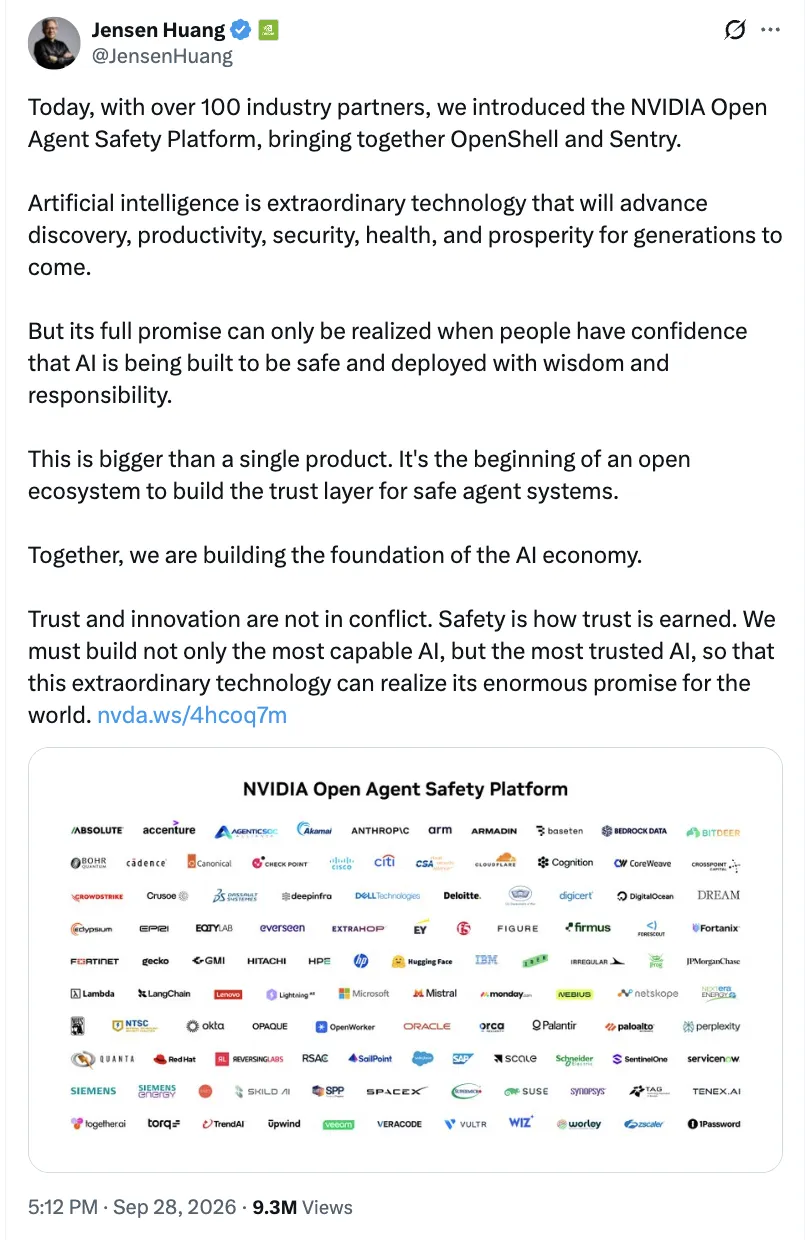
英伟达 9 月 28 日发布 Open Agent Safety Platform,将控制智能体执行权限的 OpenShell 软件,与在独立硬件上监控行为的 Sentry 参考设计组合。
OpenShell 目前已开放使用,可记录智能体操作并限制其访问范围;英伟达称,它也可扩展到 Arm、英特尔等第三方计算平台。
Sentry 设计运行在 BlueField-4 DPU 上,在智能体运行环境之外检查行为。如果智能体试图越过软件设定的边界,系统可将其隔离。英伟达把两层控制分开,是为了让安全规则不完全依赖智能体自身执行;发布材料列出的毫秒级隔离能力仍是厂商描述。
英伟达称,Anthropic 的 Claude Managed Agents 正与 OpenShell、BlueField 集成,Salesforce 则已将 OpenShell 接入 Slack,供团队查看智能体活动并处理额外权限请求。英伟达发布的是开放软件和参考系统设计,具体部署取决于使用方。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 社区活动推荐|
 硬件进化论开始招募辣!
SheNicest × STACK ANYWAY 消费硬件创作赛,国庆 7 天做一个能跑起来的硬件原型。
 Token 全免费 + 一站式 BOM 下单(可到 STACK ANYWAY 官方指定平台,或使用自有设备参赛)
奖金和奖品多多
10 个入围项目直接到 WTCC 线下展出 + 卖客松拍卖
个人 / 组队都行,从 0 到 1 或旧物改造都欢迎
 报名截止时间:9 月 30 日中午 12 点之前
报名方式:扫码报名!
线上征集 不限地点!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考