Block 发布全双工模型 Dessa:不靠文本、只听真人对话训练丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、Square、Cash App 母公司 Block 发布纯语音全双工模型 Dessa:无需文本和预训练模型,单机柜训练、MacBook M4 Max 本地运行
Square、Cash App 母公司 Block 发布全双工语音模型 Dessa 研究预览,探索不依赖文本训练语言智能的新路线。Dessa 从零开始,仅使用人类真实对话录音训练,不使用文本转录数据或预训练语言模型,直接实现音频输入、音频输出。模型能够边听边说、自然插话、附和并表达情绪。Block 宣称,Dessa 仅使用一套 NVIDIA GB200 NVL72 系统完成训练,推理速度快于实时,并可在 M4 Max 及以上配置的 MacBook Pro 上本地运行。
完全从语音学习语言,不经过文字中间层: 与先将语音转换为文本、再由 LLM 生成回复并调用 TTS 的传统管线不同,Dessa 直接学习人类对话录音中的语言内容、声音变化和互动规律。团队称,训练过程中没有使用文字、转录标签或任何预训练模型。Block 还表示,Dessa 学习语言所需接触的词汇量比大型文本语言模型少数百倍,但尚未公布训练音频总时长及具体数据规模。
原生全双工交互,能够边听边说和主动插话: Dessa 不需要等待用户完全停止说话才能作出回应,而是可以持续接收语音,同时生成自己的语音。模型通过真实对话学习什么时候应该打断、什么时候保持倾听,以及如何自然地说出「嗯」「明白」等简短附和。Block 公布的演示包括聊天、猜谜、情绪交流,以及 Dessa 与 OpenAI GPT-Live-1 之间的实时语音对话。
直接理解与表达声音中的情绪信息: 因为不需要把声音压缩成文字,Dessa 可以利用语调、停顿、笑声、叹气等非文本信息判断对话状态,也能在输出时改变语气和情绪。官方演示展示了模型的笑声、低语、语调变化和带有情感色彩的回应。团队认为,这种原生声音理解能力有助于改善语音 Agent 在复杂人际交流中的表现,尤其是传统文本转写容易丢失的讽刺、犹豫和情绪线索。
单套 GB200 NVL72 完成训练,支持消费级电脑本地推理: Block 表示,Dessa 的训练使用了一套 NVIDIA GB200 NVL72 机柜级系统,即包含 72 颗 GPU 的计算平台,而非单张显卡。模型推理速度可超过实时音频生成需求,并能够在搭载 Apple M4 Max 或更高配置芯片的 MacBook Pro 上本地执行。团队尚未披露模型参数规模、内存占用、首包延迟或具体实时系数,这些硬件性能声明目前也缺少独立复测。
Dessa 由 Block 内部的小型 AI 研究团队开发,核心成员来自 2020 年被 Square 收购的多伦多语音 AI 公司 Dessa。团队由 Ragavan Thurairatnam 领导,直接向 Twitter(现 X)联合创始人、Block 创始人 Jack Dorsey 汇报。此次发布于 10 月 23 日,目前仍是研究预览,并未开源模型权重或提供公开 API。Block 已展示多段未经脚本引导的对话录音,并邀请少量 AI 安全研究人员申请早期访问。由于尚无公开论文、标准化评测成绩及第三方测试,Dessa 在推理能力、长对话可靠性和情绪识别方面的实际表现仍有待进一步验证。
https://block.xyz/dessa
2、法国语音 AI 公司 Gradium 开源 Phonon 端侧 TTS:31M 参数、在 MacBook Air M5 上 7ms 生成首段语音,支持浏览器离线运行
法国语音 AI 公司 Gradium 正式开放轻量级语音合成模型系列 Phonon,主打在手机、笔记本电脑、嵌入式设备和浏览器中直接生成自然语音,无需依赖云端 TTS API。其中,Phonon 31M 模型采用 Apache 2.0 许可证,8-bit 量化权重仅约 64MB。官方测试显示,该模型在 MacBook Air M5 上生成首段音频最快约 7ms,适合低延迟语音 Agent、离线助手和设备端语音交互。
31M 参数、64MB 权重,单颗 CPU 即可运行: Phonon 31M 专门针对端侧推理优化,支持在普通电脑 CPU、手机、树莓派和浏览器中运行。在 MacBook Air M5 上,使用 4 个 CPU 线程、未启用额外 Arm 加速库时,模型生成首段音频约需 6.9ms,生成吞吐率达到实时的 29.9 倍;在 Raspberry Pi 5 上,首段音频生成时间约为 38ms,吞吐率为实时的 3.7 倍。这些指标来自官方测试,衡量的是模型推理性能,不包含模型加载、网络传输或完整语音对话链路延迟。
采用逐帧流式生成架构,无需等待整句话合成完成: Phonon 基于因果 Transformer,将文本和说话人特征编码后,每次预测约 80ms 的音频潜在表示,再通过单步 Flow Matching 和轻量化 Mimi 解码器生成 24kHz PCM 语音。模型可以边计算边输出音频,而不是先生成完整句子后再播放。31M 版本采用 6 层 Transformer,40M 版本增加至 9 层。
三类模型覆盖英语与五种语言,但许可证不同: 此次发布包括 Phonon 31M、Phonon 40M 单语言版和 Phonon 40M Multilingual。31M 版本支持英语,提供 37 种预设声音,采用 Apache 2.0 许可证;40M 单语言版分别支持英语、法语、德语、西班牙语和葡萄牙语,多语言版则通过同一组权重支持全部五种语言,并提供 102 种预设声音。两类 40M 模型均采用 CC BY-NC 4.0 非商业许可证,商业使用需要另行取得授权。
支持浏览器本地推理,也能接入现有 Voice Agent: Gradium 同步开源基于 Rust 的推理框架 xn-ptts,提供 Python、Rust、Swift、JavaScript/WebAssembly 接口,并支持 WebGPU、CUDA、Metal、Core ML 和 Snapdragon NPU 等计算后端。开发者可以将模型直接集成到网页或移动应用,也可以通过 WebSocket 服务和兼容 OpenAI TTS 接口的本地服务器接入语音智能体。官方浏览器 Demo 在首次下载模型后,即可直接在设备本地完成语音合成。
支持音色克隆与设计,复杂文本识别错误率为 1.70%: Phonon 支持使用预设音色,也能通过 Gradium Studio 或 API 克隆声音、通过自然语言设计新音色,再将生成的音色文件下载到设备端离线使用。团队还构建了每种语言 500 句的困难文本测试集,覆盖电话号码、日期、版本号等容易读错的内容。官方测试中,英语 Phonon 31M 的转写词错误率(WER)为 1.70%,低于同一测试中 Kokoro 的 3.50%。该成绩来自厂商自建测试集,尚不能直接等同于通用语音质量排行榜成绩。
Phonon 于 10 月 20 日发布开源版本,模型权重已上线 Hugging Face,推理代码也已公开。需要注意,31M 参数规模不包含音频 Tokenizer;另外,声音克隆所需的音色提取目前仍依赖 Gradium Studio 或 API,下载音色文件后才能在本地离线生成语音。对于希望在设备上私有化运行 TTS 的开发者,Phonon 提供了一条无需持续支付云端语音生成费用的部署路线。
https://gradium.ai/blog/release-phonon-open-weight
3、Ollama 首次支持本地语音合成:接入 Gradium Phonon 31M/40M,支持流式 TTS 与 OpenAI 兼容 API,M5 Max 推理提速 35%
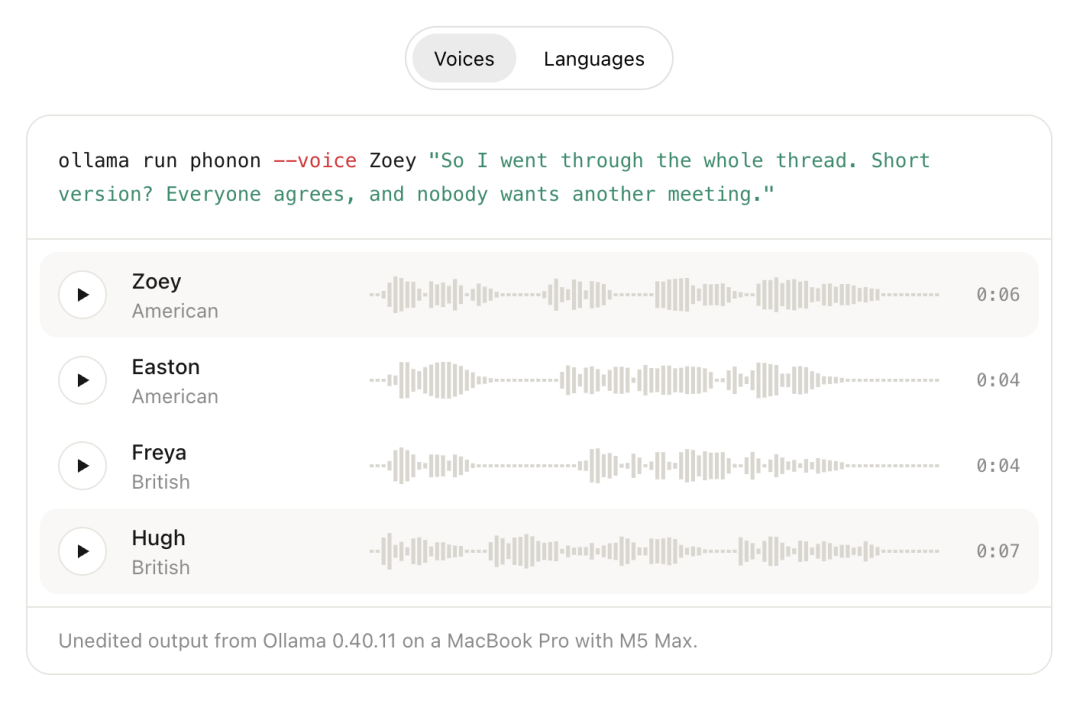
本地 AI 模型运行平台 Ollama 正式加入语音合成(TTS)能力,首批支持法国语音 AI 公司 Gradium 开源的 Phonon 模型系列。开发者现在可以直接通过 Ollama 在 Mac 上将文本转换成语音,并通过兼容 OpenAI 的 API,为现有聊天机器人和语音 Agent 添加本地语音输出。官方测试显示,在 MacBook Pro M5 Max 上,Ollama 的 Phonon 推理速度比 Gradium 自有运行时快 35%,并支持边生成边播放音频。
首次加入原生 TTS 支持,覆盖 31M 和 40M 模型: Ollama 此次接入 Phonon 31M 英语模型,以及 Phonon 40M 的英语、法语、德语、西班牙语、葡萄牙语和五语言混合版本。开发者只需运行
ollama pull phonon下载默认模型,再通过ollama run phonon "Hello from Ollama."即可生成语音。平台还支持使用--voice参数切换 Gradium 音色库中的不同声音,无需自行安装 PyTorch 或单独搭建 TTS 推理服务。利用 Apple MLX 加速,M5 Max 性能超过原生运行时: Ollama 基于 Apple 的 MLX 框架优化 Phonon 推理。官方在 MacBook Pro M5 Max 上,以生成 45 秒语音、重复测试 10 次取中位数的方式进行对比,结果显示 Ollama 比 Gradium 的
ptts运行时快 35%。不过,Ollama 使用 BF16 精度,而对比运行时在不同计算设备上使用不同精度,因此这一结果属于指定硬件和实现条件下的吞吐率对比,不代表完整语音交互延迟。兼容 OpenAI TTS API,可直接接入现有语音应用: Ollama 新增
/v1/audio/speech接口,支持通过model、voice和input指定模型、音色与文本。开发者可以将 OpenAI SDK 的base_url改为http://localhost:11434/v1,调用本地 Phonon 生成语音。接口支持流式返回音频,默认输出 24kHz、单声道、16-bit WAV,也支持原始 PCM 格式,便于接入播放器和实时语音管线。可与本地 LLM 组成流式语音助手: Ollama 展示了将 Gemma 4 的文本回复直接传给 Phonon 的组合方式。当 LLM 输出第一句话后,TTS 就可以开始合成和播放,无需等待整段回答生成完毕。这让开发者能够在本地搭建 LLM → 流式 TTS 的语音输出流程,适用于离线助手、文本朗读和隐私敏感的语音应用。不过,Phonon 本身只负责语音合成,完整双向语音对话仍需要额外接入 ASR 和轮次管理组件。
目前该功能已在 Ollama 0.40.11 及更新版本中面向 Apple Silicon Mac 开放,Windows 和 Linux 支持仍在开发中。模型许可也存在区别:默认的 Phonon 31M 采用 Apache 2.0,支持商业使用;40M 系列采用 CC BY-NC 4.0,限制商业用途。
https://ollama.com/blog/speech-models
4、法国 AI 公司 Mistral 发布 Voxtral 3:四款语音模型覆盖实时转写与 TTS,推出 Voice Agent SDK,支持私有化部署
法国 AI 公司 Mistral AI 发布新一代语音模型系列 Voxtral 3,包含三款语音识别模型和一款语音合成模型,同时推出 Voice Agent SDK。开发者可以将实时转写、LLM 推理、工具调用和语音合成组合成一条流式语音交互管线,并根据业务需要独立调整模型与音色。Voxtral 3 的批量转写支持 50 种语言,TTS 覆盖 35 种以上语言和 50 多种方言,官方宣称优化后的语音 Agent 单轮交互可在 1 秒以内完成。
三款语音识别模型,覆盖录音转写与实时对话:Voxtral Mini Transcribe 3 是一款 4B 参数的轻量级转写模型,支持多语言识别、说话人区分和专业词汇增强,API 定价为 0.0035 美元/分钟;Voxtral Small Transcribe 3 面向更高精度的会议、客服和专业录音场景,价格为 0.004 美元/分钟。两者均支持 50 种语言。面向实时语音 Agent 的 Voxtral Mini Transcribe Realtime 3 则通过 WebSocket 持续转写音频,支持 80–2400ms 可配置流式延迟、说话人识别和自动判断用户是否说完,价格为 0.008 美元/分钟。实时版本的语言覆盖范围与批量版本不同,不能直接视为全部支持 50 种语言。
TTS 支持 35 种以上语言、50 多种方言和情绪控制:Voxtral Mini TTS 3 可以根据上下文调整语气、语速、重音和情绪,也支持开发者显式指定表达方式。模型提供零样本声音克隆,并可使用约 30 分钟录音进行专业音色适配。官方公布的流式语音首包时间约为 90ms,API 定价为每 100 万字符 13 美元。这一时间是语音合成环节的指标,不代表完整语音 Agent 的响应时间。
支持 WebRTC、SIP 电话接入与模块化部署:支持通过 WebRTC 接入浏览器和应用,也可通过 SIP 与电话系统、呼叫中心及 IVR 流程集成。开发者可以独立配置推理模型、语音模型与音色,不必将整个语音工作流绑定到单一的端到端 S2S 模型。Mistral 还提供托管式 Voice Agent API,使用 Mistral Small 4 推理时定价为 0.04 美元/分钟,选择更大推理模型时为 0.08 美元/分钟。
支持企业自部署,但不等同于全部模型开源: Voxtral 3 已通过 Mistral API 开放,支持欧洲、美国及全球服务端点。企业还可联系 Mistral,将完整语音模型及 Agent 管线部署到自有基础设施或私有云,以控制音频数据处理位置和留存策略。不过,此次发布的 Voxtral 3 模型标记为 Premier,企业自部署需要单独洽谈,并非所有模型权重均已公开供开发者自由下载。
Voxtral 3 于 10 月 20 日发布,首批四款模型目前均处于 Public Preview 阶段。此次发布的技术路线是将语音输入、语言推理、工具调用和语音输出组成可配置的模块化流式管线,与将听、理解和说话统一到单个模型中的端到端 S2S 路线形成区别。
Mistral 宣称语音 Agent 能实现低于 1 秒的单轮交互,但尚未公布与其他方案在相同网络、硬件和任务条件下的完整端到端延迟对比。
https://mistral.ai/news/voxtral-3/
5、微软 Copilot 设计师 Qian Jiang 展示 AI 健身助手原型:面向居家运动场景,探索实时动作反馈与交互式指导
微软 Copilot 产品设计师 Qian Jiang 在 X 上分享了一款正在开发的 AI 健身助手,希望让用户在家锻炼时就能获得实时反馈,而不是只能跟随预录的教学视频完成动作。项目聚焦运动过程中的持续交互,探索 AI 如何在用户实际训练时扮演随身健身教练。
从预录教学转向实时运动反馈: 传统居家健身应用主要提供训练计划和跟练视频,用户需要自行判断动作是否标准。该项目的目标是在锻炼过程中持续提供反馈,让指导与用户的实际运动状态保持同步,减少训练结束后才能发现问题的情况。
探索实时视觉理解与 AI 教练的结合: 这类应用的关键挑战是将运动过程中的视觉信息转化为及时、易理解的指导,同时避免频繁提示打断用户的训练节奏。开发者目前尚未公开完整技术架构,无法确认其是否采用独立人体姿态估计模型、实时多模态大模型,或两者组合的方案。
目前属于个人开发原型: 现有公开信息表明项目仍在开发中,尚未确认独立应用的正式上线时间、支持的运动类型、动作识别准确率或端到端反馈延迟,也未查到配套的开源代码和 API 文档。
这类应用的核心价值在于把 AI 从生成健身计划推进到参与实时训练过程。不过,运动动作识别与安全指导对摄像头视角、身体遮挡和判断准确性要求较高。该演示目前更适合作为实时多模态交互的产品探索,而非已经完成效果验证的健身教练产品。
https://x.com/qianjiang___/status/2114429212723744932
02 有亮点的产品
1、网易《蛋仔派对》推出实体 AI 玩具「蛋小黄」:9 种 LED 情绪表情、长期记忆与语音陪伴,支持碰一碰交友
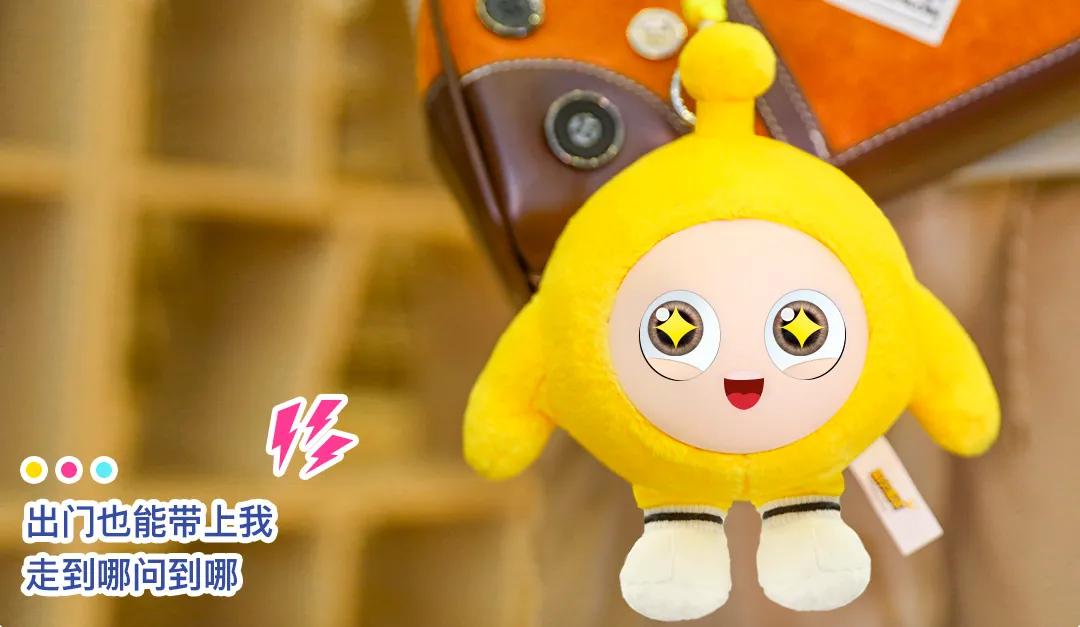
网易智企·云信联合 AI 硬件公司鲁米特(LOOMIT),将国民级游戏《蛋仔派对》的角色首次转化为实体 AI 陪伴玩具 「蛋小黄」。产品主打儿童情感陪伴,通过实时语音对话、情绪感知、长期记忆和触摸交互,让游戏角色成为日常生活中的「AI 蛋搭子」。网易披露,《蛋仔派对》目前拥有超过 7 亿注册用户、月活跃用户超过 1 亿,为游戏 IP 向 AI 硬件延伸提供了庞大的用户基础。
9 种 LED 眼神与触摸反馈,让 AI 角色具备可感知的情绪表达: 蛋小黄通过内置 LED 屏幕呈现开心、惊讶、思考、调皮等 9 种眼神变化,并根据触摸、摇晃及语音互动触发不同反馈。例如,摸头时会眯眼发笑,摇晃时则会出现旋转的眼神。团队最初设计了二三十种表情方案,最终保留 9 种,以积极情绪为主,强化《蛋仔派对》角色的性格一致性。
结合语音情绪识别与长期记忆,打造持续陪伴体验: 蛋小黄搭载由网易智企参与定制的 AI 对话能力,以及鲁米特自研的角色 Agent 框架。官方称,系统可以根据用户的语气、停顿和说话状态判断情绪,在检测到沮丧或低落时主动提供安慰。同时,长期记忆功能可记录生日、个人喜好和过往对话内容,并在后续交流中引用,让 AI 不再局限于单次问答。
学习与游戏双模式,支持儿童启发式对话: 产品内置英语练习、语文、数学问答、历史知识、成语接龙及故事互动等内容。团队并未将其设计为单纯回答知识问题的工具,而是强调通过提问、讲故事和游戏互动引导孩子思考。鲁米特还与教育科技品牌良师严选合作,计划持续扩展面向青少年的 AI 互动教育内容。
「碰一碰」实现实体 AI 玩具社交,配套家长端管理: 两只蛋小黄轻轻碰触后,可以建立好友关系,并同步至配套小程序的好友列表;再次相遇时,设备能够识别已有好友。家长则可以通过小程序查看对话时长、活跃时段和高频话题等成长周报。官方介绍,产品采用本地与云端混合架构,并对会话数据提供加密保护,但尚未公开完整的数据处理流程或第三方隐私安全评估。
「蛋小黄」于 2026 年 6 月首次对外亮相,8 月进一步拓展教育渠道,近期受到行业媒体关注,并非 10 月首次发布的新硬件。据报道,产品售价约 500 元人民币。目前官方尚未公布底层语音模型参数、端到端对话延迟、情绪识别准确率或独立评测结果。
(@多知)
2、清华系 CyboPal 再获 TCL、深创投战略投资:27 英寸 4K 桌面机器人预售超 1000 台,探索 Personal Agent 通用交互系统
清华系具身智能公司 细胞壁科技(CyboPal) 宣布完成新一轮战略融资,投资方为 TCL 实业战投和深创投,心流资本 FlowCapital 担任长期独家财务顾问。距离公司今年 8 月获得东方富海、联想之星等机构数亿元融资,尚不足三个月。此次融资将支持其面向 Personal Agent 的软硬件交互系统研发。公司披露,首款桌面机器人终端 CyboPal ONE 近一个月各渠道预售超过 1000 台,预售金额超过 1000 万元人民币。
27 英寸 4K 屏幕搭配六自由度机械臂,让电脑主动适应用户: CyboPal ONE 将 27 英寸 4K、160Hz 显示屏、六自由度机器人运动机构和 AI 计算底座整合为桌面终端,通过视觉感知和运动控制,根据用户的坐姿、站姿及观看距离主动调整屏幕位置。设备支持语音控制、手势操作和预设位置切换,可连接 Windows、macOS 和 Linux 电脑使用。官方还设计了碰撞检测、安全边界和紧急停止机制,以适应真实桌面环境。
提出「说、改、切、批」交互框架,面向多步骤 Agent 工作流: 团队希望将传统的键盘、鼠标和窗口操作,转变为人与 AI 智能体持续协作的过程。用户可以通过自然语言提出目标、补充或修改要求、切换应用和任务,并在关键步骤确认授权。CyboPal ONE 已介绍语音输入、文本修改、窗口控制等功能;更完整的跨任务编排与 Agent 协作能力仍在持续开发中。
两款硬件共享交互底座,覆盖固定桌面和移动办公: 除桌面机器人 CyboPal ONE 外,公司还开发了 AI 工作掌机 WhisPrompt,通过语音、按键、触控板和旋钮,让用户在笔记本及移动办公场景中快速下达指令、调整 AI 输出和确认操作。两款产品计划共享语音、视觉、意图理解及任务反馈能力,探索在不同设备、软件和工作场景之间延续的 Personal Agent 交互体验。
从硬件入口切入具身交互模型与 Agent OS: 细胞壁科技由清华大学精密仪器系博士 彭天放 创立,团队研发能力覆盖机器人本体、运动控制、嵌入式系统、多模态 AI 和 Agent 软件。公司正研究如何结合语音、视觉、用户工作状态和任务上下文,构建连接用户、终端与 Agent 的通用交互层。其定位不是取代 Windows、macOS 等操作系统,而是在现有 PC 之上增加面向 AI 协作的新交互方式。
目前 CyboPal ONE 已开启海外众筹及预售,官网公布的早鸟价格为 1499 美元,首批交付计划于 2026 年底启动;WhisPrompt 仍在推进发售准备。需要注意,此次新一轮战略融资的具体金额和估值尚未披露,超过 1000 万元为公司公布的预售金额,并非已确认交付收入。
CyboPal 的核心探索是让 Personal Agent 不再局限于电脑里的聊天窗口,而是通过语音、实体控制和可运动终端参与日常工作。不过,其自研交互模型的参数规模、端到端响应延迟和跨应用任务成功率,目前尚未公布可独立复现的测试结果。
( @Z Potentials)
3、联想参股企业智体科技推出儿童 AI 语音打印机「话画宝」:按键说话生成图案,打印后可直接涂色
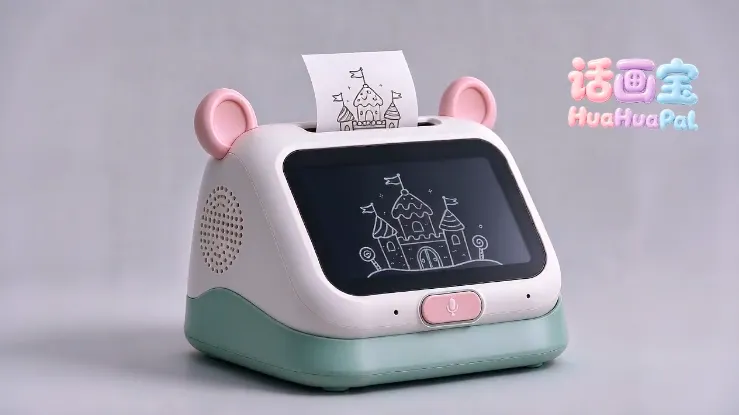
联想集团参股企业 广州智体科技 近期预热儿童 AI 语音打印机 「话画宝(HuaHuaPal)」,将语音交互、AI 图像生成与实体打印结合。孩子只需按住语音键,说出自己想象中的画面,设备就能生成对应的图案,并打印到纸上供孩子涂色。产品目前仍处于预热阶段,尚未正式上架销售。
从语音描述直接生成可涂色图案: 话画宝的核心交互是「说话—生成图案—打印—涂色」。例如,孩子可以通过语音描述想要的角色或场景,由 AI 将创意转化为图画,再通过机身顶部的出纸口打印出来。与普通语音陪伴玩具不同,它将 AI 生成内容转化为可触摸、可继续创作的实体作品,让儿童不必一直盯着屏幕完成创作。
采用实体语音按键与屏幕结合的交互设计: 从已披露的产品外观来看,话画宝采用马卡龙配色,顶部带有小耳朵造型及打印出纸口,正面配置显示屏,屏幕下方设有麦克风图标按键。孩子通过按住按键发起语音创作,降低了输入文字提示词的操作门槛。官方尚未公布屏幕规格、打印技术、图像生成耗时或设备是否支持离线运行。
研发方来自智慧交通领域,联想持股约 30.6%: 话画宝由 广州智体科技有限公司研发,而非联想集团直接发布的自有品牌产品。智体科技成立于 2016 年,原有业务包括出租车、网约车智能终端和运营管理平台。其官网明确标注公司为联想集团旗下成员企业,联想系企业广东联想懂的通信持股约 30.62%。智体科技曾于 2024 年获得联想懂的通信战略投资,此次进入儿童 AI 硬件领域,属于从智慧交通设备向消费级 AI 终端的跨界拓展。
瞄准儿童 AI 创作硬件赛道: 与传统的儿童 AI 聊天玩具相比,语音绘画打印机更强调创作结果的实体化。同类产品还包括将口头描述打印成贴纸的 Stickerbox、myFirst Insta magiBox,以及通过投影辅助儿童绘画的 Luka AI。话画宝采用相似的语音创作入口,但目前尚未公布生成模型、内容安全机制、打印耗材成本或其他能够独立验证的技术差异。
(@多知)
03 有态度的观点
1、阿波罗首席经济学家:AI 回报还没体现在科技业以外的利润率上
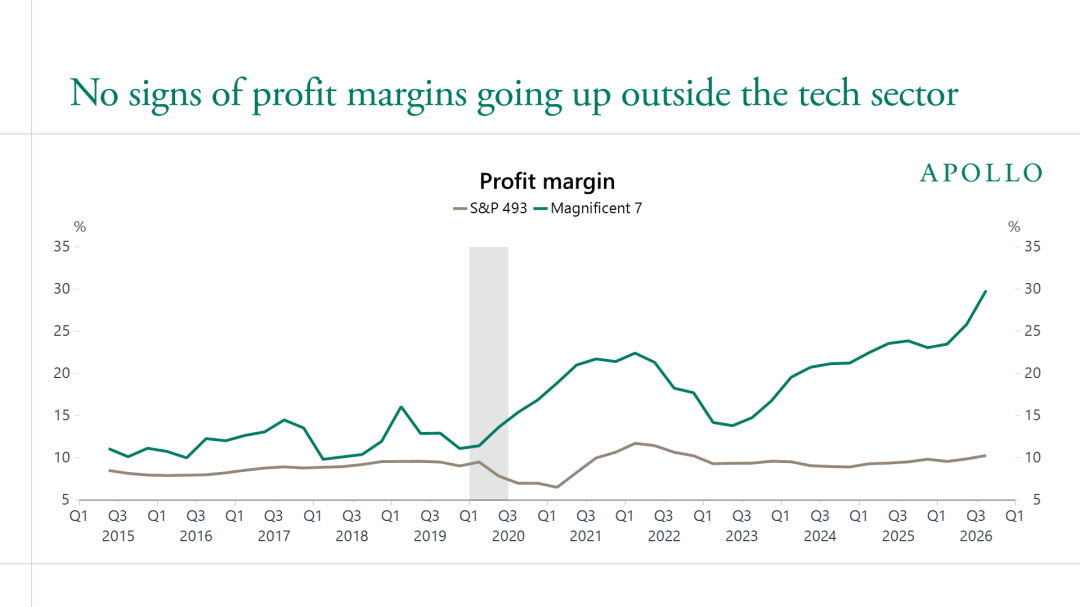
阿波罗全球管理公司首席经济学家 Torsten Slok 在 10 月 24 日的署名专栏中提出,科技行业之外的美国企业,尚未显现 AI 带来的财务回报。他将科技「七巨头」与标普 500 指数其余 493 家公司作比较:前者的人均营收和利润率上升,后者的相关指标仍较平。Slok 认为,风投支持的企业在持续增加 Token 支出,但主流企业未必需要最新模型,也不愿为其付费。
如果投入没有反映在经营结果上,Token 费用就容易被当作压低利润率的成本。只要智能体和相关支出仍集中在经济的一小部分,AI 的宏观影响就会有限。他接着提出,即便模型价格下降,企业仍要把更便宜的智能转化为营收和利润增长。
商业判断依赖具体情境,也涉及问责、信任、文化、未成文规则和伦理取舍;他认为,AI 对这些因素的理解仍有欠缺。Slok 因而将其余 493 家企业的经营指标视为检验 AI 回报的重要依据,科技巨头的增长不足以代表其他行业。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、社区活动分享| 叠加态之夜 · 首次线下分享会(北京)
量子计算 × 具身智能的哈希碰撞
当量子计算撞上 Physical AI,会碰出什么新的计算范式?
叠加态社区 Superposition × 数耀量生 QuantSparkle 首次线下聚会:两场硬核 Talk、一场灵感圆桌、一顿边吃边聊的晚餐。【现场更有来自智元、minimax、谋先飞、玻色量子等专家沟通交流】
 10月30日(周五)18:00–20:30(17:30 起签到,签到领伴手礼)
 北京·798 艺术区(报名筛选通过后,入群告知具体地点)
 免费 · 限额 40 人 · 报名需筛选
 扫海报二维码报名
开放报名|量子计算 X 具身智能的哈希碰撞——「叠加态之夜」首次线下交流聚会
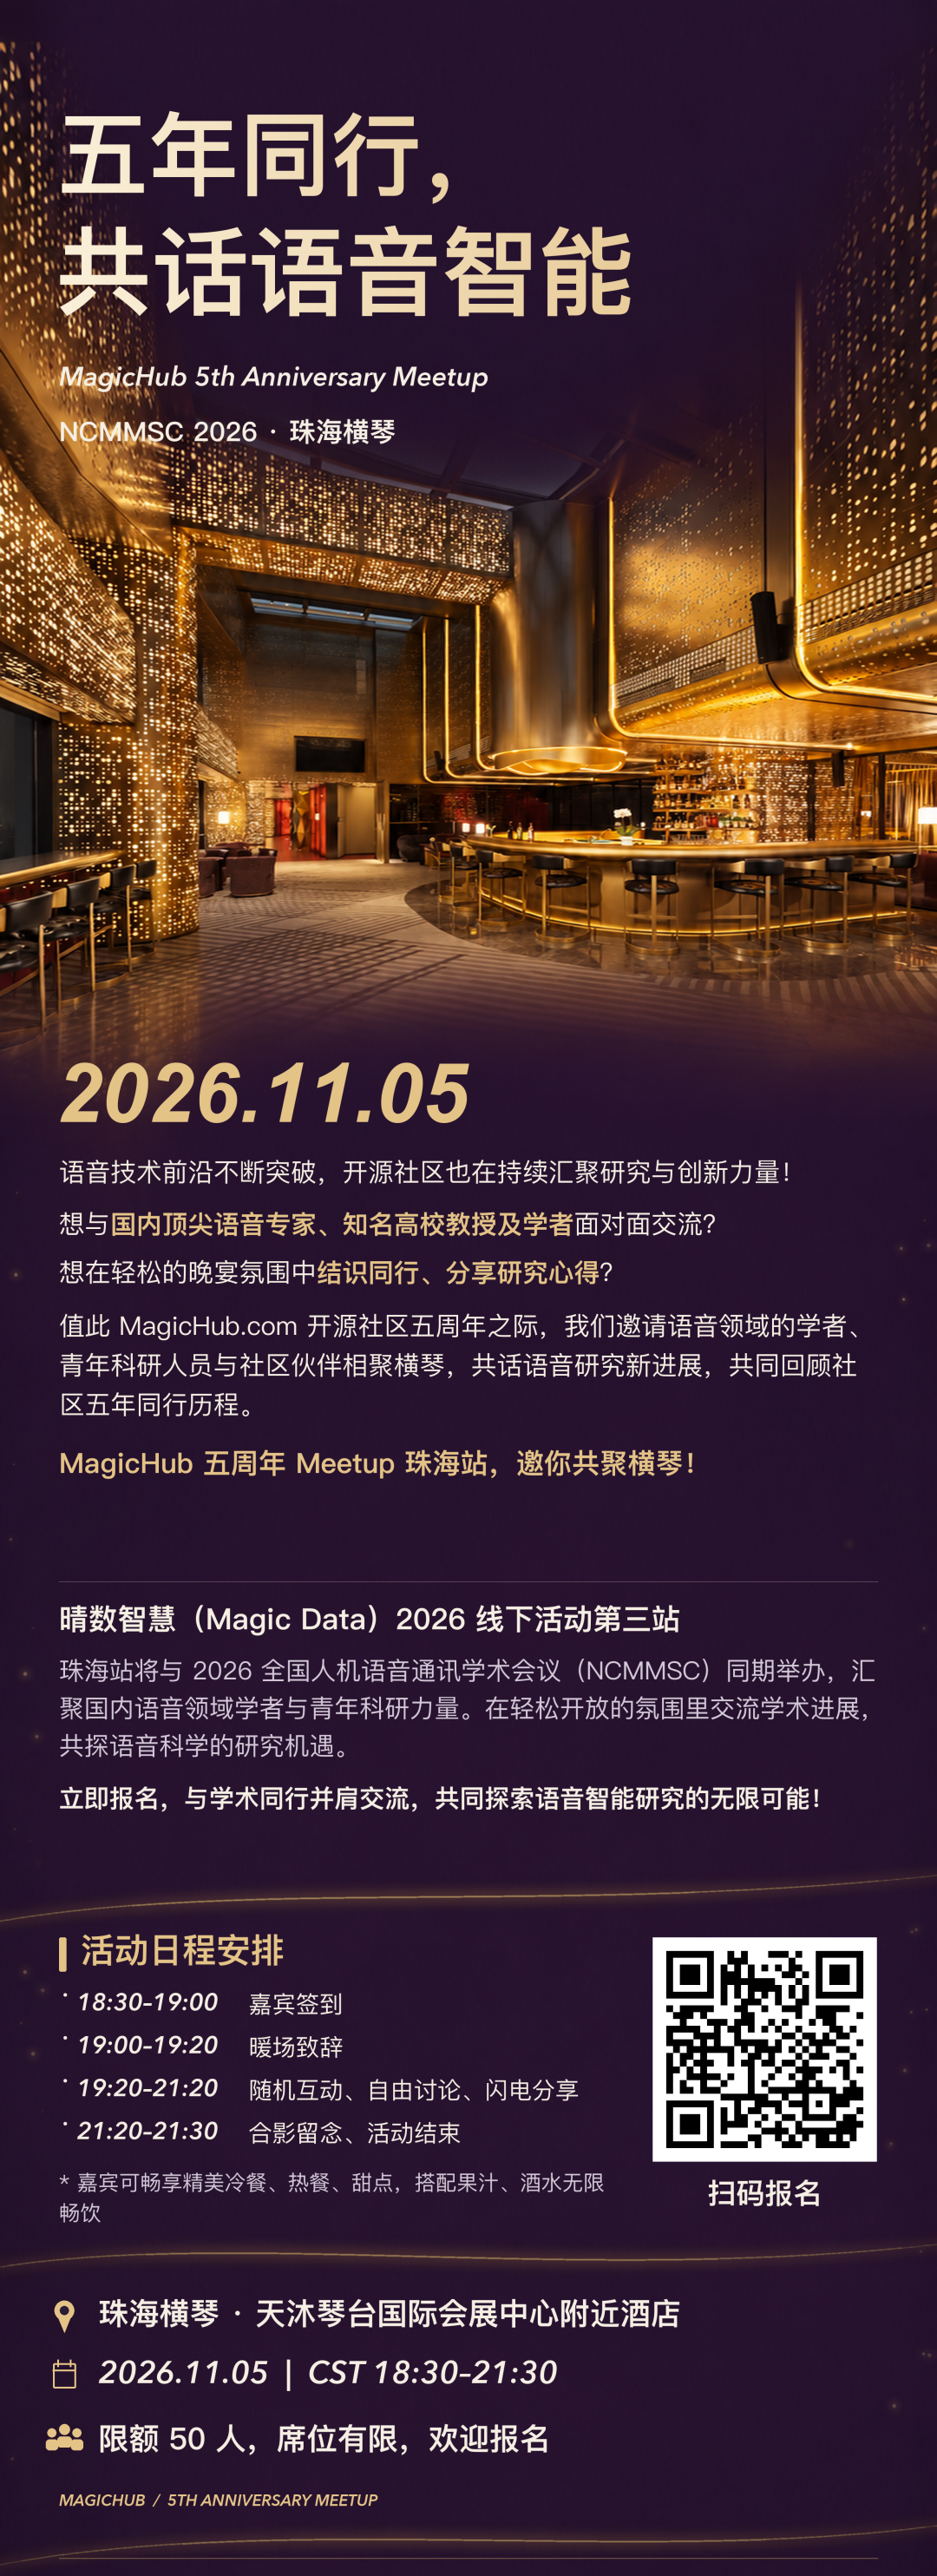
2、社区活动推荐|MagicHub 五周年 Meetup 开始报名啦!
 想和国内顶尖语音专家、高校学者面对面交流?
在轻松晚宴里认识同行,聊聊研究收获?
NCMMSC 2026期间,MagicHub 诚邀语音领域科研伙伴相聚珠海横琴,一起探讨语音研究新方向!
 11 月 5 日 16:30|珠海横琴
3、 RTE 社区活动推荐|一起看看 AI 硬件的新探索
最近,极米记得团队正在带来一些 AI 硬件方向的新尝试。
11 月 1 日,他们将在深圳 INNO100 全球创新旗舰店展示全系列 AI 新品,包括 AI 显示眼镜、AI 记忆眼镜和智能手环。
邀请 RTE 社区里关注 AI 硬件的创客、极客朋友们,一起去现场看看真实的产品体验,和团队聊聊背后的技术、产品思考与创新探索。
活动信息
时间:11 月 1 日(周日)14:00
地点:深圳 INNO100 全球创新旗舰店
 RTE 社区专属小福利
报名时,在报名来源填写「RTE」,活动将从中抽取 1 位伙伴成为新品内测体验官,并赠送记得手环一只。
期待更多有意思的创业探索被看见,也欢迎大家到现场交流,给创新团队一些真实的反馈与灵感 
极米记得AI新品全阵容亮相INNO100,限量现货同步开售!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考