OpenAI 宣布 12 月停用 GPT 旧语音模式,全面转向全双工 GPT-Live丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、OpenAI 宣布 12 月 11 日停用 ChatGPT 旧语音模式:Advanced 与 Standard 退出,全面转向全双工 GPT-Live
11 月 10 日,OpenAI 宣布将于 2026 年 12 月 11 日停止在 ChatGPT 中提供 Advanced Voice 和 Standard Voice 两种旧语音模式,统一转向基于 GPT-Live 的 Live Voice。OpenAI 表示,自今年 7 月推出 GPT-Live 以来,ChatGPT 语音使用量接近翻倍,目前几乎所有使用语音功能的用户都已转向新模型。此次调整主要涉及 ChatGPT 的语音产品体验,并非面向全部开发者 API 的强制迁移公告。
12 月 11 日移除旧语音模式选项: 用户届时将无法在 ChatGPT 的语音设置中选择 Advanced 或 Standard,原先使用旧模式的用户将自动切换至 Live Voice。现有历史对话会继续保留。
从轮流对话升级为全双工语音交互: Standard Voice 采用 ASR、LLM、TTS 串联架构,Advanced Voice 虽能原生处理音频,但仍需等待用户说完再回应。GPT-Live 支持边听边说、主动附和、处理打断,并可在前台维持对话的同时将复杂任务交给后台模型。
视频与屏幕共享暂时保留旧技术: OpenAI 明确表示,在 GPT-Live 具备相应能力之前,实时视频和屏幕共享仍由 Advanced Voice 提供支持。官方公告没有宣布 GPT-Live API 或 Realtime API 的统一迁移截止日期。
https://help.openai.com/en/articles/20001638-retiring-advanced-and-standard-voice-in-chatgpt
2、DeepL 发布实时语音翻译模型 Aure:持续跟随说话者语调、情绪与语速变化,已接入 DeepL Voice
德国语言 AI 公司 DeepL 发布实时语音翻译模型 Aure,进一步升级旗下 DeepL Voice 产品的跨语言语音生成能力。此前系统主要根据对话开头的声音样本保留说话者音色,Aure 则能够在翻译过程中持续追踪原始语音的情绪、重音、语速及语调变化,让翻译后的声音更接近说话者当下的表达方式。
从固定音色复现升级为动态韵律跟随: Aure 同时分析源语音与翻译文本,持续提取说话者的声音身份、语调、情绪及表达节奏,使译文语音能够反映强调、迟疑或情绪变化,而不只保留相似音色。
分离语音身份、韵律与语义内容: 模型通过不同训练技术分别建模说话者身份、语音韵律和表达内容,并利用强化学习优化翻译准确率及语音自然度,同时降低背景噪声、回声和口音变化带来的干扰。
已覆盖会议、面对面交流及开发者 API: Aure 自动应用于 DeepL Voice for Online Meetings、DeepL Voice for In-Person Conversations 和 DeepL API for Voice,无需额外配置。首批支持英语、德语、西班牙语、法语、意大利语、日语、葡萄牙语和韩语共 8 种语言,其他语言仍由原有模型提供支持。
https://www.deepl.com/en/press-release/aure-voice-ai-model
3、Avera Labs 开源两套全双工语音方案 Awaken:适配 Qwen3-Omni 与 FunAudioChat,低成本实现实时接话与打断
语音 AI 研究团队 Avera Labs 开源 Awaken Full Duplex 系列,分别基于 Qwen3-Omni-30B-A3B 和 Fun-Audio-Chat-8B,将原本采用轮流对话机制的语音大模型改造成全双工系统。两套方案通过少量对话数据和针对性后训练,让模型能够持续聆听、主动附和、判断接话时机及响应用户打断,同时尽量保留原有模型的知识与推理能力。
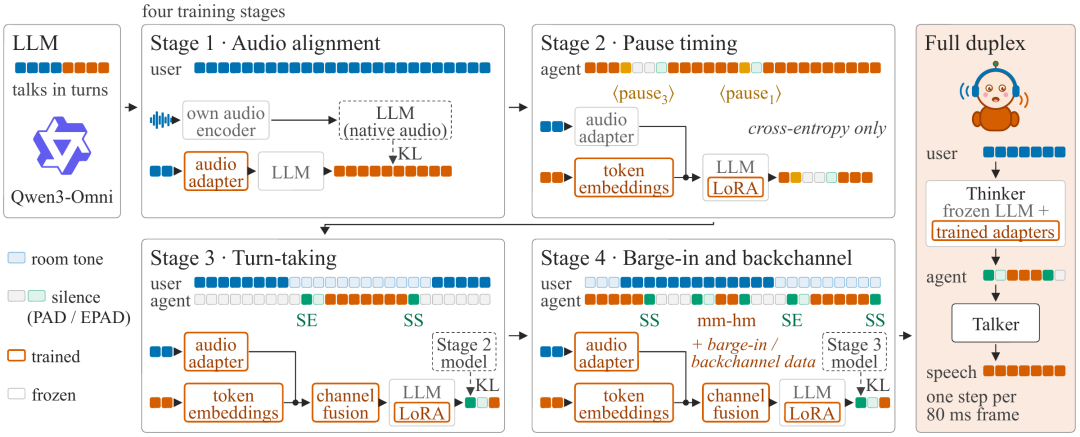
Qwen3-Omni 版本仅训练 9740 万参数: 冻结原有模型主干,训练约 1340 万参数的 LoRA、7550 万参数的音频适配器及通道融合层等组件。采用四阶段训练流程,在单张 NVIDIA B200 上约 30.5 GPU 小时完成交互模型适配;系统每 80ms 处理一帧音频,通过特殊 Token 实现词级轮次控制。
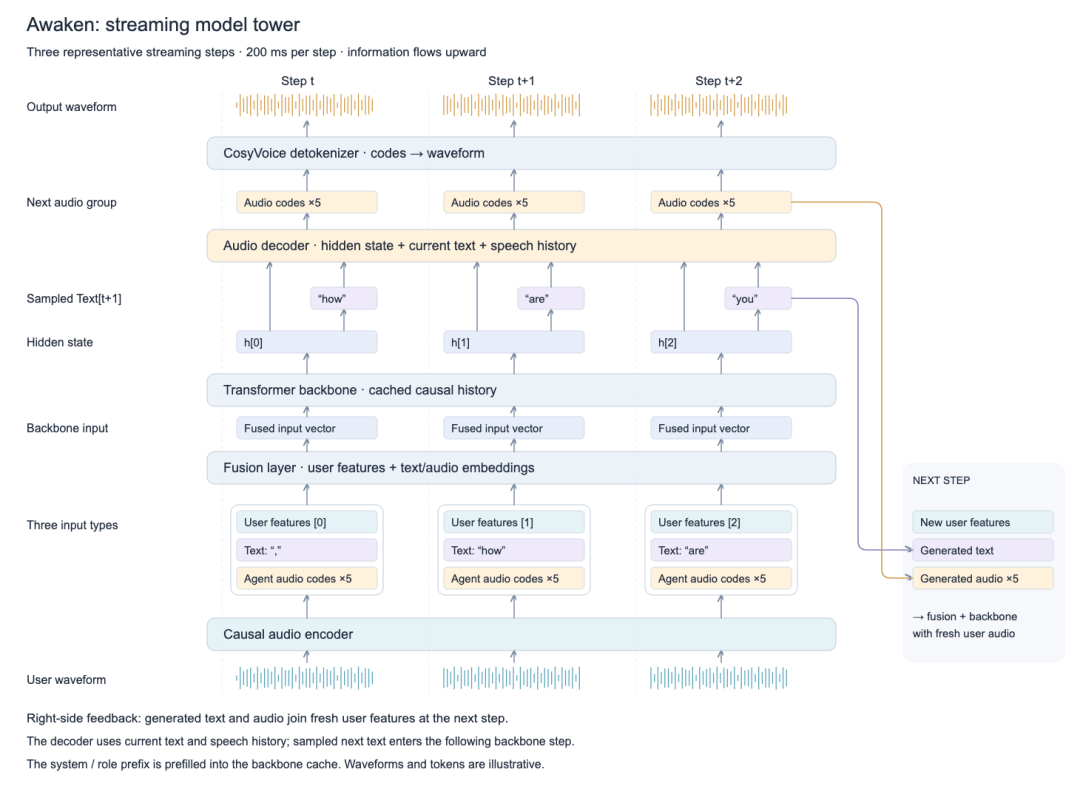
FunAudioChat 版本结合 SFT 与 GRPO: 基于 8B 模型,通过两阶段监督微调及一轮强化学习训练全双工交互能力。团队测试显示,GRPO 将模型在讲述场景中恰当附和且不抢话的成功率从 1% 提升至 63%,主动抢占话语权的比例为 3%。
保留原有模型的语言理解能力: 据团队公开评测,Qwen3-Omni 版本在 Full-Duplex-Bench v1.0 中正常接话成功率为 99.7%;FunAudioChat 版本在长对话事实理解测试中达到 61%,接近原始半双工模型的 66%,语音逻辑题正确率为 90%。
两套模型均提供代码与权重: 项目开放 WebSocket 实时推理服务、浏览器演示及本地部署方式,当前主要支持英语。FunAudioChat 版本代码和权重采用 Apache 2.0 许可证;Qwen3-Omni 版本代码采用 Apache 2.0,模型权重许可证尚未确定。
https://github.com/avera-labs/AwakenFullDuplex-FunAudioChat
https://github.com/avera-labs/AwakenFullDuplex-Qwen3Omni
4、AI 公司 Zyphra 开源端侧 TTS 模型 ZONOS3-Mini:1 亿激活参数,浏览器实时生成语音并支持声音克隆
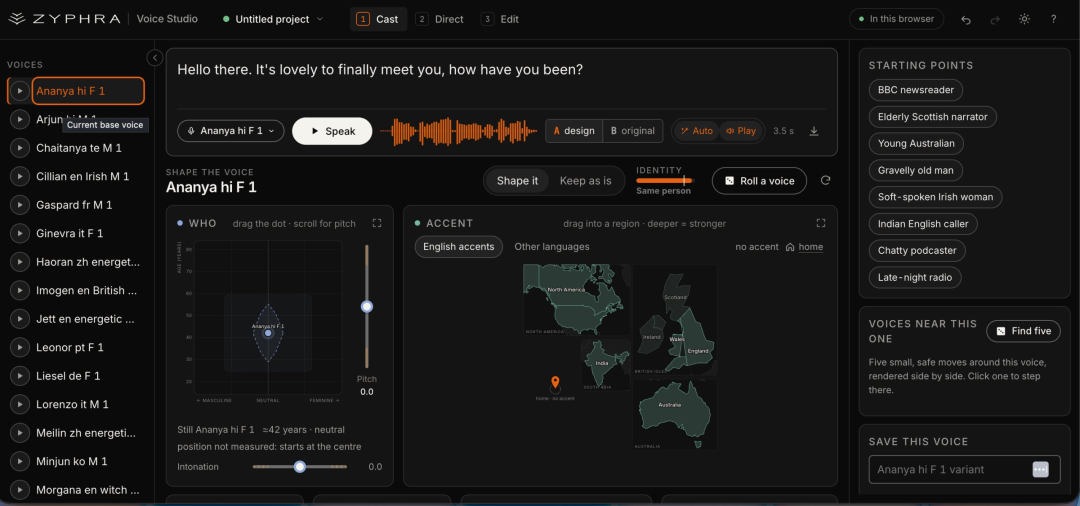
语音 AI 公司 Zyphra 发布并开源 ZONOS3-Mini,一款基于稀疏混合专家(MoE)架构的轻量级语音合成模型。模型总参数量约 8 亿、每次推理激活约 1 亿参数,支持零样本声音克隆、情绪及语速控制,并可通过 WebGPU 直接在浏览器运行,无需持续调用云端 TTS API。
端侧实时生成,首段语音低于 150ms: Zyphra 官方测试显示,模型在 M3 MacBook Air 上的首段语音延迟低于 150ms,在 Pixel 9 浏览器中低于 570ms。团队提供 WebGPU、GGML、SGLang 等推理实现,支持手机、笔记本及服务器部署。
自研音频编码器降低生成成本: 新模型使用 Zyphra Audio Codec 1(ZAC-1)替代此前高帧率音频表示,结合 Gated DeltaNet 与全局注意力的混合架构,提升长文本处理及流式生成效率。模型还通过 DPO 和 GRPO 后训练改善语音稳定性。
支持 43 种语言与细粒度声音控制: 模型可根据参考音频克隆声音,并调整口音、年龄感、音色、情绪和语速;还支持通过注意力对齐控制指定词语的表达方式。模型权重采用 Apache 2.0 许可证开放,同时提供在线体验和云端 API。
https://www.zyphra.com/our-work/zonos3-mini
5、西北工业大学、南京大学等团队开源万小时闽南语语音数据集 WenetSpeech-Min:双文本标注,支持方言 ASR 与 TTS 训练
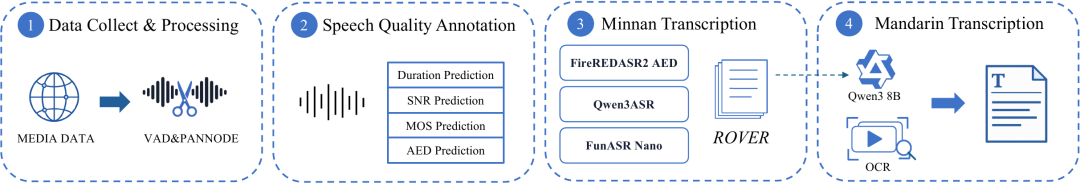
西北工业大学、南京大学、新南威尔士大学、厦门大学、WeNet 开源社区等机构联合发布 WenetSpeech-Min,构建约 1 万小时真实场景闽南语语音数据集。不同于传统语音数据集仅提供单一转写文本,WenetSpeech-Min 为同一段音频同时提供闽南语原文和对应的普通话文本,并开放 ASR、TTS 评测集及训练模型,支持方言识别、普通话转写和闽南语语音合成研究。
约 1 万小时语音配备双文本标注: 数据来自影视剧、有声读物、娱乐节目等网络媒体,采用 VAD、说话人分离及音频质量筛选处理。闽南语文本由多个 ASR 模型生成并融合,普通话文本则结合字幕 OCR 或语言模型转换获得。
建立闽南语 ASR 与 TTS 评测基准: ASR 测试集包含约 6 小时人工核验的双文本数据,可同时评估方言原文识别与普通话文本输出;TTS 测试集包含 750 条语音合成文本,覆盖日常表达、长文本、重复内容和绕口令。
开源模型验证数据训练效果: 在团队公开评测中,基于数据集微调的 Qwen3-ASR 闽南语识别字符错误率达到 17.59%,优于未微调模型的 34.61%。项目已开放语音数据、基准测试及 ASR、TTS 模型,供开发者下载使用。
https://aslp-lab.github.io/WenetSpeech-Min-Repo/
02 有亮点的产品
1、YC F26 语音数据公司 Agentic Data 正式公开:提供真实人类对话数据与音频原生 RL 训练环境
Y Combinator 2026 秋季批次初创公司 The Agentic Data Company 正式对外公开,宣布面向语音 AI 模型开发者提供真实人类对话数据和音频原生强化学习(RL)环境。团队认为,现有语音模型在接话、停顿、情绪表达等方面仍显机械,部分原因在于训练数据以有声读物、播客及合成对话为主,缺少真实交流中的重叠发言、犹豫和自然反馈。
从真实人类交流中采集训练数据: 团队录制熟人之间未经脚本设计的自然对话,保留停顿、打断、附和、情绪和环境声音等信息。公司表示,数据均在获得参与者同意及授权后采集,并向录制者支付报酬。
公开展示千小时双人对话数据集 Open Yap 1K: 数据集包含约 1000 小时英语对话、1602 场交流和 239 名说话者,以 48kHz 双声道独立音轨保存双方声音,并提供词级时间戳。该数据旨在支持全双工语音、语音合成和音频理解训练;目前 Hugging Face 已提供示例数据,完整数据需申请访问。
提出音频原生 RL 训练方向: 公司同步宣布建设面向语音模型的音频原生强化学习环境,希望在真实声音交互中优化模型的回应时机与行为表现。目前尚未公布完整环境的技术实现、训练 API 或性能评测结果。
https://x.com/matiasdrejer/status/2120645243167216065
2、浏览器音乐创作工具 BPMORBIT 开启公开测试:通过轨道式界面混音,支持 MIDI 控制器接入
音乐创作工具 BPMORBIT 宣布开启公开 Beta 测试,尝试以可视化轨道界面替代传统音乐软件中的部分操作方式,让用户直接在浏览器中探索节奏、混音与音乐创作。用户可通过官网登记体验,或联系开发者申请测试资格。产品支持浏览器交互,也提供面向 DJ 控制器的音频与 MIDI 接入方式。
以轨道式界面呈现音乐创作: BPMORBIT 将双轨混音与节奏控制整合到可视化界面,支持触发循环片段和导入音乐,让用户通过直观的图形交互探索不同的声音组合。
支持 DJ 控制器与浏览器协同: 项目展示了 Pioneer DDJ-FLX4 的接入流程,可通过 MIDI 传输推子、均衡器等控制信息。音频信号需要另行导入,macOS 可通过 BlackHole 等虚拟音频设备完成路由。
公开 Beta 已启动: 用户可在官网注册或联系开发者申请参与。当前尚未公布正式版发布时间,也没有足够公开信息表明其集成了 AI 音乐生成模型。
https://bpmorbit.com/
3、独立开发者 Joe Hu 分享 AI 口语教练 Joe Speaking 开发实践:结合 Gemini Live 与 GPT-Live 模拟雅思口语考官
独立开发者 Joe Hu 分享 AI 英语口语练习产品 Joe Speaking 的开发经历。产品面向 IELTS 和 CELPIP 考试,通过实时语音模型模拟口语考官,让用户完成模拟考试、获得评分反馈并追踪长期练习记录。Joe Speaking 此前已于 10 月推出 1.0 正式版,本次分享主要围绕从个人学习需求出发构建语音产品的过程及技术选型。
结合两套实时语音模型提供考试体验: Joe Speaking 使用 Gemini Live 支持常规模拟考试,并在 Advanced Examiner 模式中接入 OpenAI GPT-Live,让 AI 考官能够持续聆听用户回答、处理停顿和追问,模拟真实口语考试中的互动节奏。
通过 WebRTC 连接 GPT-Live: 在进阶考试中,浏览器直接与 OpenAI 建立 WebRTC 音频连接,应用服务器负责初始化会话,不中转实时麦克风音频。考试结束后,系统利用保存的音频和转写内容进行评分,并提供分项反馈。
围绕练习记录构建长期反馈: 产品支持雅思与思培题库、录音练习、转写纠错、评分和历史表现分析,并通过 MCP 让 ChatGPT、Claude 等 AI 助手读取用户授权的练习记录。开发者此前已公开介绍其从 2024 年制作 IELTS Speaking Simulator GPT,到 2026 年逐步构建独立产品的经历。
https://x.com/hubeiqiao/status/2120535902447427903
4、语音 AI 公司 Modulate 获 Twilio Ventures 投资:通话中识别 AI 合成语音缩短至 1.6 秒,准确率超 99.1%
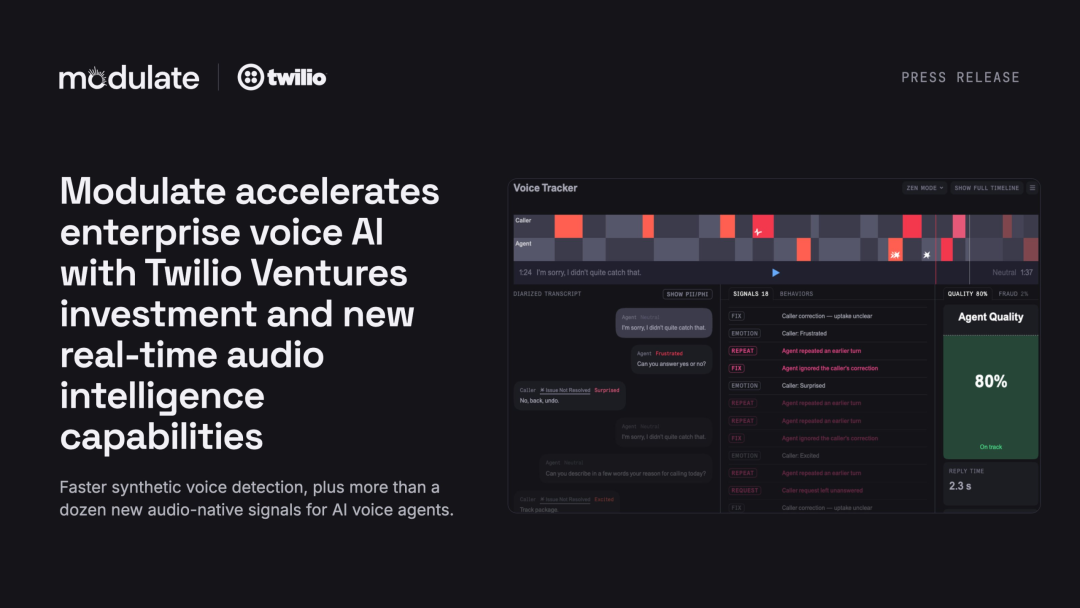
音频智能公司 Modulate 宣布获得 Twilio Ventures 及 Kayak 联合创始人 Paul English 的新增投资,并升级旗下实时音频分析平台 Velma。新模型能够在电话仍在进行时判断对方是否使用 AI 合成语音,识别时间中位数由 2.25 秒缩短至 1.6 秒,同时扩展语音 Agent 质量监测能力,帮助企业识别合成来电、分析通话行为和处理潜在风险。
合成语音识别时间缩短至 1.6 秒: 据公司公布的测试结果,Velma 在真实 AI 与人类通话样本上的检测准确率超过 99.1%,中位识别时间较此前缩短约 29%。系统通过分析音频本身进行检测,无需依赖语音生成服务商提供的水印,也将 Speech-to-Speech 和全双工模型纳入检测范围。
新增十余项语音 Agent 监测指标: Velma 基于包含 100 余个专用音频模型的 Ensemble Listening Model 架构,分析语气、情绪、停顿与对话行为。此次新增响应时机、音频质量、对话理解错误等监测信号,帮助企业发现仅依赖转写文本难以识别的问题。
开放流式检测与通话风险分析 API: 开发者可通过 WebSocket 持续提交实时音频,获取按时间片输出的合成语音判断及置信度,也能结合 Velma Triage 分析欺诈、冒充及其他通话行为。新增投资金额尚未披露,此前 Modulate 于 9 月完成 2500 万美元融资。
https://www.modulate.ai/press-releases/modulate-accelerates-enterprise-voice-ai-with-twilio-ventures-investment
03 有态度的观点
1、Omdia 研究总监:预计 6G 于 2029 年商用,普及速度将慢于 5G
Omdia 电信数据战略研究总监威廉·汤普森-黑尔11 月 11 日撰文指出,首批 6G 服务将在 2029 年于中国、美国等市场推出,初期覆盖将集中在人口密集的大城市。
他判断,运营商初期可能让 5G 与 6G 共用现有频谱,先在局部区域上线。他预计,到 2031 年,全球 6G 订阅量约为 4.24 亿,占移动订阅的约 2.8%。他把中国列为早期最大市场,预计同年在中国出货的智能手机约有 45% 支持 6G。汤普森-黑尔认为,智能手机已经相当普及,换机周期也在拉长,加上 6G 终端初期成本较高,现有 4G 和 5G 又能满足多数日常用途,单凭连接升级很难推动用户提前换机。
汤普森-黑尔建议运营商把投资重点放在物联网、物理 AI 和通感一体等具体场景。他举出的例子包括超视距无人机作业、智能交通管理和实时环境监测。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考