小米开源空间音频模型 MiDashengLM-Spatial,新增双耳声源定位与运动轨迹推理丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、小米开源空间音频理解大模型 MiDashengLM-Spatial:新增双耳声源定位与运动轨迹推理,空间理解准确率从 44.3% 提升至 70.3%
Prompt: Which direction are the two boys in <A>: left side <B>: right side <C>: directly ahead
Ground Truth: B: right side
MiDashengLM-Spatial: B: right side
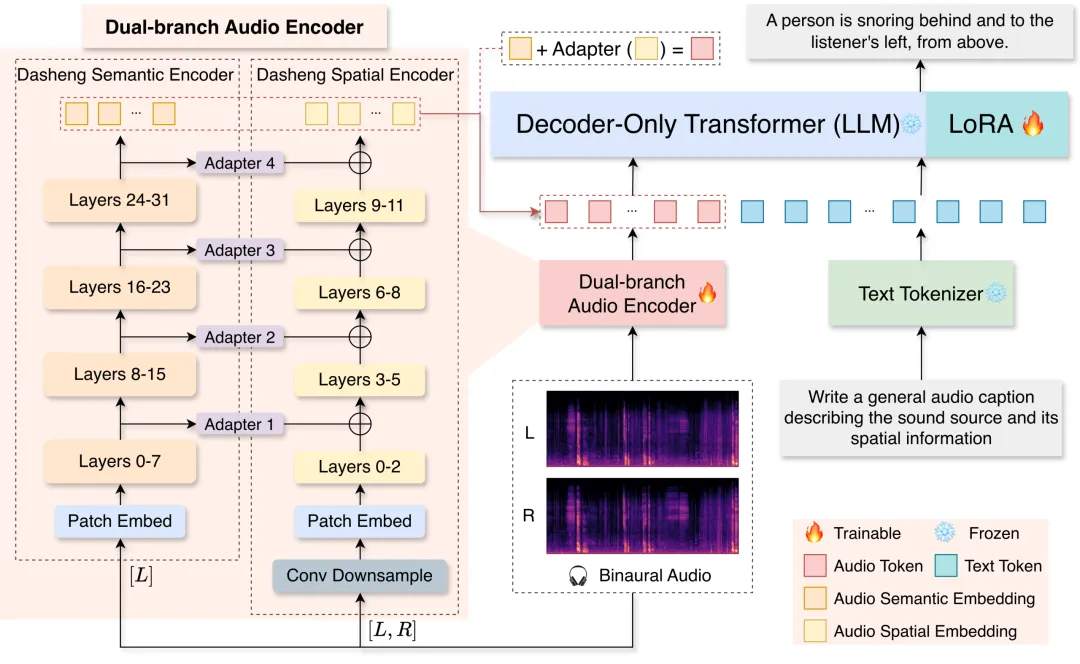
小米声音大模型团队正式发布并开源 MiDashengLM-Spatial,在原有 MiDashengLM-7B 声音理解模型基础上,新增双耳空间音频感知能力,使模型能够同时理解声音内容、声源方向、距离及运动轨迹,并推理多个声源之间的空间关系。根据团队公布的测试结果,在 STAR-Bench 空间推理任务中,模型准确率从原版的 44.3% 提升至 70.3%,同时保持原有的语音识别、音频问答和声音描述能力。
双分支音频编码器,分别提取语义与空间信息: MiDashengLM-Spatial 保留原有的 0.6B 参数 Dasheng-Huge 语义编码器,并新增基于 86M 参数 Dasheng-Base 构建的空间编码器 Spatial-Dasheng。两条分支通过分层语义到空间特征注入机制连接,将声音内容特征逐层传递给空间分支,使模型能够区分重叠的多个声源,并判断各自的位置和运动状态,同时避免破坏原有语义理解能力。
合成约 1.3 万小时空间音频训练数据: 团队利用头相关传递函数(HRTF)和虚源法模拟不同室内声学环境,构建 100 万段双耳音频场景、约 1.3 万小时音频及 600 万组空间问答数据。训练数据包含语音、环境声和音乐等多种声音,并记录各声源的位置、运动轨迹及时间关系,让模型学习声音内容与三维空间信息之间的关联。
空间推理准确率达到 70.3%,通过左右声道交换验证: 在 STAR-Bench 空间推理测试中,MiDashengLM-Spatial 准确率达到 70.3%,高于原版 MiDashengLM 的 44.3%、Qwen3-Omni 的 44.7% 和 MOSS-Audio 的 41.7%。团队还设计了左右声道交换测试,要求模型在声源位置反转后同步改变判断。新模型在这一测试中的全正确率达到 72.6%,原版模型为 0%,证明模型能够利用真实的双耳声学线索进行空间判断。
空间感知增强,同时保留通用音频理解能力: 在 MMAU-Pro 的空间理解任务中,新模型准确率从原版的 18.2% 提升至 55.4%。在音频问答、语音识别和声音描述等通用任务中,整体表现与原版基本持平,部分测试有所提升。不过,研究也指出,模型对精细运动轨迹及多个重叠声源的复杂空间关系仍存在理解局限。
目前 MiDashengLM-Spatial 已完整开放模型权重、推理代码和评估代码,采用 Apache 2.0 许可证,支持研究和商业使用。小米表示,后续将逐步探索其在智能家居、汽车座舱和机器人等场景中的应用。
https://jinbo-hu.github.io/midashenglm-spatial-demo/
2、伊利诺伊大学、卡内基梅隆大学等团队研究世界模型的物理交互能力:训练 3 万小时第一人称视频,仍难准确预测物体运动
伊利诺伊大学厄巴纳-香槟分校、卡内基梅隆大学、约翰斯·霍普金斯大学和丰田研究院的研究团队发表论文 《What 30,000 Hours of Ego-centric Video Does Not Teach》,系统研究扩大第一人称视频训练数据规模,对世界模型理解真实物理交互的影响。研究发现,即使训练数据从 300 小时增加至 3 万小时,模型已经能够较准确地预测人手运动,却仍难以模拟手与物体接触后产生的变化。将模型参数扩大 4 倍,也未能显著缩小这一差距。
使用 3 万小时第一人称视频研究世界模型的扩展规律: 团队构建了包含 115 万段视频、约 3.24B 帧画面的数据集,覆盖 1.4 万余名参与者和 3.2 万余种操作任务。研究基于 NVIDIA Cosmos 3 的 4B、16B 和 64B 模型,输入初始画面与人手运动信息,预测后续 16 帧视频,并分别评估人手运动和物体运动的预测准确度。
人手运动预测接近饱和,物体交互仍存在明显误差: 在结构一致性(SCS)评测中,经过 3 万小时训练的模型,人手运动得分约为 0.785,物体运动得分仅为 0.527。即使模型可以准确预测手伸向哪里,仍可能错误生成纸张折叠、物体抓取或工具移动的结果。训练数据增加 100 倍后,物体运动得分仅提高约 0.09;将模型扩大 4 倍,物体预测能力的拟合上限也仅提高 0.034。
引入人体骨架条件,减少约 50 倍训练数据需求: 研究将手部和身体的三维关键点投影到视频画面中,作为额外条件输入模型。借助这一设计,模型仅使用 300 小时数据,便能达到普通模型使用约 1.5 万小时数据时的人手运动预测水平。不过,物体运动的预测准确度仍明显落后。
调整训练监督方式,改善物体接触与运动预测: 团队进一步提出面向物体的自适应噪声调度方法,对运动幅度较大、存在交互行为的区域施加更强训练约束,迫使模型学习物体的动态变化。在 3 万小时训练条件下,物体结构一致性得分从 0.527 提升至 0.546。在模拟人形机器人任务中,该方法也改善了模型对任务成功与失败结果的预测能力。
目前研究已开放论文、项目主页与可视化实验结果,代码和评测基准尚未正式开放。研究指出,世界模型仍难以准确理解接触力、摩擦、物体刚度及遮挡后的状态变化,仅依靠增加训练视频和模型规模,尚不足以解决复杂物理交互预测问题。
https://fidelity-gap.github.io/
3、阿里 Qwen Audio 团队开源语音增强模型 FLASepformer 与 JAEC:语音分离提速最高 2.29 倍,回声消除算法延迟仅 22ms
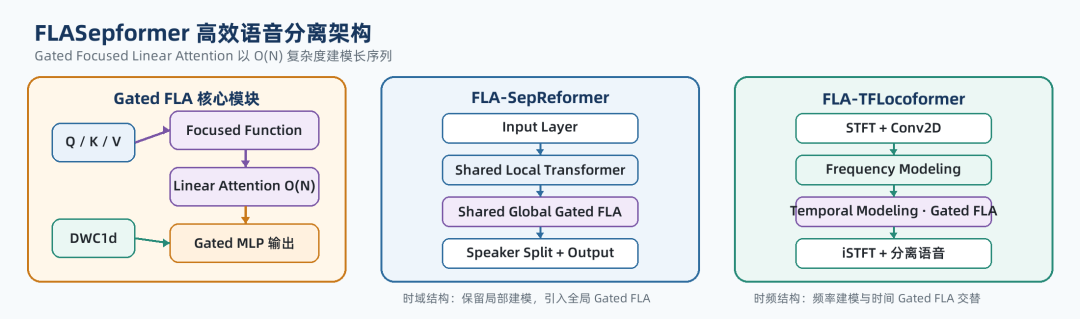
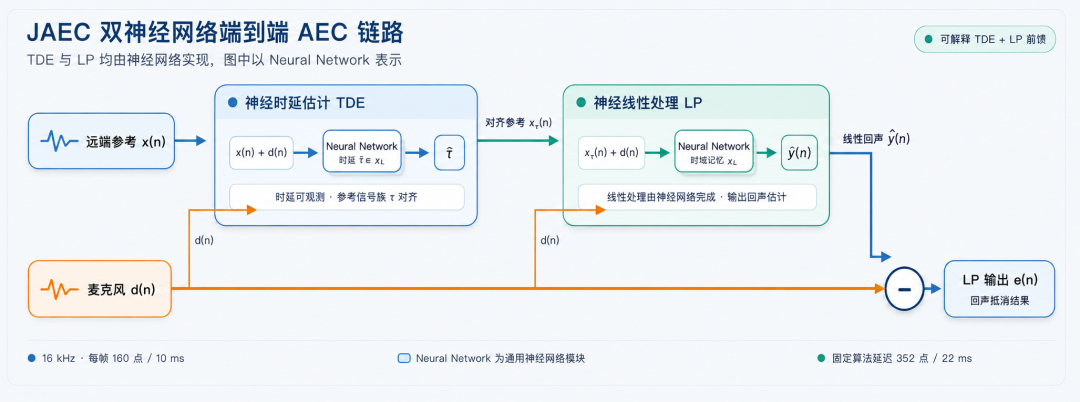
阿里巴巴通义实验室 Qwen Audio 团队在 ModelScope 开放两款语音处理模型:FLASepformer 面向多人语音重叠场景,通过线性注意力降低长音频分离的计算开销;JAEC 面向实时通话中的声学回声消除,通过神经网络实现时延估计和线性回声抵消。结合此前开放的 ZipEnhancer、FRCRN 等降噪模型,阿里进一步完善了覆盖语音分离、降噪和回声消除的开源语音处理工具链。
FLASepformer 语音分离速度提升最高 2.29 倍: 模型引入门控聚焦线性注意力(Gated Focused Linear Attention),将传统 Transformer 注意力的计算复杂度从 O(N²) 降至 O(N),并通过门控机制改善长序列语音特征提取。在 NVIDIA RTX A800 上处理 30 秒混合音频时,FLA-SepReformer 的 T/B/L 三种规格推理速度分别达到对应基线的 2.29 倍、1.91 倍和 1.49 倍,显存占用分别降至原来的 15.8%、20.9% 和 31.9%,同时保持具有竞争力的语音分离质量。
JAEC 实现 22ms 低延迟回声消除: JAEC 采用可解释的端到端神经网络架构,将时延估计(TDE)与线性处理(LP)结合。前者估计扬声器参考信号与麦克风信号之间的时间差,后者预测并抵消线性回声。当前开放的 16kHz 版本每次处理 10ms 音频,固定算法延迟为 22ms,可用于实时语音通话和会议音频前端。不过,目前版本仅包含 TDE 和 LP,尚未集成非线性残余回声抑制模块。
开放权重与推理接口,可接入语音识别和数据处理流程: FLASepformer 已提供基于 Libri2Mix 训练的 8kHz 双人语音分离模型,能够将单通道混合语音拆分为两路独立音频,并支持 ONNX 导出;JAEC 则提供 ModelScope 推理接口。开发者可以将这些模型接入 ASR、说话人标注和语音数据清洗流程,减少重叠人声、设备回声等干扰对后续识别与处理的影响。
目前 FLASepformer 的公开模型主要支持 8kHz、双说话人、非流式分离,采用 CC BY-NC 4.0 许可证,仅限非商业用途;JAEC 采用 Apache 2.0 许可证。FLASepformer 的相关研究此前已发表于 Interspeech 2025,此次开放的重点是可下载的模型权重与推理资源。
https://doi.org/10.21437/Interspeech.2025-1315
4、xAI 发布实时语音模型 Grok Voice 3.0:客服任务完成率从 56.5% 提升至 71.6%,首音频延迟仅 0.81 秒
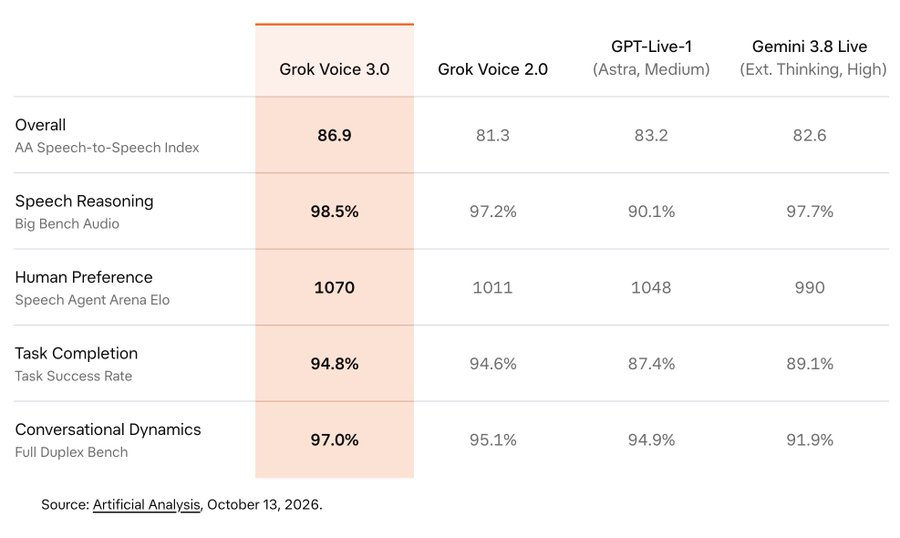
xAI 正式发布新一代实时语音对话模型 Grok Voice 3.0,重点提升语音推理、工具调用及复杂客服任务处理能力,同时保持低延迟响应。在 Artificial Analysis 的 Speech-to-Speech 综合评测中,新模型得分从上一代的 81.3 提升至 86.9,排名第一。模型已通过 Voice Agent API 开放,价格与上一代保持一致。
客服任务完成率从 56.5% 提升至 71.6%: 在 Artificial Analysis 的 τ-Voice 基准测试中,Grok Voice 3.0 的任务完成率达到 71.6%,较上一代提升 15.1 个百分点。该测试模拟航空、零售、电信等行业的客服通话,要求语音智能体在不同口音、背景噪声及用户打断的情况下,遵循业务规则并调用工具完成实际操作。在 ServiceNow 的 EVA-Bench 企业语音智能体评测中,模型准确率达到 74%,并在结合准确率与客户体验的综合评估中取得最佳表现。
全双工交互得分达 97%,首音频延迟低于 1 秒: Grok Voice 3.0 在 Full Duplex Bench 中取得 97.0% 的成绩,高于上一代的 95.1%,能够更准确地处理用户停顿、轮次切换、插话和简短附和。在 Artificial Analysis 测试中,模型首音频响应时间为 0.81 秒,相比 GPT-Live-1(Astra)的 1.34 秒低约 40%。语音推理准确率达到 98.5%,高于上一代的 97.2%。
已用于特斯拉与 Starlink 的实际语音服务: xAI 表示,Grok Voice 3.0 每天在特斯拉汽车中处理数百万次语音对话,支持驾驶员通过语音查询日历、回复邮件,以及调用 Grok Bot 完成订餐和预订等任务。在 Starlink 客服中心,Grok Voice 每天处理约 2 万通客户电话,其中约 70% 无需人工介入即可解决,并支持身份验证、硬件故障排查、账户补偿和设备更换等操作。上述业务数据由 xAI 披露。
API 定价维持每分钟 0.08 美元: Grok Voice 3.0 已通过 xAI Voice Agent API 正式开放,价格为 0.08 美元/分钟,与 Grok Voice 2.0 相同。此前使用
grok-voice-latest的开发者已自动切换至新版本,无需修改现有代码。根据 Artificial Analysis 的语音推理任务测试,新模型的平均执行成本低于 GPT-Live-1(Astra)及 GPT-Realtime-2.1。
https://x.ai/news/grok-voice-3
02 有亮点的产品
1、企业 AI 视频平台 Clueso 完成 1000 万美元 A 轮融资:智能体可自动录屏、生成配音,并随产品更新重制视频
企业 AI 视频制作平台 Clueso 宣布完成 1000 万美元 A 轮融资,由 Dharana Capital 领投,累计融资达到 1200 万美元。Clueso 正在构建面向企业的视频制作智能体,能够根据产品操作流程、文档或文字指令,自动完成屏幕录制、脚本编写、AI 配音、字幕及视频剪辑,并在产品更新后自动维护视频内容。目前已有超过 1000 家企业使用该平台,包括 Atlassian、GitLab、Samsara 和 Zendesk 等。
从文字指令到完整视频,自动执行软件操作: 用户可以描述希望展示的产品功能,Clueso 智能体便会进入实际软件界面,自动点击、操作并录制完整流程,再生成讲解脚本、AI 配音、动画、字幕和背景音乐。平台还支持将已有屏幕录制、产品文档或演示文稿转换为产品教程、营销视频和培训内容。
产品更新后自动重录,保持视频内容同步: Clueso 智能体能够检查产品版本变化,识别现有视频中需要修改的内容,重新执行对应的软件操作并录制受影响片段,无需整条视频从头制作。平台还支持按企业品牌规范统一配音、视觉风格和字幕,并通过多语言界面录制生成本地化教程。
通过 MCP 接入 AI 开发工具: Clueso 已提供 MCP 接口,支持 Claude、ChatGPT、Cursor 等 AI 工具调用视频创建、编辑和管理能力。开发者可以在现有工作流中通过自然语言发起视频制作任务,而无需单独完成录制与剪辑流程。
企业反馈视频制作效率提升超过 5 倍: Clueso 表示,使用该平台的部分团队反馈,视频制作效率提升超过 5 倍,制作成本降低约 80%。这些数据来自客户反馈,尚非独立评测。Atlassian 已将其用于客户学习视频制作,Zendesk 则用于内部培训及客户教育内容。
本轮融资将用于扩展企业市场、增强视频制作智能体及编辑能力,并进一步连接企业已有的产品知识和业务系统。
https://x.com/realAkashAnand/status/2110007145639072128
2、企业 AI 通讯平台 Zenzap 累计融资 4400 万美元:支持语音转写与群聊智能体,已创建超 4 万条自动化工作流
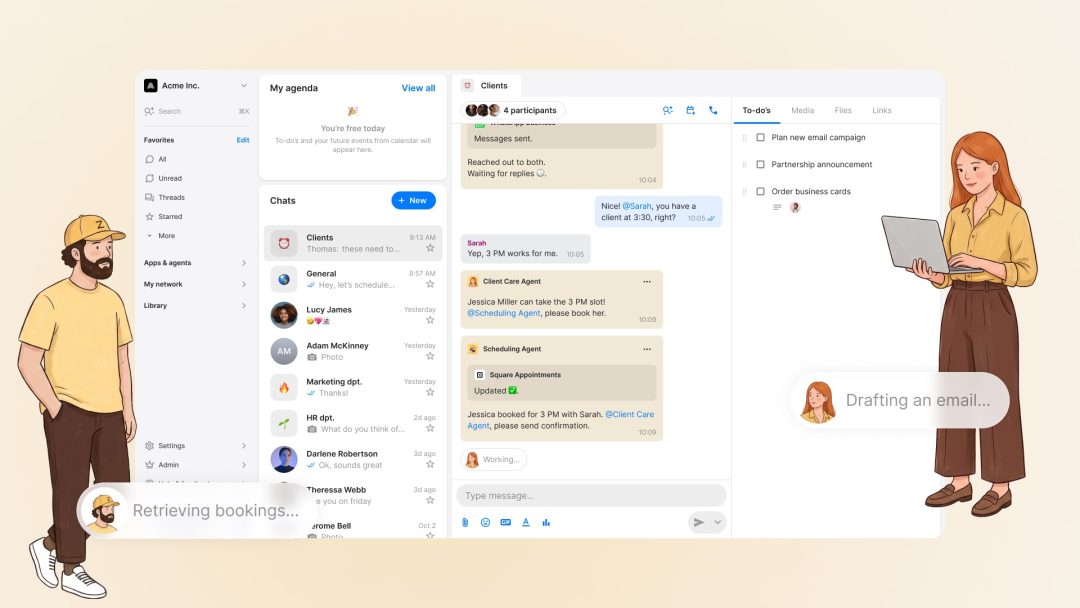
企业 AI 通讯平台 Zenzap 宣布正式面向公众推出,累计获得 4400 万美元融资,投资方包括 Bessemer Venture Partners、Lightspeed Venture Partners 和 The Garage。其中,3300 万美元来自 A 轮融资,另有 1100 万美元种子轮融资。Zenzap 希望替代企业员工日常使用的 WhatsApp 等个人通讯工具,将语音消息、视频通话、任务管理与 AI 智能体整合到同一工作平台,面向餐饮、零售、医疗和建筑等移动办公场景。
支持 AI 语音交互、语音消息与通话转写: Zenzap 提供 AI 语音聊天、语音消息转写和通话录音转写功能,员工可以通过文字或语音消息向智能体下达任务。平台还支持语音及视频通话,并利用 AI 搜索工作区消息、提取信息和创建待办任务。语音转写及相关智能体能力采用积分计费机制。
智能体直接进入工作群聊,已创建超 4 万条自动化工作流: Zenzap 允许员工在群聊中创建和调用 AI 智能体,连接超过 400 款企业应用,执行日程安排、邮件处理、CRM 更新、发票跟踪和工单分配等操作。官方称,员工无需编程即可在 90 秒内创建智能体,现有客户已累计建立超过 4 万条自动化工作流。团队成员可以在同一对话中与智能体协作,查看执行结果并审批关键操作。
面向非技术岗位,提供企业级权限控制: 平台采用类似 WhatsApp 的移动端聊天界面,同时提供企业管理、数据访问权限和审计能力。每个智能体在独立环境中运行,敏感操作需经过人工审批。Zenzap 表示,已有 FedEx、Starbucks、Taco Bell 等企业的团队使用其产品进行员工沟通和工作协调。
目前 Zenzap 已正式提供商业服务,拥有免费版本及付费订阅方案。此次融资消息于 10 月 14 日公布,但其 3300 万美元 A 轮实际上已于 2025 年 8 月完成。
https://www.zenzap.co/pricing/
3、AI 音效生成公司 Mirelo 发布视频音效模型 SFX 2.0:保留对白并替换背景音乐,支持最长 10 分钟跨镜头音效生成
AI 音频生成公司 Mirelo 正式发布视频音效生成模型 Mirelo SFX 2.0,能够在保留原有视频画面与人物对白的同时,移除不需要的背景音乐,重新生成与画面动作同步的音效和环境声。相比此前主要面向短片段的音效生成能力,新版本支持对最长 10 分钟的完整视频进行一次性声音设计,使多个镜头之间的环境声音保持连续,无需逐段生成和手动拼接。
保留人物对白,重新生成音效与环境声: SFX 2.0 能够识别并保留视频中已有的人物对白,移除原有背景音乐及其他非对白声音,再根据画面重新生成脚步声、碰撞声、环境声等音效。模型还会根据对白自动调整背景音量,避免音效遮盖人声。用户可以直接修改 AI 生成视频的声音,无需重新生成画面。
支持最长 10 分钟的视频,保持跨镜头声音一致: 模型以完整剪辑视频为输入,结合画面中的动作、时间关系和环境信息生成连续音轨,避免多个独立生成的片段在拼接时出现背景声突变。例如,同一场景从远景切换到特写时,环境声和物体音效仍能保持连贯。Mirelo Studio 和 API 已支持最长 10 分钟的视频,企业用户可申请处理更长内容。
盲听测试中,81% 的结果优于 Sony Woosh: Mirelo 在官方盲听测试中,将 SFX 2.0 与其他视频音效模型及视频生成模型的原生音频进行比较。在与 Sony Woosh 的对比中,81% 的评价更偏好 SFX 2.0;与 Kling Foley 对比时,该比例为 63%。在 Seedance 2.5 生成的视频中,SFX 2.0 的音效有 72% 的评价达到或优于原生音频。每组比较涉及 30 段视频、25 名听众,结果来自 Mirelo 自行组织的测试。
已开放 API,并接入 Runway、fal: SFX 2.0 已在 Mirelo Editor、Playground、API 和 MCP 中上线,同时接入 Runway 与 fal。开发者可通过视频转音频、视频转视频接口生成音效,也可使用文本提示和排除提示控制生成内容。产品还提供文本转音效版本,支持单独生成指定声音的分轨版本仍在开发中。
https://mirelo.ai/blog/mirelo-sfx-2-0
03 有态度的观点
1、田柯宇自述停掉同事训练任务,前团队成员公开质疑
前字节跳动实习生田柯宇在《elsewhere 别处发生》访谈中,首次较完整地讲述自己干扰模型训练的经过。随着节目公开,前团队成员发布长文反驳,围绕行为动机、持续时间和影响范围提出另一套说法。访谈文字版于 10 月 12 日发布,制作方说明,采访录制于今年 7 月。
田柯宇称,当时一名实习生占用过多算力并停掉他人任务,向负责人反馈未果后,自己让 GPT 编写程序,在约 10 天内手动停止或卡住对方的训练任务约 5 次。他承认违反公司规定、浪费公司资源,但否认持续攻击训练集群及嫁祸他人的说法。据界面新闻和鞭牛士报道,前同事公开的说明材料认为,这一自述与当年的项目异常及技术记录存在出入,并提醒投资人与合作方向知情者核实。
材料还提出有关模型演示真实性的指控。田柯宇与前同事的这些表述属于相互冲突的当事人说法;访谈中,他表示相关民事案件仍在二审。
( @APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
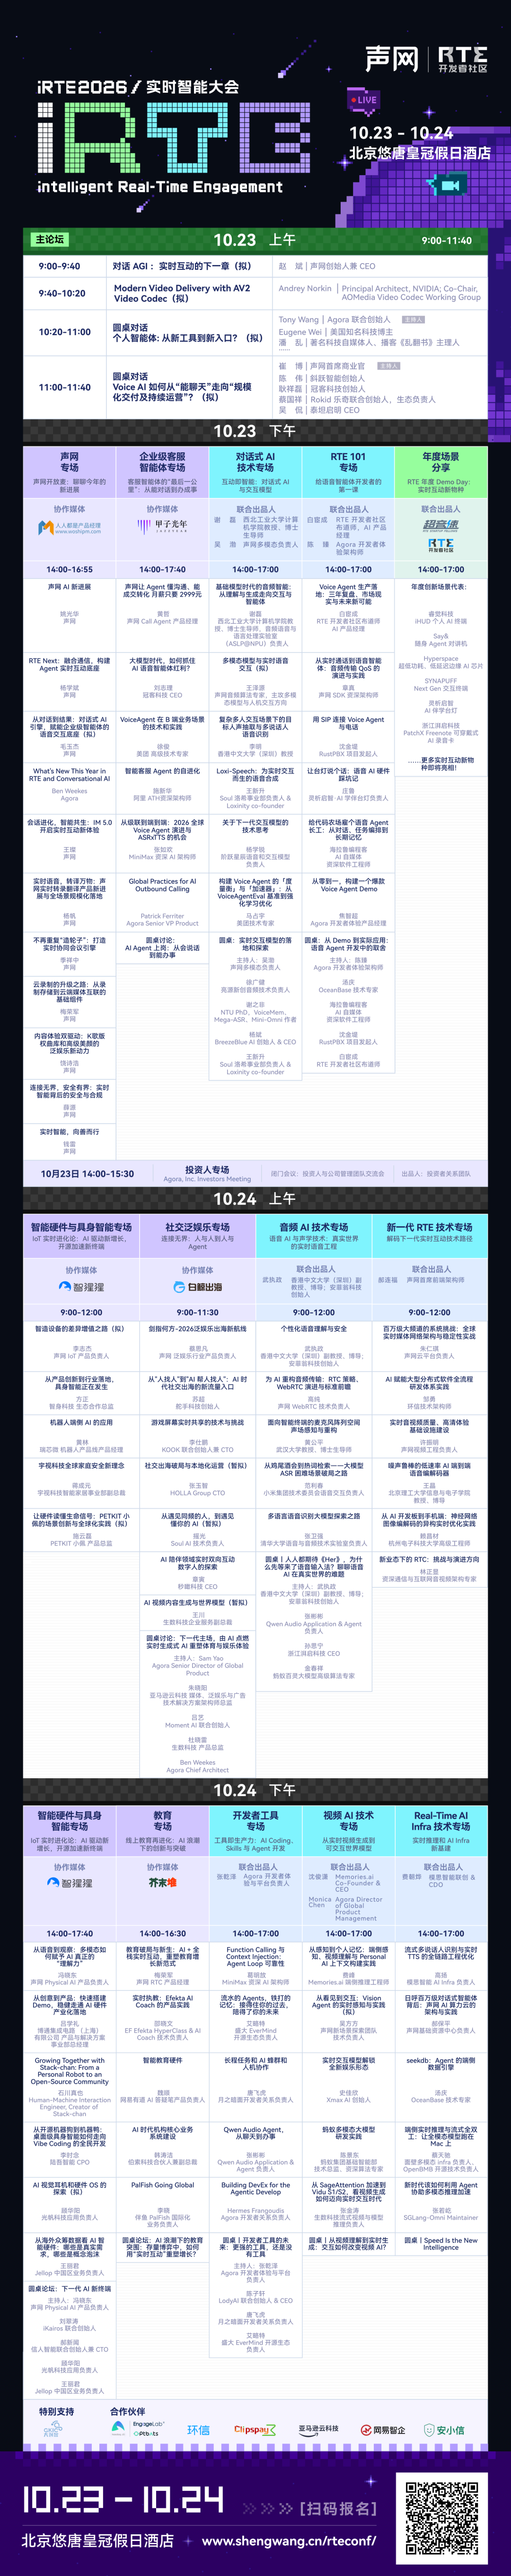
1、如果今年只参加一场实时交互模型和 Voice Agent 大会,来 iRTE2026 实时智能大会就够了
在这里,Kimi、MiniMax、阶跃星辰、面壁智能、模思智能、生数科技等国内领先大模型公司将带来最前沿的 AI 产品 / 技术分享,话题覆盖多模态模型、Voice Agent、AI 硬件、具身智能、实时基础设施等。
还有美团、阿里 ATH、Rokid、斜跃智能、博通集成、Soul、HOLLA、EF 英孚、伴鱼等企业分享 Voice Agent 在客服、硬件、具身智能、社交、教育等行业场景的落地。现场更有丰富的开发者工作坊,手搓各类 Voice Agent 应用与硬件。
10 月 23-24 日,来 iRTE 大会现场,与国内外一线的 AI 产品 / 技术专家深度交流,掌握 RTE、Voice Agent、实时多模态的最新动向与技术实践,把握 2026 Voice Agent 技术风向标。欢迎关注公众号和添加小助手微信 Creators2022 进大会交流群获取直播提醒。
大会官网:shengwang.cn/rteconf
大会全议程如下:
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考