OpenAI 发布 GPT-Live-1.1:新增 13 种音色,提升多语言口音与任务委派能力丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、OpenAI 发布实时语音模型 GPT-Live-1.1:新增 13 种音色,提升多语言口音与任务委派能力
OpenAI 发布新一代实时语音模型 GPT-Live-1.1 及其轻量版本 GPT-Live-1.1 Quip,重点改善多语言语音表现、对话自然度和任务委派能力。此次更新新增 13 种语音音色,覆盖法语、德语、印地语、墨西哥西班牙语、韩语、日语及英语,并减少语音助手在搜索、处理任务时反复使用「Checking…」等固定提示语的情况。新模型已开始向 ChatGPT、Codex 和 Dots 用户推送。
新增 13 种音色,改善非英语语音表现: GPT-Live-1.1 为法语、德语、印地语、日语、韩语和墨西哥西班牙语分别新增两种音色,并加入英语音色 Bubbie。OpenAI 表示,新模型显著改善了上述语言及其他非英语语言的口音自然度,减少不同语言之间的口音混杂。具体可用音色因地区和账户而异。
任务委派更加自然,减少重复的状态播报: 新模型增强了任务委派(Delegation)和指令可控性(Steerability),能够更自然地将复杂任务交给其他模型或工具处理。语音助手在执行搜索时,也会使用更丰富的简短提示语反馈进度,减少反复播报「Checking…」的情况。OpenAI 同时发布了 GPT-Live 与 Decisions API 的集成文档,开发者可让语音模型直接调用 Decisions 进行低延迟决策,省去由应用接收委派请求、再转发给决策服务的一次往返。
延续全双工交互,提供标准与轻量两个版本: GPT-Live-1.1 和 GPT-Live-1.1 Quip 分别接替 GPT-Live-1 与 GPT-Live-1 mini,继续支持连续收听、自然轮次切换以及用户中途打断。根据 OpenAI 系统卡,GPT-Live-1.1 成为 Plus 及更高订阅级别用户的默认语音模型,其他用户默认使用轻量版 Quip。
目前 GPT-Live-1.1 已开始向所有用户逐步推出,覆盖 ChatGPT Voice、Codex 和 Dots。API 版本尚未开放,OpenAI 表示即将推出,但尚未公布具体日期、价格及新版性能基准数据。
https://x.com/OpenAI/status/2110797830361436604
2、OpenAI 为 GPT-Live 接入原生 Decisions API:语音对话中可持续触发决策,无需等待用户说完
OpenAI 更新 GPT-Live 与 Decisions API 集成指南,新增原生决策委派(Native Delegation)与实时转写触发机制。开发者可以让语音智能体在持续收听用户讲话、或自身正在说话时,调用 Decisions API 判断意图、选择操作及生成结构化决策结果,无需等待完整对话轮次结束。OpenAI 开发者介绍,这套机制可按约 200 毫秒的间隔触发决策,用于驱动数字人表情、手势和实时交互控制。
原生委派减少一次应用服务往返: 此前使用自定义委派时,GPT-Live 需要先向开发者应用发送请求,再由应用调用 Decisions API。新增原生集成后,GPT-Live 可以直接调用 Decisions API,减少中间转发环节。开发者仍可在应用侧根据决策结果执行实际操作,例如调节汽车空调、开启除雾器或调用其他业务服务。
监听实时转写增量,在说话过程中连续判断: 开发者可在
session.triggers中配置输入与输出转写事件,分别响应用户讲话和 AI 回复过程中不断产生的文本增量。例如,数字人听到用户说「我拿到工作了」,可以立即判断情绪并微笑、点头;当 AI 回复祝贺时,又可以根据自身正在说出的内容调整表情和动作。官方文档提供了情绪、强度、手势三类结构化决策示例。支持会话中动态更新决策问题: 开发者可以通过
session.update修改当前语音会话需要判断的问题,并在配置生效后继续触发新决策。例如,根据用户的对话进展,动态调整意图分类、状态判断或交互动作选项。转写触发器与任务委派相互独立,开发者可同时使用两种机制。
该能力已纳入 OpenAI 官方开发文档,适用于 GPT-Live 与 Decisions API 的集成。200 毫秒指可采用的高频决策触发间隔,并非每次决策都能在 200 毫秒内完成;实际响应仍受到转写更新频率、决策服务延迟与应用执行时间影响。此外,“原生委派”是服务间直接调用,并不意味着模型在终端设备离线运行。
https://developers.openai.com/api/docs/guides/decisions-voice
3、蚂蚁集团联合清华大学开源实时多模态智能体 Realtime-Venus:双 9B 全双工模型,支持边聊天边执行后台任务
蚂蚁集团 Venus 团队联合清华大学开源实时多模态智能体系统 Realtime-Venus,提供两款分别面向音视频交互和语音对话的 9B 参数模型,以及异步任务执行框架 Realtime-Venus-Harness。系统采用双循环架构,将实时感知、语音交流与复杂任务执行分离,使智能体能够持续接收摄像头和麦克风输入,在与用户对话的同时执行搜索、推理及工具调用,并在任务完成后将结果带回原有对话。
两款 9B 模型分别支持实时音视频与全双工语音: Realtime-Venus-Omni 能够持续处理流式音视频,结合环境变化主动发起交互,并原生生成语音回复;Realtime-Venus-Audio 则专注于语音理解与全双工对话。两款模型均可独立作为交互前端,在 AI 说话时继续监听用户输入,区分简短附和、背景人声和真正需要响应的打断。
双循环架构实现实时对话与后台任务并行: 系统将交互循环与任务执行循环分离。前台模型遇到复杂任务时,通过
<delegate>标记将请求交给 Realtime-Venus-Harness,由后者执行推理、搜索及工具调用,前台则继续与用户交流。任务完成后,Harness 将结果返回原会话,由语音模型决定合适的播报时机。框架还支持任务进度跟踪、取消及结果交付状态管理。全双工评测中,用户打断响应率达 75%: 在 Full-Duplex-Bench v1.5 测试中,Realtime-Venus-Audio 对用户打断的响应率为 75%;面对简短附和、对其他人说话及背景人声时,继续原有发言的比例分别达到 97%、88% 和 86%。在音频理解评测中,模型取得 MMAU 78.0%、MMAU-Pro 63.2% 的成绩。Realtime-Venus-Omni 则在 8 项在线视频理解基准中的 6 项取得参评模型最高分,其中 StreamingBench 达到 70.2%。
开放模型权重、异步执行框架及浏览器 Demo: 项目已在 Hugging Face 和 ModelScope 提供两款模型权重,并在 GitHub 开放推理示例、Harness 源代码和浏览器演示。Demo 支持实时摄像头、麦克风输入,并使用 Codex 作为默认后台任务执行器,开发者也可接入其他执行系统。官方要求浏览器实时演示至少使用一张 NVIDIA A100 GPU,项目代码采用 Apache 2.0 许可证。
目前 Realtime-Venus 属于研究与演示项目,已提供 Android Beta 演示应用。项目尚未明确提供与 OpenAI Realtime API 协议直接兼容的接口,开发者需要根据其公开的服务接口进行集成。
https://realtime-venus.github.io/
4、实时通信平台 Twilio 推出 Video Media SDK 公测版:后端可作为虚拟参与者加入视频通话,直接收发原始音视频帧
实时通信平台 Twilio 发布服务端音视频开发工具包 Video Media SDK for Node.js 公测版,让开发者的后端应用可以作为虚拟参与者直接加入 Twilio Video Group Room,实时接收其他参与者的音视频数据,并将处理后的音视频重新发布到通话中。相比此前需要通过无头浏览器接入视频会议的方案,新 SDK 允许服务端直接访问解码后的音视频帧,用于构建实时多模态 AI 智能体、语音转写、计算机视觉及音视频处理服务。
后端直接加入通话,双向收发原始音视频帧: Video Media SDK 基于 WebRTC 构建,服务端应用可使用与现有客户端相同的 Room、Participant、Track 和 Access Token 机制加入视频房间。开发者能够直接获取其他参与者的独立音视频轨道,并通过代码发布虚拟摄像头画面或麦克风音频,无需运行浏览器,也不依赖物理摄像头和麦克风。
支持将实时音视频接入 AI 模型: SDK 向应用提供解码后的音视频帧,其中视频采用 I420 格式,音频输入采用 48kHz 单声道 PCM。开发者可以将音频流接入 ASR 或语音智能体,将视频帧送入视觉理解模型,再将 AI 生成的语音、视频或处理结果发布回通话房间。Twilio 同时提供 AI/ML 示例应用,展示实时转写、视觉分析及媒体处理等集成方式。
基于 Node.js 接入,沿用现有 Twilio Video 开发模型: SDK 已通过 npm 包
@twilio/video-node-sdk开放,支持 Node.js 24 及以上版本,生产部署面向 x86-64 Linux。当前视频编解码仅支持 VP8,音频支持 Opus 和 PCMU,暂不支持 H.264、VP9 等格式。开发者可以继续使用现有 Twilio Video 房间与访问令牌体系,减少服务端媒体处理功能的接入改造。
Video Media SDK 已于 9 月 30 日进入 Public Beta,Twilio 于 10 月 15 日进一步介绍其 AI 应用场景。公测版本尚不受正式服务等级协议(SLA)保障,也不具备 HIPAA 或 PCI DSS 合规资格;服务端虚拟参与者按普通 Group Room 参与者计费。
https://www.twilio.com/en-us/blog/products/launches/video-media-sdk-public-beta-launch
5、香港中文大学(深圳)联合华为提出真实通话音频鉴伪基准 RealComm:语音伪造检测错误率最高从 0% 升至 37.95%
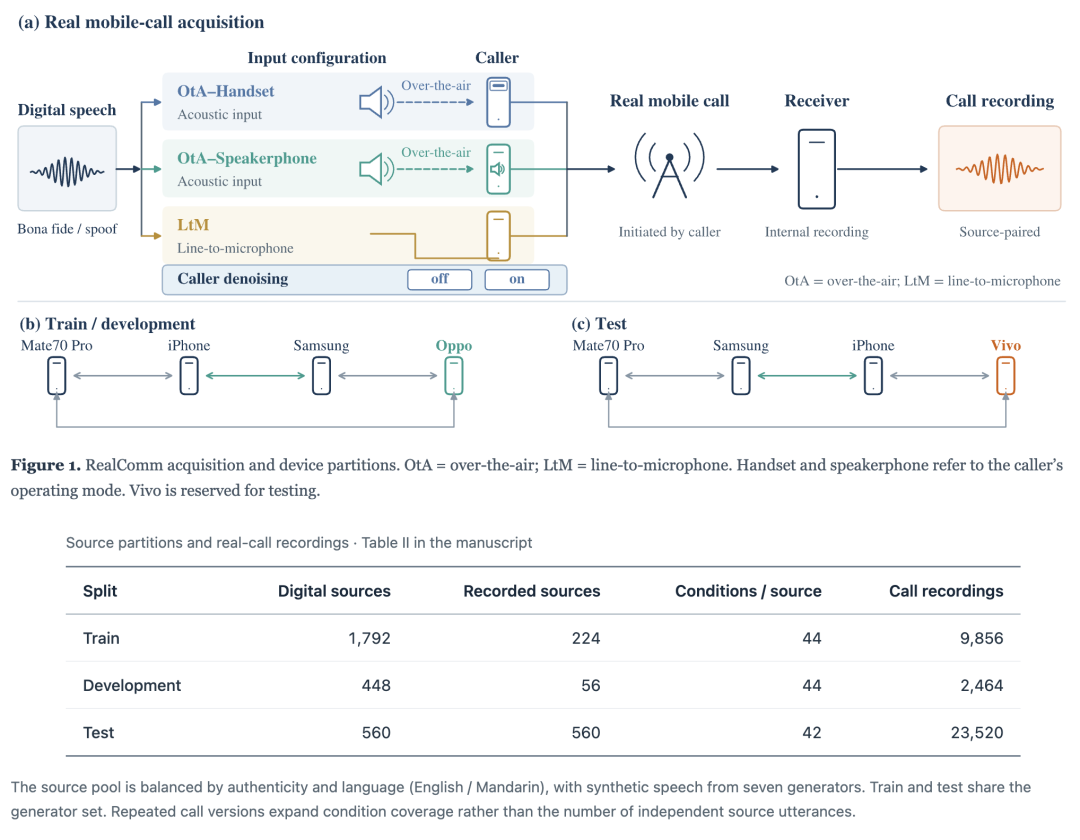
香港中文大学(深圳)与华为联合提出 RealComm,面向真实通信信道中的 AI 生成语音检测,构建包含 23,520 条真实通话录音的评测基准,系统研究麦克风采集、设备降噪和通信编码对音频鉴伪的影响。实验发现,部分模型在原始数字音频上几乎能够完全识别伪造语音,但经过真实电话传输后,检测性能明显下降。其中,Teffic-Audio 的等错误率(EER)从 0% 升至 37.95%,暴露出数字音频评测与实际通话场景之间的性能差距。
构建覆盖 42 种通话条件的真实音频鉴伪基准: RealComm 基于 2800 条中英文真实及合成语音,涵盖 CosyVoice2、F5-TTS、IndexTTS2 等 7 种语音生成系统。团队通过华为、苹果、三星、OPPO、vivo 等手机进行真实通话采集,覆盖扬声器播放后由麦克风拾音、线路直接注入、听筒与免提模式,以及不同设备降噪设置。测试集包含 560 条独立语音对应的 23,520 条通话录音,用于比较同一段声音在传输前后的鉴伪表现。
真实通话使主流鉴伪模型的 EER 上升超过 30 个百分点: 在未经 RealComm 适配的测试中,WavLM-L 的 EER 从 4.64% 升至 40.00%,AASIST 从 7.50% 升至 40.19%,DF Arena 从 7.86% 升至 38.77%。声学播放再录制的场景尤其困难。进一步分析发现,语音质量下降与鉴伪性能退化存在关联,但单纯的高频信息损失不足以解释不同通话条件下的性能差异。
通过通信信道数据增强与真实通话训练,将 EER 降至 22.37%: 团队提出 RealComm-Aug,分阶段模拟声学传播、设备处理、音频编码及通信传输中的信号变化,并结合真实通话数据对现有检测模型进行适配。在 RealCommBench 上,Teffic-Audio 的 EER 从 37.94% 降至 22.37%,WavLM-L 从 40.00% 降至 34.16%,AASIST 从 40.19% 降至 36.90%。其中,模拟增强与真实通话训练结合的效果优于单独使用任一种方法。
RealComm 已公开论文、项目主页和中英文音频对比演示,后续评测结果计划通过 SpoofRadar 排行榜维护。目前完整数据集尚未公开下载,首批计划提供仅用于评测的 RealCommBench,真实通话训练集 RealCommTrain 及 RealComm-Aug 代码暂未发布。研究覆盖的设备、语言与语音生成系统仍有限,结果不能直接推广至所有通信平台及未知语音生成模型。
https://wwwwwli.github.io/RealComm/
02 有亮点的产品
1、开源强化学习项目 FineEnvs 发布多语言 OCR 与 ASR 训练环境:超 1200 万任务覆盖 102 种语音语言,ASR 字符错误率降低 45%
开源强化学习项目 FineEnvs 发布两套基于 Hugging Face OpenEnv 构建的多模态强化学习环境,分别面向文档 OCR 和自动语音识别(ASR)。项目将 22 种语言的超 100 万页文档及 102 种语言的语音数据转化为超过 1200 万个可验证训练任务,并开放环境服务、奖励机制和 GRPO 训练代码。开发者可以利用这些环境对现有多模态模型进行强化学习训练,无需自行搭建数据评估和奖励反馈系统。
ASR 环境覆盖 102 种语言、115 万个训练与评测任务: 基于 Google FLEURS 数据集构建,提供普通语音转写、逐字转写及语言识别三类任务。模型接收音频并生成文本,环境根据参考转写计算奖励:对以空格分词的语言采用词错误率,对中文、泰语等不以空格分词的语言采用字符错误率。音频按需从远程存储读取,无需预先下载整个语料库。
OCR 环境覆盖 22 种语言、约 1100 万个任务: 基于 Nayana OCR 数据集的 1,006,170 页文档,提供区域文字识别、整页文字识别、版面检测、多选视觉问答和开放式视觉问答五类任务。环境可自动比较文字识别结果、版面位置及问答准确性,返回训练奖励,并集成 Sarvam Indic OCR Bench 用于独立评估。
GRPO 训练使卡纳达语 ASR 字符错误率降低 45%: 团队使用 Gemma 4 E4B 模型,在单张 NVIDIA A100 上训练 4.7 小时、575 步,使其在 FLEURS 卡纳达语测试集上的字符错误率(CER)从 10.47% 降至 5.71%,词错误率(WER)从 31.2% 降至 24.3%。OCR 实验则使用 4000 个卡纳达语文本区域训练 10.5 小时,在独立测试集上将字符错误率从 42.77% 降至 36.02%。
提供可复现的强化学习流程,修复音频训练中的梯度问题: 两套环境均通过 OpenEnv 接口管理任务与奖励,并结合 Hugging Face TRL、GRPO 和 LoRA 进行模型训练。团队还发现 TRL 1.13 在计算 GRPO 损失时会丢失音频特征,导致模型虽然听着音频生成转写,却未真正根据音频信号优化参数。项目因此实现了专门的 AudioGRPOTrainer,确保音频特征参与训练过程,并公开各训练检查点的评测结果及训练曲线。
目前两套 OpenEnv 环境已部署至 Hugging Face Spaces,提供在线交互体验、完整源代码及卡纳达语 OCR/ASR 模型适配器。代码采用 Apache 2.0 许可证,其中 OCR 使用的 Nayana 数据及相关模型适配器采用 CC BY-NC 4.0,限制商业用途。现有性能提升来自卡纳达语实验,尚未验证在全部 102 种语言上的训练效果。
https://huggingface.co/collections/FineEnvs/multilingual-multimodal-envs
https://github.com/adithya-s-k/FineEnvs/tree/main/06-multilingual
https://huggingface.co/spaces/FineEnvs/fleurs-asr-env
https://huggingface.co/spaces/FineEnvs/nayana-ocr-env
https://x.com/adithya_s_k/status/2110364361231651321
2、韩国 AI 数字人公司 Eastsoft 推出实时视频通话应用 Blooming Talk:24 位 K-Pop 偶像 AI 分身,支持一对一语音互动
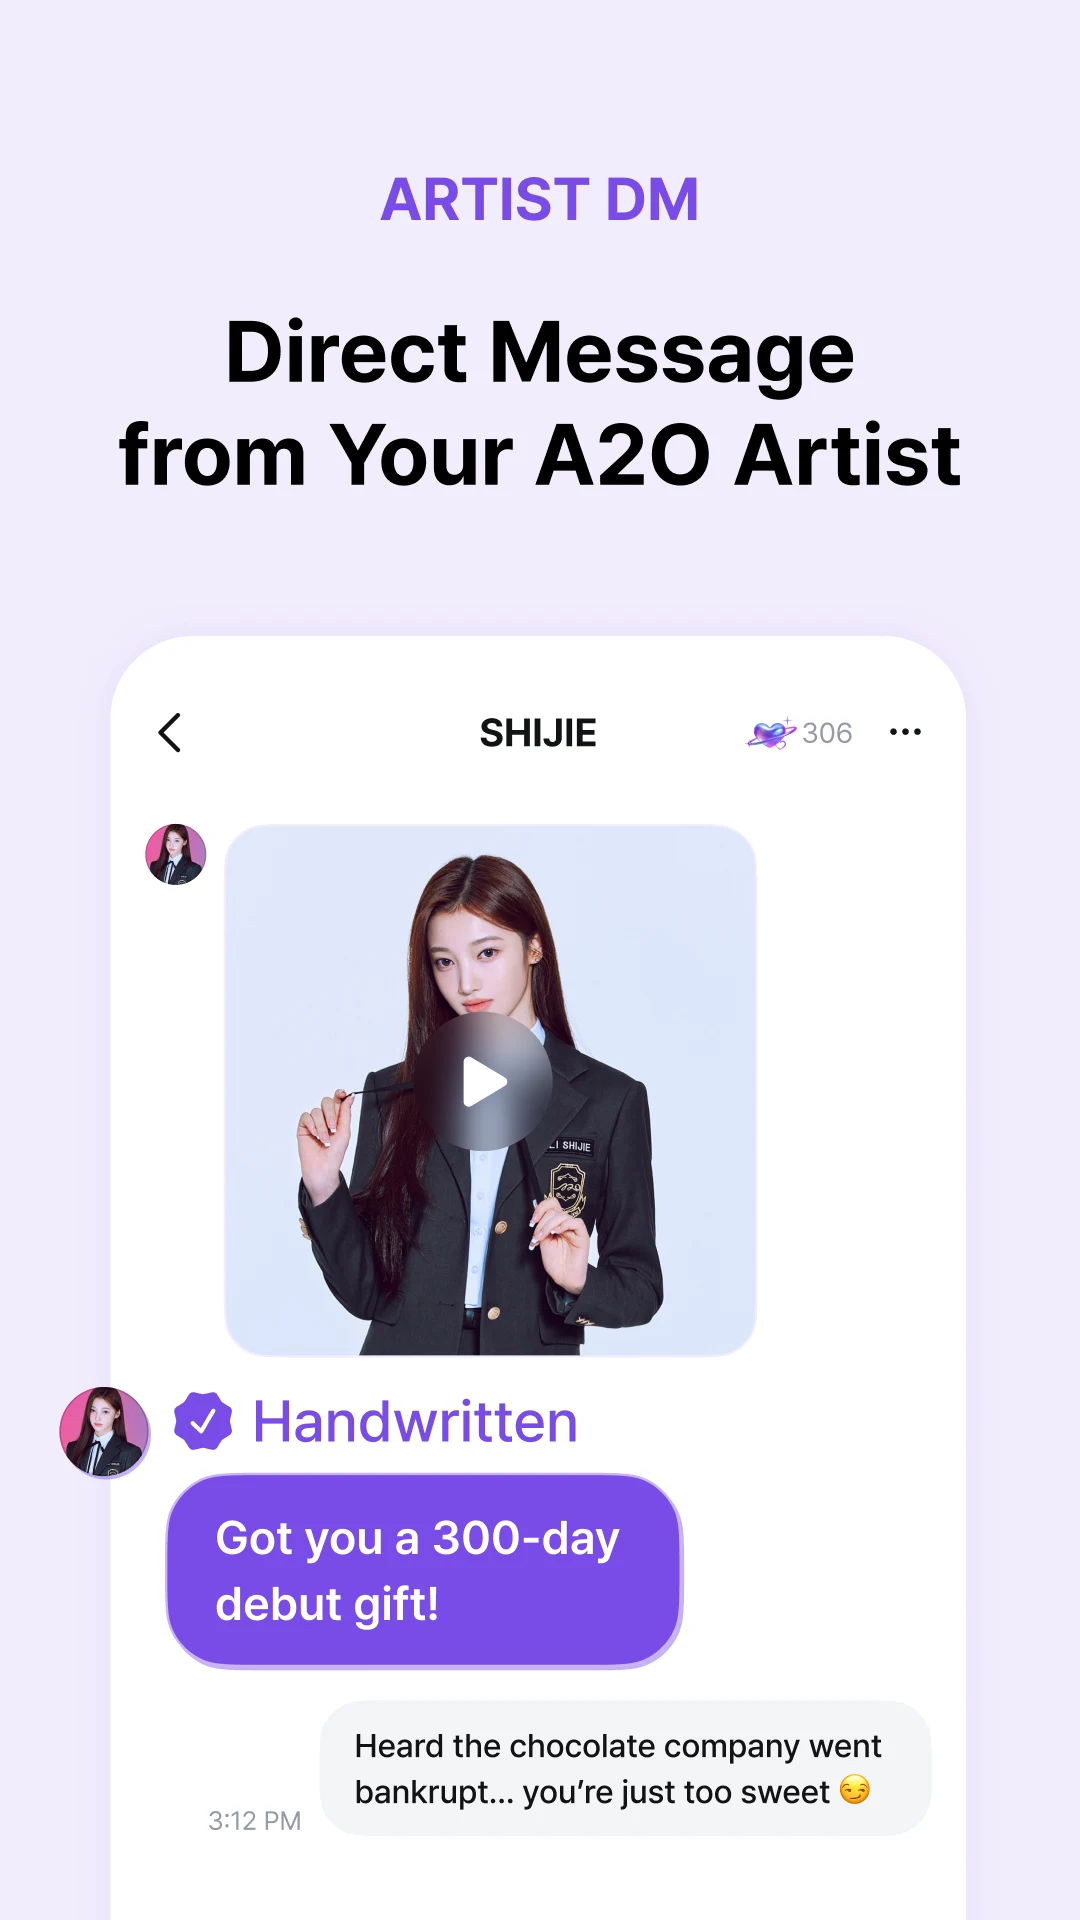
韩国 AI 软件公司 Eastsoft(이스트소프트) 联合 Blooming Grace 推出 K-Pop 偶像 AI 视频通话服务 Blooming Talk,基于旗下实时交互式数字人技术 Perso Interactive,让粉丝能够与虚拟偶像进行一对一实时视频通话。首批服务覆盖韩国偶像团体 A2O SOUL 和 A2O LITE 的全部 24 位成员,用户可选择喜欢的艺人 AI 分身,通过语音进行实时交流,并在屏幕上看到对应的数字人形象。
基于真实拍摄数据构建 24 个 AI 分身: Eastsoft 使用艺人的实拍素材,为每位成员分别创建 AI 数字人,复现其外貌和个人特征。数字人能够实时响应粉丝的语音输入,提供面对面的互动体验,将原有的文字聊天、语音通话扩展为实时视频对话。
服务端实时渲染与流媒体传输,降低终端性能要求: Blooming Talk 采用 Eastsoft 的 Perso Interactive 技术,在服务器端完成 AI 数字人的实时渲染,再通过流媒体传输至用户设备,使普通手机也能进行高清数字人视频通话。官方尚未披露视频生成帧率、端到端延迟及底层语音模型等技术指标。
计划扩展韩英日中等多语言交互: Blooming Talk 面向全球 K-Pop 粉丝,计划持续扩展韩语、英语、日语和中文等语言支持。项目由 Blooming Grace 负责应用运营及艺人 IP 管理,Eastsoft 提供 AI 数字人制作、实时渲染和流媒体技术,Mindlogic 负责应用开发。
Blooming Talk 已在 iOS 和 Android 平台提供应用,并在 10 月 12 日的 A2O 全球出道活动中展示实时视频通话体验。此次发布重点是将 24 位艺人的 AI 数字人整合为可实际使用的粉丝互动服务,具体视频通话功能的地区开放范围和收费方式尚未完整披露。
https://estsoft.ai/en/all/k-pop-ai-avatar-2026
03 有态度的观点
1、Rivian 计划接入第三方 AI 智能体,刹车与转向不交给 Agent
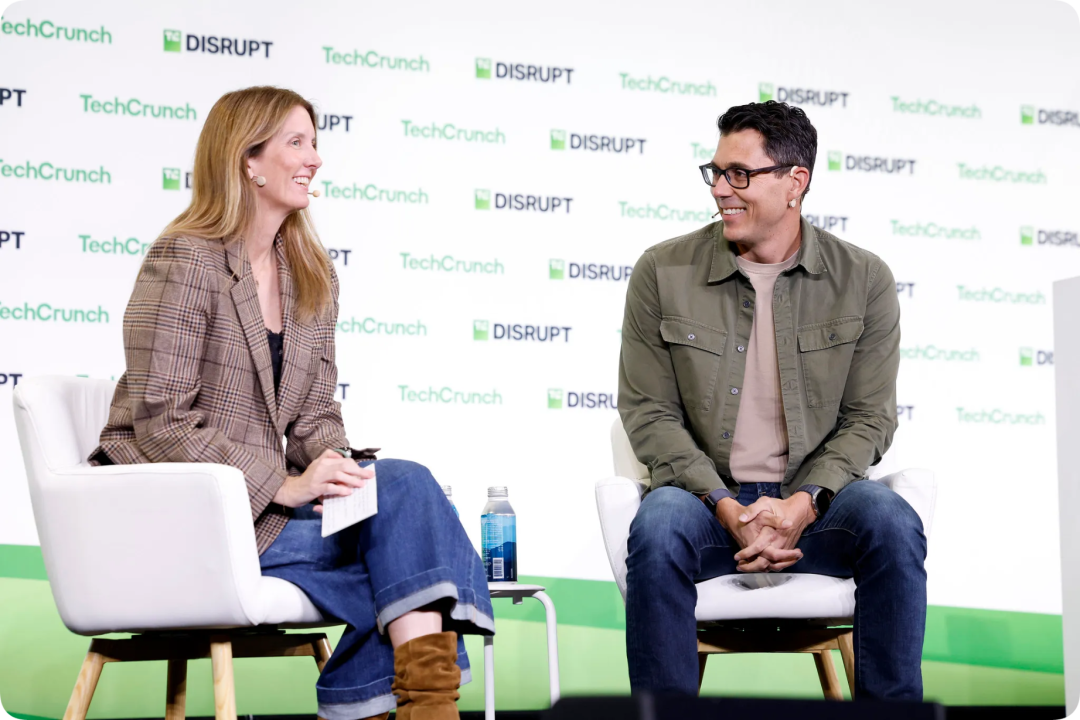
Rivian 创始人兼 CEO RJ Scaringe 在本周 TechCrunch Disrupt 现场表示,公司计划让汽车运行 Anthropic 等外部公司的 AI 智能体。Rivian 已推出自研车载 AI 助手,第三方接入仍属于下一步规划。
据 TechCrunch 10 月 15 日的现场采访,Rivian 的自研智能体框架会先判断用户意图,再把任务交给车内本地模型或云端模型。现有用途包括调节温度、打开座椅加热和摘要新闻,今年 5 月已能访问 Google Calendar 等外部应用。Scaringe 举例说,车主今后可以先要求打开座椅通风,再接着聊起前一天在其他设备上讨论过的聚餐计划,让车载助手延续既有对话。这需要与模型公司协作,打通用户上下文。
他同时明确划出安全边界:智能体不能自行决定刹车或转向,车辆级控制不会交给 Agent。Rivian 未给出第三方接入的上线日期,后续将于 12 月举办 AI 与自动驾驶活动。
(@APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、如果今年只参加一场实时交互模型和 Voice Agent 大会,来 iRTE2026 实时智能大会就够了
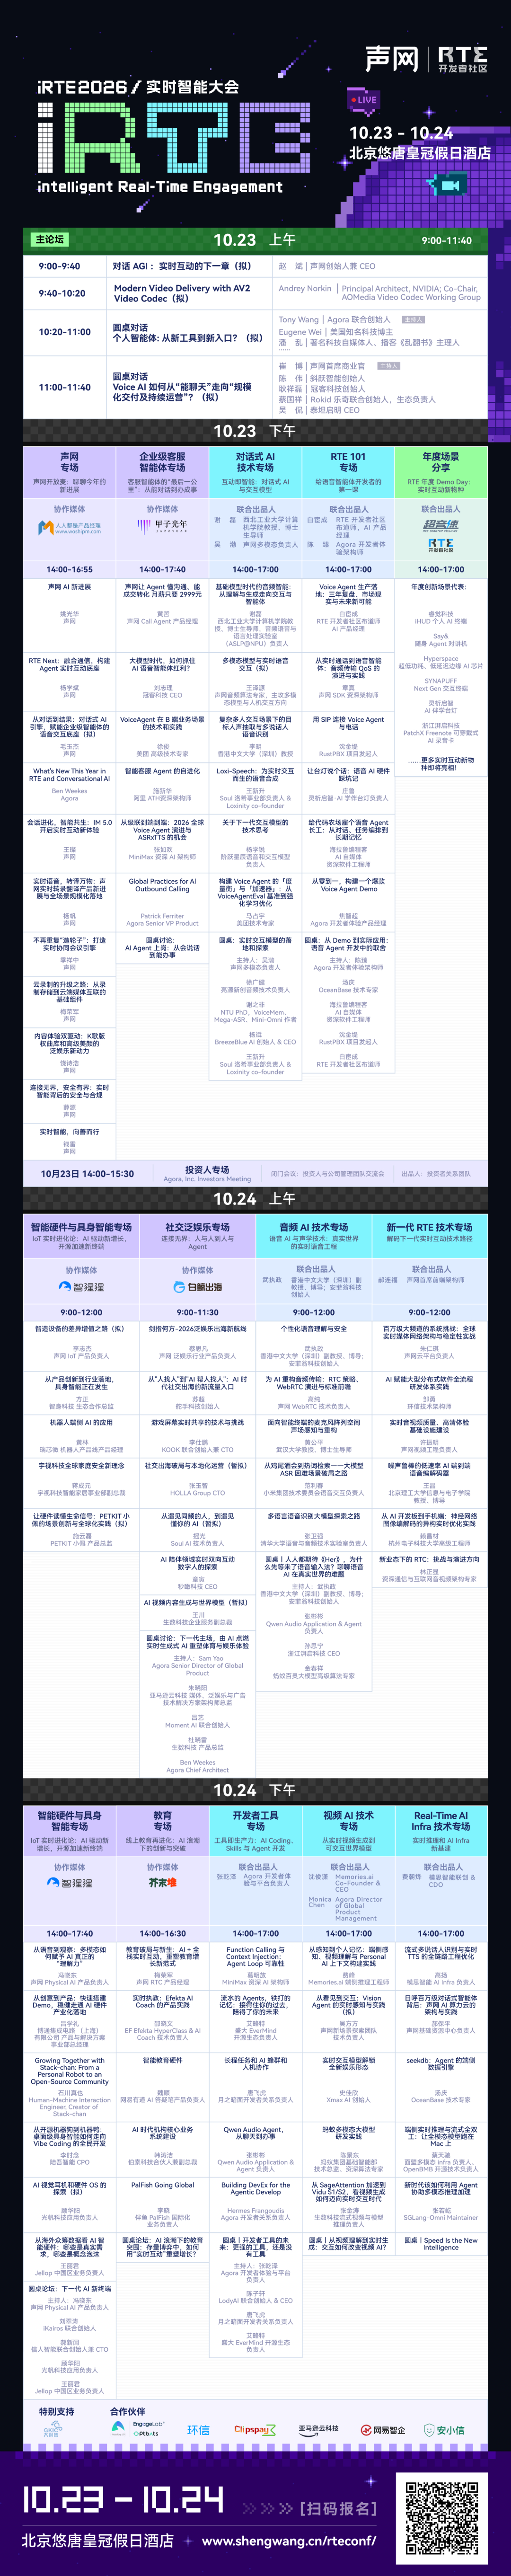
在这里,Kimi、MiniMax、阶跃星辰、面壁智能、模思智能、生数科技等国内领先大模型公司将带来最前沿的 AI 产品 / 技术分享,话题覆盖多模态模型、Voice Agent、AI 硬件、具身智能、实时基础设施等。
还有美团、阿里 ATH、Rokid、斜跃智能、博通集成、Soul、HOLLA、EF 英孚、伴鱼等企业分享 Voice Agent 在客服、硬件、具身智能、社交、教育等行业场景的落地。现场更有丰富的开发者工作坊,手搓各类 Voice Agent 应用与硬件。
10 月 23-24 日,来 iRTE 大会现场,与国内外一线的 AI 产品 / 技术专家深度交流,掌握 RTE、Voice Agent、实时多模态的最新动向与技术实践,把握 2026 Voice Agent 技术风向标。欢迎关注公众号和添加小助手微信 Creators2022 进大会交流群获取直播提醒。
 大会官网:
https://www.shengwang.cn/rteconf/
 大会完整议程和报名入口:
https://www.bagevent.com/event/sales/6irv248ftquhuztz4utylfi7m2xn4f8n
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考