多智能体平台 Teamily 推出视频 Agent,可接入视频会议和 AI 眼镜丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、OpenAI 上线全双工语音模型 GPT-Live-1.1 API:提升多语言口音一致性,待机价格降至每分钟 0.02 美元
OpenAI 在 API 中正式开放新一代全双工语音模型 GPT-Live-1.1。相比 GPT-Live-1,新模型提升语音转写准确率、多语言口音自然度与音色一致性,并优化后台任务委派的可靠性。同时新增低成本待机模式,使需要长时间保持连接的 Voice Agent 能够在暂停模型推理时降低会话成本。
提升多语言语音交互质量: 保留边听边说、实时打断等全双工能力,重点优化不同语言及地区口音的自然度、跨语言音色一致性和语音转写准确率。
新增 Standby 待机模式: 活跃会话定价为每分钟 0.05 美元,WebRTC 会话暂停推理后,待机费率降至每分钟 0.02 美元,较活跃状态降低 60%,适用于长时间连接但间歇性交互的应用。
提升后台任务执行可靠性: 开发者可以通过自然语言指定何时将任务交给后台模型进行复杂推理或工具调用,使实时语音交互与后台任务执行协同运行。后台模型及工具调用费用单独计算。
已通过 Live API 开放: 开发者可使用模型 ID
gpt-live-1.1接入,支持文本、音频输入与输出。GPT-Live-1.1 与上一代模型采用独立的并发会话额度,目前不支持图片和视频输入。
https://developers.openai.com/api/docs/models/gpt-live-1.1
2、火山引擎全量开放豆包全双工音视频模型 SeedRealtime 1.0 API:支持边看边听边说,感知环境并主动开口
火山引擎正式上线豆包实时音视频通话模型 SeedRealtime 1.0 的 API 服务。模型在豆包全双工语音模型 SeedDuplex 3.0 的基础上引入视觉输入,将声音、画面、时序和表达纳入统一的端到端交互架构,支持在持续感知环境变化的同时进行语音交流,并在合适的时机主动提供提醒与反馈。
统一实时语音与视觉输入: 支持客户端以最高 2 FPS 的频率上传摄像头或屏幕画面,模型结合持续输入的音频和视觉信息生成语音回应,并新增图片输入及火山搜图能力。
支持环境感知与主动式交互: 当关键目标出现、画面状态改变或任务节点到来时,模型能够主动开口,并根据用户交流节奏自然接话、停顿及处理打断。火山引擎称,相比级联方案,音视频对话节奏问题减少约 50%。
重新设计客户端交互状态机制: ASR 事件与播放状态完全解耦,客户端不再通过转写完成信号判断何时播放语音,而是根据服务端
response.created、response.canceled和response.done事件控制聆听、播放及打断。已开放 WebSocket API 与开发示例: 支持 16kHz 音频输入、24kHz 音频输出及 Function Calling,系统提示词、历史对话和工具调用结果等合计上下文上限为 64K Token。官方提供 Go、Python 和 Web Demo,开发者可配置 API Key 直接体验。
(@火山引擎)
3、Fermion Research 揭示 ASR 模型内部的语义神经元:语言识别准确率达 99.1%,通过 10KB 级检测模块抑制转写幻觉
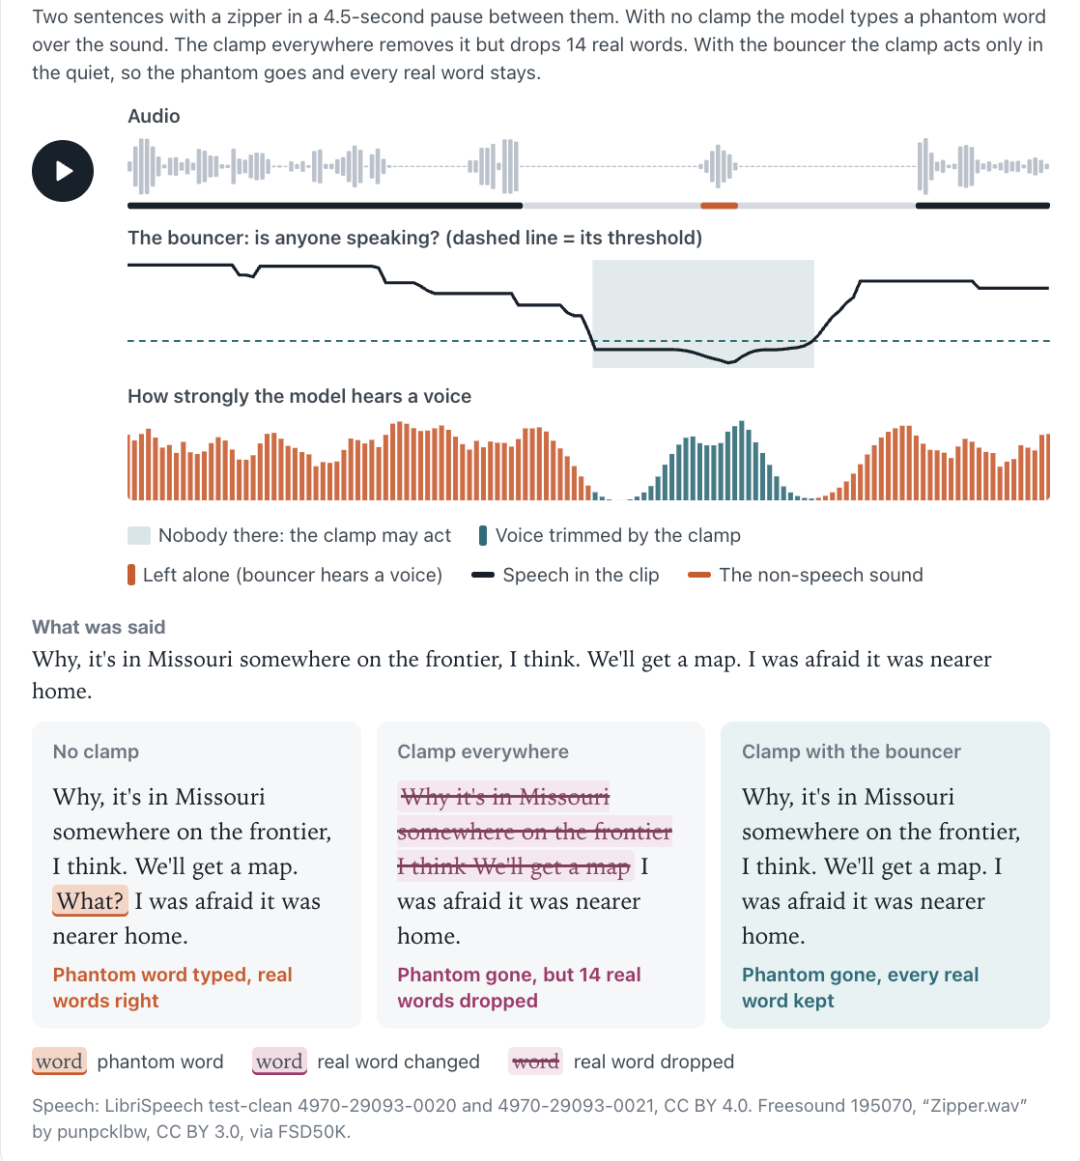
AI 模型研究团队 Fermion Research 发布针对语音识别模型 Phonon-2.5 的神经元可解释性研究。团队发现,即使模型仅针对语音转写进行训练,其内部也会自发形成与语言类别、说话速度和声学环境相关的特征表示。研究人员进一步利用这些内部表示干预语音识别过程,减少快速讲话时的识别错误及无人讲话时的转写幻觉。
单语言仅需一个神经元即可完成识别: 在 VoxPopuli 的 786 段、16 种语言测试音频中,通过读取对应语言神经元的激活值,识别准确率达到 99.1%,高于专用语言识别模型 VoxLingua107 的 97.2%。
利用内部语速表示改善快速语音识别: 通过读取编码器内部的语速特征,对过快的输入音频进行自适应降速,使 2.5 倍速语音的词错误率从 23.6% 降至 3.2%。
发现与声学环境相关的神经元: 在厨房、行驶中的汽车等 17 类声学环境中,有 15 类可以通过单个神经元可靠地区分。相关信息主要集中于编码器浅层,随后逐渐减弱。
利用约 10KB 的检测模块抑制转写幻觉: 结合模型内部的语音活动特征,在无人讲话时抑制错误文本生成。该方案已应用于语音转写工具 Detta 1.1.3,在发布测试中消除了 150 段曾触发幻觉的噪声音频中的 142 段错误转写。团队计划后续开源神经元定位、测试与编辑框架。
https://www.fermionresearch.com/research/reading-the-neurons-of-a-speech-model/
4、AI 推理基础设施公司 RightNow 发布多模态决策模型 v3:支持流式输入,单次决策约 30ms
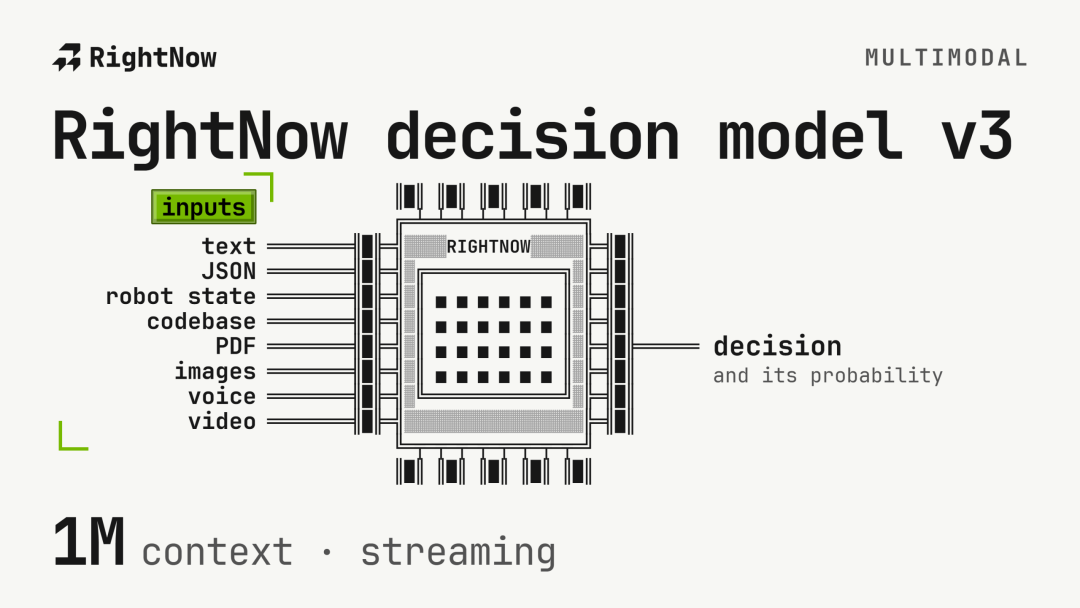
AI 推理基础设施公司 RightNow 发布 Decision Model v3,支持在输入信息持续到达时直接输出结构化决策及各选项的概率。团队将这类模型定义为 System Zero,即位于快速思考与复杂推理之前的决策层,面向机器人即时行为控制、Agent 工具选择、客服任务路由等需要低延迟判断的场景。
支持八类输入信息: 包括文本、JSON、机器人状态、代码库、PDF、图像、语音及视频,其中视频输入目前处于预览阶段。
在输入过程中持续更新决策: 开发者可以自定义判断问题及候选选项,模型输出布尔判断、分类结果或评分及对应概率,并随着新信息到达更新判断,无需等待完整输入结束。
单次决策约 30ms,支持百万 Token 上下文: 据团队公布的数据,模型单次调用最多支持 100 万 Token 上下文,每个已回答问题定价为 0.0001 美元。
已开放决策模型 API: 开发者可通过 REST API 或流式连接接入,并使用结构化结果触发机器人、语音 Agent 或业务工作流中的后续行为。新注册账户可获得 1 美元免费额度。
https://www.rightnowai.co/rightnow
5、Trelis Research 发布面向全双工语音模型的情感播客数据集:补充悲伤、愤怒等情绪样本,提供独立说话人音轨
AI 语音数据研究团队 Trelis Research 发布情感播客数据集 Duplex Emotional Candid Podcasts Mimi,这是其面向全双工 Speech-to-Speech 模型训练发布的第四项数据与模型资源。针对传统播客访谈中悲伤、愤怒等负面情绪样本较少的问题,新数据集重点改善情绪分布,并通过分离说话人音轨,为双轨全双工语音模型提供训练素材。
改善自然对话中的情绪分布: 针对普通播客访谈情绪多样性不足的问题,增加悲伤、愤怒等情绪样本,帮助全双工模型学习不同情绪下的表达与对话行为。
提供独立说话人音轨: 筛选包含一至两名说话人且背景音乐较少的音频,以双轨数据为主,并将不同说话人的声音分离至独立音轨,可用于双轨全双工模型训练。
延续 Mimi 音频编码数据路线: 新数据集已发布至 Hugging Face,与团队此前发布的播客预训练数据集及自然对话数据集共同构成面向全双工语音模型的训练资源。
https://huggingface.co/datasets/Trelis/duplex-pre-training-podcasts-mimi
02 有亮点的产品
1、开发者进行实时 AI 数字人镜像实验:当全双工多模态数字人看到自己的脸,会如何回应?
Mark Kretschmann 做了个有趣的实验:用镜子把 AI 的脸映回摄像头,看看她会如何回应。Nuance Labs 已开放实时视频对话体验,直接在浏览器里就能和 Emma、Nora 面对面聊天。对 Nuance Labs 感兴趣的朋友也可以试试,给她看看身边的物品,聊聊她「眼中」的世界 
https://www.nuancelabs.ai/research/meet-emma-the-first-nuplex-persona
2、桌面语音 AI 应用 Incredible 推出 Agents 功能:结合实时屏幕感知,支持通过语音创建与调度智能体
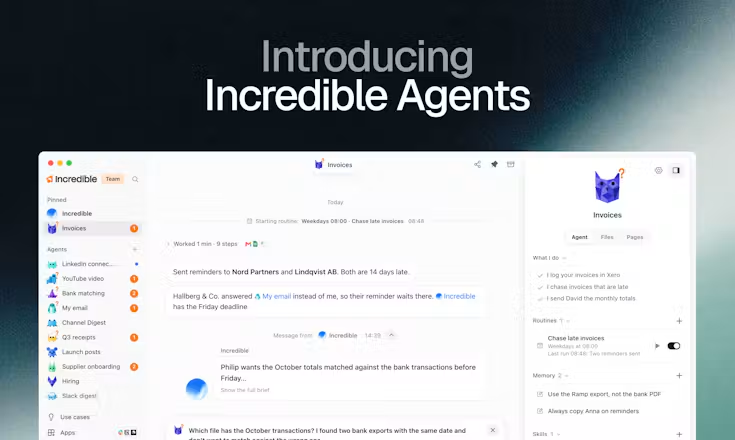
桌面语音 AI 应用 Incredible 推出 Incredible Agents 更新,将语音交互、屏幕上下文理解与 Computer Use 能力结合。用户可在任意应用中按住键盘快捷键唤起 AI,通过自然语言描述需求,系统自动理解当前屏幕内容、选中的文本及文件,并创建能够持续执行任务的 Agent。
语音与实时屏幕上下文结合: 用户无需切换至独立聊天窗口,即可通过快捷键唤起 AI,结合当前应用界面发出操作指令,减少重复描述任务背景的成本。
主动发现可自动化的工作: Incredible 可以推荐适合交由 Agent 处理的重复性任务,并协助创建具备独立记忆、执行规则及定时任务的智能体。
支持 Computer Use 与 MCP 扩展: Agent 可以操作浏览器、桌面文件和应用程序,支持连接自定义 MCP Server 及第三方工具,并创建可分享的网页、仪表盘和应用。
已开放 Windows 与 macOS 版本: 提供 7 天免费试用,订阅价格从每月 25 美元起。官方称已通过 Sensiba 的 SOC 2 Type II 审计,符合 GDPR 要求,且不使用客户数据训练模型。
https://www.producthunt.com/products/incredible
3、捷克实时生成式 AI 公司 ValkaAI 将 Pre-Seed 融资扩大至 1300 万欧元:自研音视频模型,面向体育及电竞直播
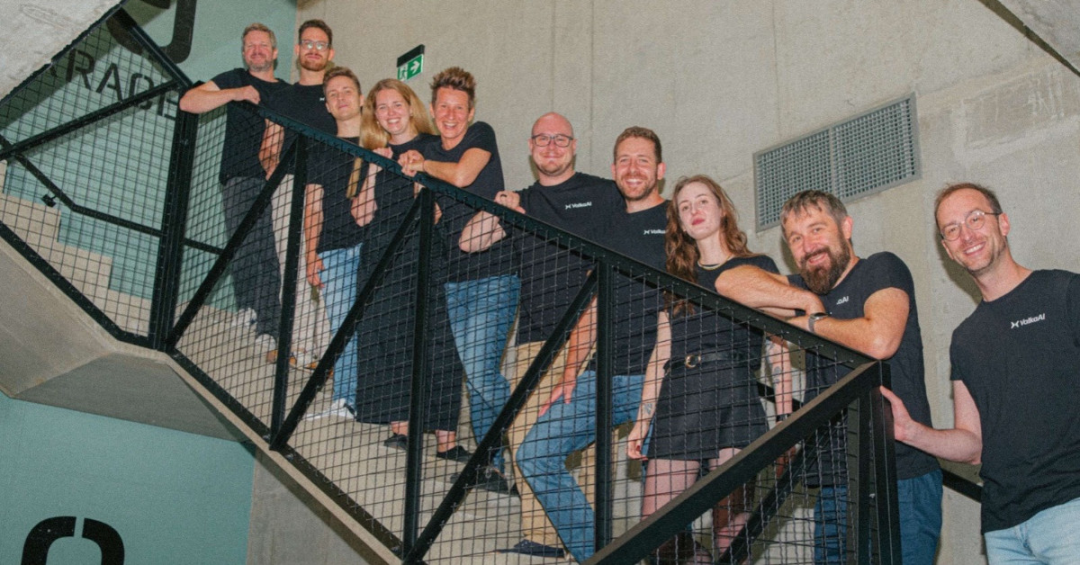
捷克实时生成式 AI 公司 ValkaAI 获得 Look AI Ventures 和 ff Venture Capital 追加投资,将今年 2 月宣布的 1200 万欧元 Pre-Seed 融资扩大至 1300 万欧元。公司聚焦实时数字人及互动娱乐,针对音频生成、视频生成和事件理解开展自研模型研究,首款产品 ValkaAI Commentator 已支持根据实时赛事数据生成个性化语音解说。
多模态感知实时赛事: 结合视频理解模型、结构化赛事数据和传感器信息,将不同来源的输入转换为统一事件流,并结合球员表现、历史战绩及赛事背景构建实时上下文。
通过 Sport Harness 决定何时发言: 系统持续判断当前事件是否值得解说、是否需要延续此前话题,或应保持沉默,并记录已生成内容,减少重复表达。
自研情感语音合成系统 ValkaTTS: 根据比赛进程实时生成具有兴奋、失望、紧张等情绪的语音解说,支持针对不同语言、球队立场和观众群体生成独立音轨,并与赛事画面进行时间同步。
新融资用于实时音视频模型研发: 团队成立于 2025 年,目前约有 50 名成员,分布于布拉格、旧金山和迪拜,包括来自 Meta 和 DeepMind 的研究人员。新增资金将用于实时音视频生成研究、人才招募及商业合作。
https://lookai.vc/look-ai-ventures-joins-valkaai-13m-pre-seed-round/
4、AI 多智能体协作平台 Teamily 发布 Video Agent 与 AI Glasses:为智能体赋予虚拟形象与实时视听感知能力
AI 多智能体协作平台 Teamily 发布 Video Agent 与 AI Glasses,为平台内的 Agent 增加可视化人物形象及实时音视频交互能力。Agent 可以通过摄像头或 AI 眼镜感知用户所处的物理环境,在保留原有身份、长期记忆、社交关系和任务执行能力的基础上,与用户进行实时交流,将人机协作从数字空间延伸至物理世界。
实时音视频交互: 为平台内的 Agent 赋予虚拟人物形象,支持通过视频通话进行交流,并理解摄像头或 AI 眼镜采集的第一视角画面及声音。
跨设备共享身份与长期记忆: 同一个 Agent 可在即时通信、语音通话、视频会议及 AI 眼镜等场景中保持身份、记忆与上下文连续性,并调用外部服务执行数字任务。
从 Digital Agent 向 Physical Agent 延伸: 团队将 AI 眼镜作为进入 Physical AI 的第一步,计划通过第一视角音视频、人类操作示范及反馈积累物理世界交互经验,未来进一步接入机器人系统。
多人与多 Agent 协作: Teamily 此前主要构建面向人类与 Always-on Agent 的原生即时通信及协作平台,支持群聊、多智能体协作、长期记忆及跨模型任务调度。
https://teamily.ai/
03 有态度的观点
1、马斯克:英伟达让黄仁勋离开,如同公牛踢走乔丹
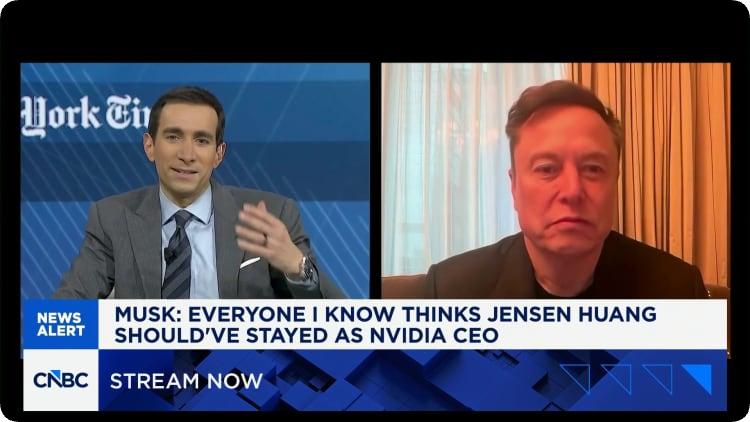
马斯克在《纽约时报》DealBook 峰会上再次支持黄仁勋。他把英伟达让黄仁勋离开的决定,比作芝加哥公牛队在连胜途中将巅峰期的迈克尔·乔丹踢出球队,认为董事会作出这类决定前应当慎重考虑。
据 CNBC 现场报道,马斯克通过远程连线参会,称黄仁勋是「历史上最有才华的企业家之一」,并表示「没有人能真正取代黄仁勋」。他给出的理由是,黄仁勋在英伟达获得了很强的忠诚,尤其是一些抢手的工程师,正是为了与他共事才留在公司。马斯克还强调了黄仁勋数十年来积累的长期合作关系、对技术的深刻理解,以及团队成员对他的认可。
他认为,黄仁勋的离开对公司股东而言并非好事,也不赞成把他视作能够轻易被替换的管理者。马斯克还表示,黄仁勋虽然「犯了一些错误」,但他不认为黄仁勋对美国不忠。这些表态回应了峰会上关于英伟达是否应该让黄仁勋重返 CEO 岗位的提问。
( @APPSO )
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 社区伙伴活动推荐|MOSS-Live Dev Meetup 上海站
关注全双工语音、Voice Agent 和智能硬件的小伙伴,可以留意这场活动~
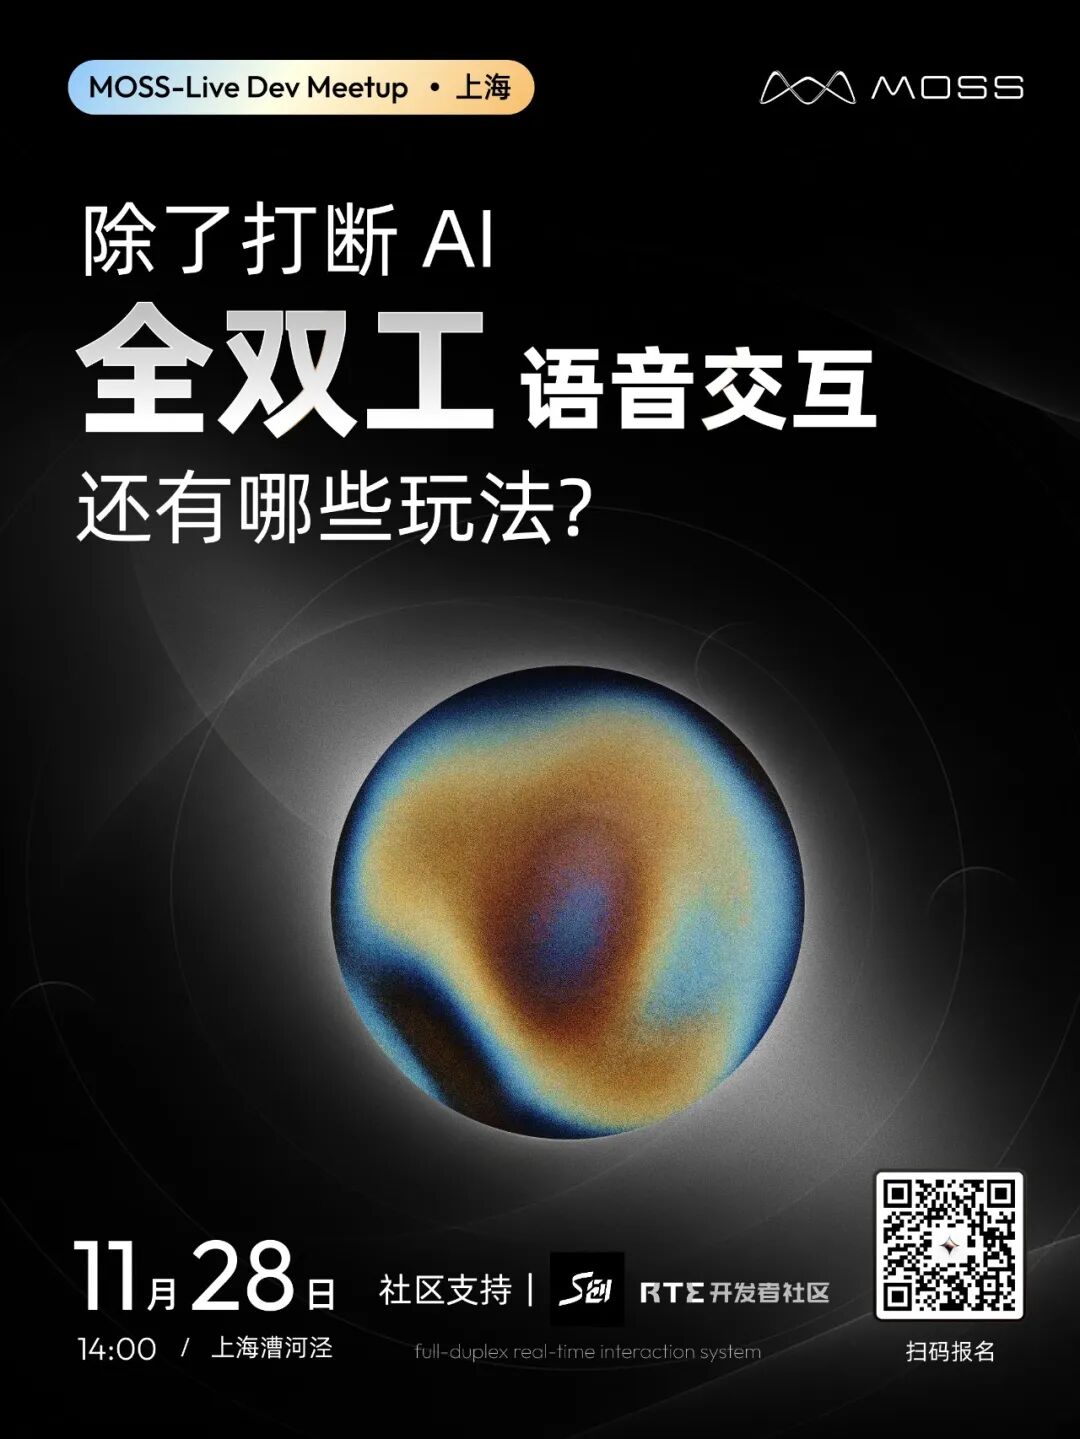
除了打断 AI,全双工语音交互还能怎么玩?这次 Meetup 将带来 MOSS-Live 技术分享与开发者 Demo 展示,一起探讨「边说边听」的交互体验,以及全双工在真实场景中的应用。现场还有模型体验与自由交流环节,欢迎带上你的想法和开发中遇到的问题!
 时间:11 月 28 日(周六)13:30—16:00
 地点:上海·漕河泾(审核通过后告知具体地址)
活动采用报名审核制,RTE 开发者社区渠道报名优先~感兴趣的朋友欢迎报名,相约现场交流! 活动详情与报名入口
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考