Neuphonic 开源 43MB 语音决策模型 NeuDecide:不经 ASR 语音调用工具丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、端侧 AI 模型公司 Liquid AI 开放两款多模态决策模型 d1:600M 首次支持音频输入,3B 可在 Jetson 上实现毫秒级决策
Liquid AI 发布 d1-3B 和实验性模型 d1-omni-600M,两款模型分别支持文本与图像、文本与图像或音频的组合输入。与逐 token 生成回复的 LLM 不同,d1 通过一次前向计算直接输出结构化决策结果及其概率,可用于智能体意图分类、任务路由、内容审核等场景,并支持在工作站和边缘设备上本地运行。与 NVIDIA 合作,在 Isaac Sim 中展示了 d1-3B 模型在环境中的导航能力。该模型运行在 Jetson 设备上,采用硬件在环仿真方式实现。
600M 模型首次加入音频决策能力: d1-omni-600M 约有 5.87 亿参数,采用共享主干网络连接视觉与音频编码器,支持最长 30 秒的语音输入。模型可以直接判断用户语音的主题、意图或请求类型,无需先转写成文字再交给 LLM 判断。目前音频能力主要针对英语语音训练,尚未公布专门的音频决策评测结果。
3B 模型可在 Jetson 上实现毫秒级推理: d1-3B 基于 LFM2.5-VL-3B 训练,在 Decision Index v0.2.1 公共测试集上得分 48.57。单个问题的端到端推理延迟在 RTX 4090 上为 8ms,Jetson AGX Thor 为 16ms,Jetson AGX Orin 为 26ms,Jetson Orin Nano 为 50ms。
开放权重并支持本地微调和部署: 两款模型均已在 Hugging Face 开放权重,并提供 llama.cpp 支持,覆盖 NVIDIA DGX、RTX 工作站及 Jetson 等设备。开发者可以根据决策准确率、模型体积和输入模态需求选择模型。
https://www.liquid.ai/blog/d1-open
2、语音 AI 公司 Neuphonic 开源 43MB 语音决策模型 NeuDecide:无需 ASR 直接生成工具调用,单线程 CPU 即可运行
Neuphonic 开源端侧语音决策模型 NeuDecide,仅有 5550 万参数、43MB 模型文件,可以直接将用户语音转换为工具调用的函数名称和参数,无需经过传统的 ASR 转写环节。模型基于 ONNX Runtime 运行,单线程 CPU 即可完成推理,无需 GPU 或云端服务,开发者还可以直接在浏览器演示中测试语音控制工具。
语音直接映射为工具调用: NeuDecide 将预训练流式语音编码器与轻量级工具调用模型结合,直接根据音频和开发者提供的 JSON Schema 生成结构化函数调用。例如,用户说出「打扫浴室」,模型即可输出
cleanRoom(room="bathroom")。工具列表可在推理时动态传入,无需为新增工具重新训练模型。43MB 模型实现毫秒级本地决策: 根据官方测试,NeuDecide 在 MacBook Pro M3 上生成工具调用耗时 46ms,三星 S24+ 为 82ms,树莓派 5 为 206ms。在 SLURP 语音指令测试中,模型的工具选择准确率达到 75.5%,函数及参数完全匹配率为 37.5%;作为对比,Whistle → Needle 3 串联方案分别为 25.6% 和 7.1%。
开放权重与本地部署: NeuDecide 采用 Apache 2.0 许可证,提供 Python SDK、ONNX 模型及 Hugging Face 在线演示。目前支持英语、最长 30 秒音频,官方建议单次提供不超过 10 个工具。模型更适合执行范围明确的语音指令,复杂或无法识别的请求仍建议交由更大的模型处理。
https://x.com/neuphonicspeech/status/2108161404079350113
3、独立开发者 Sahil Mahendrakar 开源 8M 参数 TTS 模型 Paradee:仅 9MB,单线程 CPU 实现 18 倍实时语音合成
开发者 Sahil Mahendrakar 发布开源语音合成模型 Paradee,通过知识蒸馏将 Kokoro-82M 从约 8200 万参数压缩至 807 万参数,并将量化后的模型文件缩小至 9MB。在 Apple M4 Pro 的单线程 CPU 上,发布的 ONNX 版本无需 GPU 即可达到约 18 倍实时语音合成速度,目前支持英语单音色生成。
将语音合成模型压缩至原来的约 1/10: Paradee 保留 Kokoro 的基本架构,但缩小各层宽度,将文本预测模块和音频解码器分别蒸馏。训练时利用原模型生成的音素时长、音高、能量和语音特征作为监督信号,两部分独立训练后直接组合,无需额外联合训练。
9MB 模型接近原版语音质量: 在 200 条测试语句上,Paradee 的 UTMOS 语音自然度预测评分为 4.41,接近 Kokoro-82M 的 4.52。研究版本的词错误率(WER)均为 5.7%。模型还通过无需额外训练的相位校正滤波器,减少小型解码器产生的轻微杂音。
支持 CPU 本地部署与浏览器运行: 项目已开放 Apache 2.0 许可的模型权重、训练代码和 ONNX 文件,可通过 Python 调用,也已用于浏览器扩展中的本地语音合成。目前仅支持 Kokoro 的
af_heart英语音色,暂不支持多音色生成。
https://huggingface.co/sahilmahendrakar/Paradee-8M-v1.0
4、微软 AI 发布流式语音识别模型 MAI-Transcribe-2-Streaming:百毫秒输出初步转写,同步推出两款多语言 TTS 模型
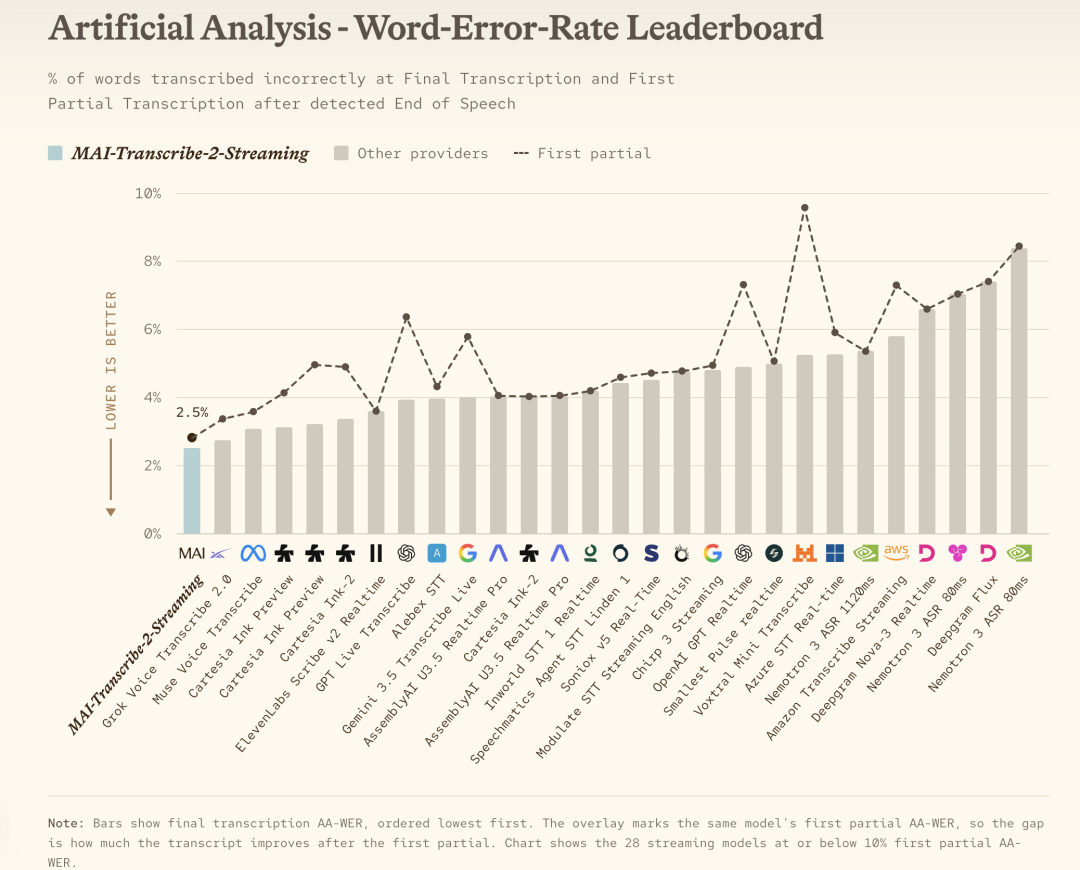
微软 AI 发布首款流式语音识别模型 MAI-Transcribe-2-Streaming,支持 60 种语言的实时转写,接收音频后约 100 毫秒即可输出初步识别结果,并随着后续语音输入持续修正。同期推出多语言语音合成模型 MAI-Voice-2.1 和低延迟版本 MAI-Voice-2.1-Flash,覆盖从实时语音识别到语音生成的完整链路。
流式 ASR 可在用户说完前输出识别结果: MAI-Transcribe-2-Streaming 支持连续语言检测,并逐步输出初步转写及最终确认文本,让 Voice Agent 能够在用户说话过程中提前启动推理或工具调用。微软表示,该模型在 Artificial Analysis 的初步转写和最终转写准确率评测中均排名第一;内部测试显示,实时字幕中的文字出现速度达到最接近竞争模型的 2 倍。
TTS 新增跨语言保持同一声线的能力: MAI-Voice-2.1 支持 23 种语言、26 个地区变体,同一个声音可以在英语、中文、德语等语言之间切换,同时保留声音身份,并采用相应语言的自然口音。模型还支持通过几秒参考音频进行跨语言声音克隆。
Flash 版本进一步降低语音生成延迟: MAI-Voice-2.1-Flash 面向高并发、低延迟场景,微软称其在生成最长 45 秒音频的任务中端到端延迟约 150 毫秒,模型推理速度提升 55%,成本较同类模型降低约 60%。定价为每百万字符 15 美元,标准版 MAI-Voice-2.1 为 22 美元;MAI-Transcribe-2-Streaming 年底前的推广价格为每小时音频 0.54 美元。
三款模型均已通过 Microsoft Foundry 等渠道提供,其中 MAI-Transcribe-2-Streaming 的实时 API 目前处于公开预览阶段。
https://microsoft.ai/news/our-first-streaming-transcription-model/
02 有亮点的产品
1、AI 硬件公司 Natura 发布语音智能戒指 Interface:通过语音调用多个 AI 智能体,无需拿出手机即可分配任务
Natura 发布面向 AI 智能体的智能戒指 Interface,将语音输入变成调用不同 AI 智能体的统一入口。用户按住戒指上的按钮即可发出语音指令,通过配套系统 NatureOS 将任务交给 Claude、ChatGPT、Grok 等智能体执行,并在手机或耳机上接收结果。戒指还支持语音笔记、会议录音和健康数据追踪。
一个戒指调用多个 AI 智能体: Interface 内置麦克风和实体按钮,用户可以通过语音指定不同智能体完成编程、行程规划、信息检索等任务。NatureOS 负责连接智能体与应用、管理访问权限,并在执行需要授权的操作前请求用户确认。任务完成后,结果可通过耳机、iPhone 锁屏通知或 NatureOS 应用返回。
语音输入同时用于会议记录与个人记忆: 用户可以双击按钮开始或结束较长时间的录音,将会议内容转换为笔记、决策和待办事项,也可以随时口述想法并保存。戒指采用按键触发录音的方式,不会持续监听;官方标称日常续航为 6–12 天,并支持心率、睡眠和活动监测。
Interface 计划以 99 美元的早期价格推出,预计于 2026 年 12 月至 2027 年 1 月期间发货。目前官网开放候补登记,最终售价和交付时间仍待确认。
https://natura.inc/interface
2、法国儿童 AI 硬件公司 Mallow 推出无屏语音游戏音箱:人类编写剧情,AI 根据儿童语音实时推动游戏
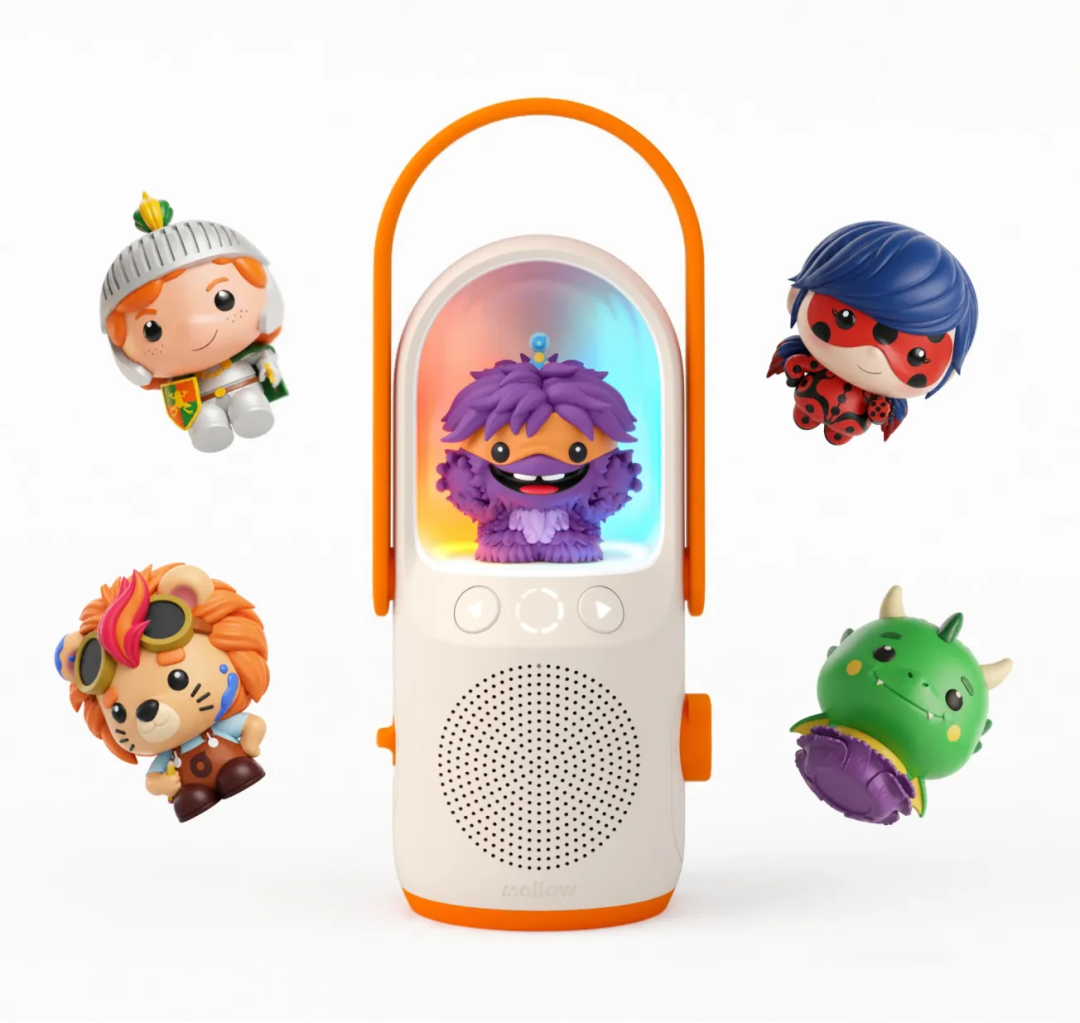
由法国前数字经济国务秘书、Mistral AI 联合创始人 Cédric O 参与创立的 Mallow,推出面向 4–10 岁儿童的无屏 AI 语音游戏音箱。产品将人工编写的故事、游戏规则与生成式 AI 结合,孩子通过语音回答问题、做出选择,AI 则根据回答实时调整剧情和角色反馈。公司同时披露此前完成的 1100 万欧元种子轮融资,投资方包括 General Catalyst 和 Balderton Capital。
语音成为游戏的主要交互方式: 孩子将角色玩偶放在音箱顶部,即可启动冒险故事、生物养成、迷你游戏或知识问答。过程中无需屏幕和手柄,孩子通过语音与角色交流、解谜和完成挑战,系统根据回答动态推进游戏。目前已与 Nathan 旗下科普系列 Kididoc、动画 IP《瓢虫雷迪》合作推出互动内容。
人类负责故事创作,AI 负责受控互动: Mallow 的故事、角色和游戏规则由编剧与游戏设计师预先创作,生成式 AI 在设定好的叙事与规则范围内理解儿童语音、生成回应并调整游戏进程。产品不提供开放式聊天机器人或 AI 陪伴功能,并通过多层安全防护、确定性规则和持续测试限制不适当的互动内容。
Mallow 表示,产品在两年多开发期间邀请超过 300 名儿童及其家庭参与测试,累计完成 6000 多次测试会话、约 900 小时游戏时长。目前已在法国开放预订,音箱含一枚玩偶售价 119.99 欧元,不收取订阅费。
https://mallow.fr/
3、欧洲语音 AI 公司 Deepslate 完成 770 万欧元种子轮:自研 Speech-to-Speech 模型,440ms 响应并支持欧盟本地部署
德国柏林语音 AI 公司 Deepslate 完成 770 万欧元种子轮融资,由 42CAP 领投,Alstin Capital、SIVentures 等参投。公司专注于欧洲语言的端到端 Speech-to-Speech(S2S)模型,直接处理输入音频并生成语音响应,减少传统 ASR → LLM → TTS 串联流程的延迟,同时将数据处理和存储限制在欧盟境内,并提供企业私有化部署方案。
440ms 语音响应,支持 27 种语言: Deepslate 在 Artificial Analysis 评测中取得 440ms 响应时间。模型采用语音编码器、推理核心和语音解码器三部分架构,推理核心基于经过语言专项训练的开放权重 LLM,可以独立替换底层语言模型,而无需重新训练整个系统。
面向欧洲企业的数据主权部署: Deepslate 的模型和推理服务运行于欧盟数据中心,已获得 ISO 27001 认证,企业也可以选择部署在自己的基础设施中。平台提供 API、SDK 和 SIP 接入,已在保险、呼叫中心等场景投入生产使用,API 推广价格为 每分钟 0.02 欧元。
本轮融资将用于扩大欧洲语言训练数据,重点覆盖德国人名、街道名称和方言,同时继续降低模型延迟、改善语音质量,并扩展欧洲数据中心的部署规模。
(@Deepslate)
4、个人 AI 智能体公司 Instinct 完成 10 亿美元 C 轮融资:估值达 100 亿美元,超 50% 交易来自旅行预订,可智能体直接语音致电商家
个人 AI 智能体公司 Instinct 宣布完成 10 亿美元 C 轮融资,投资方包括 Sequoia Capital、Benchmark Capital 和 Coatue,公司估值达到 100 亿美元,较一个月前的 25 亿美元增长 3 倍。Instinct 提供可通过文字和语音交互的个人智能体,能够自主完成旅行预订、购物、订票、取消订阅等任务,并可使用独立电话号码和云电脑执行操作。
旅行预订占平台交易量的 50% 以上: 创始人 Noah Shinn 透露,Instinct 平台的年化交易额正接近 10 亿美元,其中超过一半来自旅行相关交易,主要涉及机票、酒店等预订。该数字为交易总额,并非公司收入,具体统计口径尚未披露。
智能体开始代替用户拨打电话: Instinct 近期推出 Concierge 功能,允许智能体直接致电商家,完成无法在线办理的预约等任务。平台还新增 Trusted Person Network,使不同用户的智能体能够相互协调行程和计划。
Instinct 目前仍采用邀请制,团队仅有 14 名成员。本轮资金将用于扩大产品覆盖范围,并继续开发个人智能体的自主执行能力。
(@Techcrunch)
03 有态度的观点
1、Sam Altman:社会应接受 AI 带来的部分负面事件
OpenAI CEO 萨姆·奥尔特曼近日接受 Politico 播客《Decoded》采访时表示,世界应接受 AI 带来的部分负面事件,以换取技术收益和用户自主权。
他说,OpenAI 与部分更严格的 AI 安全倡导者的分歧之一,是认为社会在探索系统韧性时「一些不好的事情将会发生」,监管应采取更轻的方式。
这段表态是在讨论 OpenAI 与 Anthropic 的 AI 安全路线差异时提出的。奥特曼认为,AI 带来的好处数量级上会超过坏处;纽约大学荣誉教授 Gary Marcus 则批评这套说法把社会风险转成了公司扩张的代价。两种立场都围绕一个问题展开:模型被更广泛开放后,哪些风险可以由社会承担,哪些需要在发布前被挡住。
奥特曼的重点是把监管边界放在系统韧性和用户选择上:如果风险可以被发现、解释并在使用中修复,他倾向于让产品先进入真实环境;如果风险会造成不可逆伤害,则应在发布前设置限制。
Marcus 的反驳则集中在责任归属,认为把「会发生一些坏事」当成创新成本,可能让受影响的人承担本应由公司和监管者承担的损失。
(@APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考