Meta 发布实时数字人 Muse Realtime Avatar,可手持 AI 硬件 Muse Charm丨日报
本期编辑:@三水、@鲍勃
今天日报开头先插播一条:10 月,来北京线下对答案。
当然,答案不一定一样~
这一年,我们在日报里持续关注实时智能正在发生的变化。从国内到海外,从全双工、端到端语音、Voice Agent、实时多模态、世界模型,到新模型发布、开源项目、产品落地和创业融资,很多问题其实一直在反复出现:
全双工到底做到哪一步了?端到端语音会不会替代级联架构?Voice Agent 怎么真正进入生产环境?实时多模态和世界模型接下来又会怎么落地?
这次,我们想把这些问题搬到线下,和大家一起交换答案。
而这次,很多日报里出现过的公司、项目和开发者,也会来到 iRTE 2026 实时智能大会现场。比如有阶跃星辰、Kimi、Minimax、面壁智能、生数科技、模思智能等 AI 模型公司,也有我们此前报道过的 VoiceMem、SGLang-Omni、Breeze-TTS 等开源项目作者或团队参会。当然,这还只是目前提前剧透的一部分,还有一些神秘嘉宾会陆续揭晓~
10 月 23–24 日,大会会有 15+ 个论坛、100+ 场技术分享,从模型、Agent,到 AI 硬件和实时基础设施,把过去一年我们持续关注的很多话题真正聚到一起。
如果你也每天在关注这些,扫描下方二维码报名,来交换一下你的答案。
线上看了一年,这次线下见~
01 有话题的技术
1、端侧 AI 基础模型公司 Edge0 开源原生流式 ASR 模型 Audio8 ASR Infinite:支持 24/7 无限时长转录,滚动 KV Cache 控制长时间运行漂移
Edge0 开源 Audio8 ASR Infinite Preview 版,面向持续监听场景提供原生流式中英文语音识别,可将转录延迟配置在 240–560 ms。模型通过滚动 KV Cache 将上下文窗口持续向前推进,使长时间运行时的显存占用与推理延迟保持在固定范围,可用于 24/7 连续转录。
滚动 KV Cache 支持无限时长音频: 推理端维护约 30 秒的滚动 KV 窗口,并进行 RoPE 位置重映射,不需要随着音频持续输入不断扩大上下文,从而避免长时间转录带来的内存和延迟持续增长。
流式识别最快每 80 ms 做一次解码决策: 模型支持 80 / 120 / 160 ms 三档音频时钟,对应最高每秒 12.5 次文本生成决策,并可在 240–560 ms 范围内调整转录延迟,在响应速度和识别准确率之间取舍。
内置语义 VAD 判断真实对话停顿: 除声音活动外,模型加入语义 VAD,可区分思考停顿、口吃和真正的轮次结束,并分别预测未来 0.5、1、2、3 秒的状态,用于持续监听下的对话边界判断。
基于 Voxtral Realtime 音频编码器和 Qwen2.5-3B 解码器: 模型约 4B 参数,音频部分继承 Voxtral Realtime 4B 架构,文本解码器来自 Qwen2.5-3B-Instruct;官方同时提供适配后的 vLLM 部署方式用于持续流式推理。
https://x.com/SamuelZengML/status/2102726739449332221
https://github.com/Edge0-AI/Audio8-ASR-Infinite
2、Google 发布 Gemini 3.8 Flash TTS 与 Flash-Lite TTS:可从零设计自定义声音,逐行控制表演并稳定生成数小时音频
Google 发布两款新一代 TTS 模型 Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS。Flash 面向高保真语音创作,可通过自然语言从零设计声音角色;Flash-Lite 则面向高吞吐量生成和实时 Voice Agent 级联,两款模型均支持逐行控制语气、节奏和对话表现。
从固定音色扩展到生成式声音设计: Gemini 3.8 Flash TTS 可通过自然语言指定角色、口音和声音特征,从零生成自定义声音,支持 130 种语言;同时提供 2,000+ 个可直接使用的声音,并支持用约 30 秒参考音频复刻声音。
脚本可以逐行控制语音表演: 开发者可分别控制每一句的语气、节奏和表演方式,并在脚本中加入
<laughs>、<sigh>、<gasp>等非语言声音,以及|mhm|、|yeah|等回应声;双人脚本还可直接控制多轮对话和自然轮次切换。长篇生成可维持数小时声音一致性: 模型面向播客、有声读物等长内容优化,可在数小时连续音频中维持音质、节奏和角色音色,减少说话人声音随生成时长发生漂移。
Flash-Lite 接替上一代 Flash TTS Preview: Flash-Lite 支持 101 种语言,主要针对低延迟、高吞吐量和成本敏感的批量配音、朗读及实时 Voice Agent TTS 级联;Flash 则侧重声音设计、复杂多人对话、方言和高表现力内容。
https://x.com/GoogleAI/status/2102781694730285427
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
3、Meta 发布实时数字人模型 Muse Realtime Avatar:与实时语音共享 Token 流生成同步视频,首个音视频响应约 870 ms
Meta 发布实时数字人模型Muse Realtime Avatar,把此前的 Muse Realtime Voice 扩展到实时视频交互:输入一张人物、插画甚至动物或物体图片,即可在持续对话中实时生成与语音同步的面部表情、手势和全身动作。
语音与视频共享同一条 Token 流: Muse Realtime Voice 持续生成包含内容与表达方式的语音 VQ Token,音频解码器将其转成声音,Realtime Avatar 同时读取这组 Token 生成视频,使语音、口型和表情保持同步。
通过因果分块维持长时间连续生成: Avatar 是音频驱动的 Diffusion Transformer,每次生成短视频块,并把最近生成的视频 latent 继续作为下一块的运动上下文,在持续对话中保持角色外观和动作连续。
将每个视频块的推理从 120 次模型计算压缩至 2 次: Meta 使用 self-forcing 与 distribution matching distillation,把需要 40 个扩散步骤和三路 CFG 的教师模型蒸馏为两步学生模型,模型计算次数减少 60 倍。
448×768、25 fps,首个同步音视频响应约 870 ms: Meta 同时重构实时 AI 推理栈,使用持久 KV Cache、缓存感知路由、动态批处理、4-bit 量化感知训练和 CUDA Graph;单张 GB200 可同时运行 12 路视频生成会话,相比两步 BF16 基线提升 8 倍。
https://research.meta.ai/blog/bringing-your-muse-to-life
https://x.com/alex_conneau/status/2102827955588370807
https://techcrunch.com/2025/08/08/meta-acquires-ai-audio-startup-waveforms/
4、AI 模型评测平台 Artificial Analysis 扩展多语言 TTS Arena:新增中文、日语等 9 种语言,分别由母语用户投票生成独立榜单
Artificial Analysis 将 Controlled Voice Arena 扩展到日语、中文、印地语、西班牙语、德语、法语、葡萄牙语、越南语和阿拉伯语 9 种非英语语言,让同一个 TTS 模型可以分别查看不同语言下的真人偏好表现。
每种语言使用统一声音做盲测: 各模型通过声音克隆使用相同的标准男声和女声,测试文本直接由对应语言编写,再由以该语言为母语的用户进行两两偏好投票,减少不同模型自带音色对结果的影响。
9 种语言分别计算 Elo: 不再用一个总分代表模型的多语言能力,每种语言都建立独立排行榜,用于比较发音、节奏、语气和自然度在不同语言中的表现。目前 9 个新榜单已累计超过 10 万次真人偏好投票,每种语言覆盖 15–24 个公开 TTS 模型。
Cartesia Sonic 系列暂居 8 个语言榜首,Inworld Realtime TTS-2 中文第一: Sonic 3.6 在 7 种语言排名第一,Sonic 3.5 位列葡萄牙语第一;中文榜中 Inworld Realtime TTS-2 以 1185 Elo 排名第一,其后是 Sonic 3.6 的 1146 和 StepFun StepAudio 2.5 TTS 的 1130。
https://x.com/ArtificialAnlys/status/2102490340678856997
5、Computer-Use 基础设施团队 Cua 发布多模态决策模型 Cua-S1-4B-0.2:用 RLOO 在实时 GUI 环境训练,直接按任务是否完成给予奖励
Cua 发布 Cua-S1-4B-0.2,将其小型计算机操作决策模型的训练扩展到实时 GUI 环境:模型在真实的多步计算机操作过程中持续选择下一步动作,并根据整个任务最终是否完成获得奖励。团队称其为首个通过 RLOO、以任务完成奖励在实时计算机任务中训练的多模态决策模型。
从单个界面决策扩展到完整任务执行: 训练时模型会进入 Cua-Bench Basic 的实时 GUI 环境,连续观察界面、选择点击或输入等操作,最长执行 20 步,最终由环境自身判断任务是否完成。相比只对静态界面上的正确动作进行监督,这一阶段直接优化完整任务的执行结果。
RLOO 用多次实际执行结果更新策略: 对同一个任务采样多条执行轨迹,以每条轨迹的任务完成奖励与其余轨迹平均奖励之差作为训练信号,同时保留 KL 约束,避免强化学习后的策略过度偏离监督训练得到的初始模型。
文本版在未参与训练的测试任务上成功率达到 94.4%: 在 Cua-Bench Basic 的未训练任务变体上,文本版完成 17/18 个任务,成功率 94.4%;只读取带编号截图、不使用无障碍树的多模态版本完成 13/18 个任务,成功率 72.2%。
基于 Qwen3.5-4B 发布文本与多模态两套适配器: Cua-S1-4B-0.2 在冻结的 Qwen3.5-4B 基座上分别训练文本和多模态 LoRA 适配器,用于读取文本界面状态或截图输入。适配器权重已按 Apache-2.0 协议开放,训练和评测代码同步开源。
https://x.com/trycua/status/2102800643794591833
https://github.com/trycua/cua
02 有亮点的产品
1、Meta 发布个人 AI 智能体硬件 Muse Charm:2 英寸屏幕内置 5G,可直接唤醒 Muse 进行实时语音交互
Meta 在 Connect 2026 发布 Muse Charm,首次为个人 AI 智能体 Muse 推出独立硬件。设备只有手掌大小,配备约 2 英寸 OLED 触摸屏和 5G,可直接唤起 Muse 进行实时语音交互,并在屏幕上显示用户自定义的 Muse 角色。
把 Muse 从 App 搬进一台独立设备: Charm 内置 5G、前后摄像头、麦克风、扬声器、指纹传感器和 USB-C 接口。前后摄像头既可以拍摄照片和视频,也可以把眼前环境交给 Muse 分析;用户可通过指纹解锁后直接开始与 Muse 对话。首次设置和数据同步仍需通过 iPhone 或 Android 上的 Muse App 完成。
Muse 在设备上拥有可持续呈现的角色形象: 屏幕中央显示用户自己的 Muse,可自定义外貌、服装、声音、口音和语速。两台 Muse Charm 靠近时还可以相互识别并让其中的 Muse 进行互动,为个人智能体增加面对面的实体社交入口。
由前苹果设计主管团队 9 个月完成首个版本: Muse Charm 由 Meta 新设计团队与 Superintelligence Labs 共同开发,前苹果界面设计主管 Alan Dye 和 Billy Sorrentino 是主要负责人。项目今年 3 月才启动,内部曾以 Clawmagochi 称呼这一类似电子宠物的原型;Meta 原计划 2027 年上市,Zuckerberg 随后要求提前到 2026 年。CTO Andrew Bosworth 将目前的 Charm 定位为一次探索性的 v0 版本。
Meta 同期扩展整条 AI 硬件产品线: Connect 2026 还发布首款无摄像头纯音频 AI 眼镜 Ray-Ban Meta Audio(349 美元起)、第三代 Ray-Ban Meta Gen 3(449 美元起)、低价款 Meta Adventurer(249 美元起),以及采用眼镜与外置计算模块设计、约 100g 的 Meta VR Glasses(1,299.99 美元,2027 年春季上市);Muse 也将在未来几个月进入 Meta AI 眼镜。
WaveForms AI 创始人 Alexis Conneau 加入 Meta Superintelligence Labs: Conneau 9 月 23 日公开确认 WaveForms AI 已被 Meta 收购,并表示原团队已随他加入 Meta Superintelligence Labs(MSL),双方共同开发的部分成果将在 Meta Connect 展示。TechCrunch 早在 2025 年 8 月报道了这笔收购,当时确认 Conneau 等联合创始人将加入 Meta。 WaveForms AI 于 2024 年创办,主要研发原生音频语言模型,希望实现更自然、实时且能够理解与表达情感的语音交互,此前获得 a16z 领投的 4000 万美元融资。 Conneau 此前曾担任 OpenAI GPT-4o 音频研究负责人,参与 GPT-4o Voice Mode 的研发;目前其公开职位为 Meta Distinguished Scientist。
https://x.com/alex_conneau/status/2102827955588370807
https://techcrunch.com/2025/08/08/meta-acquires-ai-audio-startup-waveforms/
( @Meta)
2、Meta 为个人 AI 智能体 Muse 测试真人电话代理:部分外呼任务交由承包商执行,内部测试已暂时回滚
Meta 正在探索为个人 AI 智能体 Muse 的电话执行能力加入真人代理:当用户让 Muse 完成预约、询价、查询库存等需要拨打商家电话的任务时,系统可以把请求交给经过培训的真人承包商,由人工直接拨打并完成任务。
Muse 的电话任务加入人工执行链路: Meta 上周向约一半员工开放名为 Human Concierge / Human Agent Calls 的内部测试。用户提交任务后,Muse 可以把请求交给真人代理,由其拨打电话并继续处理。
人工外呼可将部分任务成功率提升至 95%–98%: Meta Superintelligence Labs 一名副总裁在内部帖中表示,部分测试显示真人拨打电话的成功率可达到 95%–98%,高于纯 AI 电话的成功率。Reuters 报道称,一些商家在得知来电方是 AI 后会直接挂断电话。
测试目前已回滚: Meta 员工对真人代理可能接触通话中的敏感信息提出隐私与披露问题。Meta 表示此前在缺乏充分披露的情况下启动测试存在问题,目前已暂时回滚该功能,并计划在完善安全、隐私和告知机制后再决定是否公开推出。
https://www.reuters.com/business/meta-testing-human-concierge-its-new-personal-ai-agent-muse-2026-09-22/
3、OPPO 发布可穿戴 AI 硬件「心力球」:9.8g 夹领全天记录,关联长期记忆并主动给出行动建议
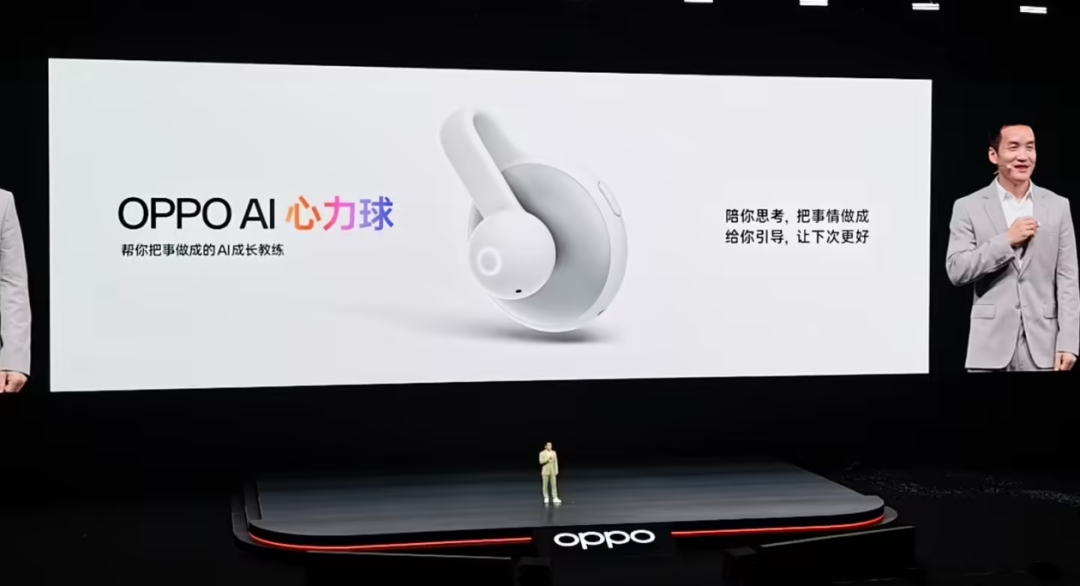
OPPO 发布全新可穿戴 AI 硬件 「AI 心力球」,通过夹在衣领上的 9.8g 设备持续获取日常语音信息,再将会议、对话和临时想法整理并关联到个人记忆中。除了记录和摘要,它还会根据长期积累的信息主动提醒承诺、发现风险,并给出下一步行动建议。
9.8g 设备支持全天持续记录: 心力球支持约 24 小时续航和 5 米远距离收音,用于持续采集工作会议、日常交流和临时想法等信息,减少依赖用户主动拿出手机开始记录。
PersonaX 将碎片信息关联成长期个人记忆: 设备搭载 PersonaX 记忆共生引擎,通过声纹识别、信息关联和记忆演化,把不同时间、不同场景获取的信息持续串联,用于追踪事项和构建个人记忆。
O-Mind 根据记忆主动给出行动建议: 在记录和整理之外,O-Mind 仿生行为深度思考算法会结合此前积累的信息,在关键节点提醒用户过去的承诺、辅助判断,并在事情结束后帮助复盘结果。
开放 MCP 接入外部 AI 工具: 心力球支持接入主流通讯应用,并通过 MCP 连接常用 AI 工具,让持续采集到的个人上下文进一步参与外部工具和服务。
原始录音转写后删除: OPPO 采用私密计算云方案,对数据存储、传输和计算进行加密,并表示低保真音频在完成文字转换后删除,不长期保留用户原始录音。
OPPO AI 心力球先行者体验价 499 元,目前已经开放用户招募,10 月 14 日发放邀请码,10 月 15 日开始提供先行者购买体验。
(@新智独角兽)
4、OpenAI 将 ChatGPT Live 语音接入插件与 Work:可用语音创建文档、操作浏览器,通话结束后任务可转文字继续
OpenAI 更新 ChatGPT Live 语音:Web、iOS 和 Android 现在都可以在实时语音对话中调用账户已有的插件和连接应用;同时语音正式进入 Work,用户可以直接通过说话发起文档、演示文稿、电子表格以及浏览器任务。
实时语音可以直接调用插件和连接应用: Voice 对话现在可以使用账户已经连接、且当前套餐支持的插件与应用,并在聊天界面同步查看文字结果;原有的应用权限和使用限制保持不变。
Work 可以从语音直接启动完整任务: 在 Web 和移动端进入 Work 后,可通过语音要求 ChatGPT 创建文档、演示文稿和电子表格,读取连接应用,或启动浏览器完成多步骤网页操作。
结束语音后,未完成任务可以继续以文字方式执行: 如果 Work 中的任务在语音通话结束时仍未完成,任务可以继续转到文字交互中执行,不需要维持实时语音会话。
https://help.openai.com/en/articles/6825453-chatgpt-release-notes
03 有态度的观点
1、李飞飞:AI 安全不能只由开发者自我评估
World Labs CEO、斯坦福大学教授李飞飞在接受 Bloomberg Technology 采访时表示,开发 AI 系统的公司必须做内部评估,但不能成为唯一的安全裁判。
她所在的 World Labs 会同时测试模型能力和安全性,行业之外还需要独立机构建立基准,验证厂商没有遗漏或淡化的风险。她主张把模型评估做成「生态系统层面的责任」。学术界、公共部门、政府、产业界和民间社会都应参与;开放模型与闭源模型也需要放进同一套可比较的讨论框架。
李飞飞以自己参与创办的斯坦福以人为本人工智能研究院、语言模型研究中心和更早的 ImageNet 为例,说明独立基准可以在产品发布之前形成公共参照。谈到前沿模型的发展速度,她没有接受「失控不可避免」的说法。
她认为,AI 是影响文明的技术,风险最终取决于人类如何使用、共同治理并承担责任。企业继续开发能力的同时,必须把安全和责任放在研发与部署前线,不能把选择交给宿命论。
李飞飞还把这一原则延伸到 World Labs 的空间智能模型 Atlas。Atlas 生成带有几何结构的 3D、4D 环境,可供设计、机器人、医疗和实验室使用;世界模型能够提供机器人训练和评估环境,但若模拟本身缺少可靠验证,也会把偏差带进物理任务。她给出的边界是,人类必须保留对目标、部署和治理的控制权。
无论工具是语言模型、世界模型,还是电力与交通等通用技术,评价标准都应回到人的尊严、能动性和共同责任。
(@APPSO)
04 Real-Time-Demo
1、开发者 Zico 用 Gemini 3.8 Flash TTS + Agora RTC 做了个可实时参与实时 AI 播客:听众可中途插话,两位 AI 主持回应后继续节目
开发者 @zicojzc 做了一个可实时参与的 AI 播客 Demo:房间里的听众同步收听两位 AI 主持生成的节目,也可以在节目过程中直接开口提问;系统识别到插话后暂停原节目,由两位 AI 主持生成并播出回应,再从中断位置继续。Google 最新的 Gemini 3.8 Flash TTS 本身已支持原生双人场景和流式语音生成。
听众从「收听」变成可以直接加入节目: Agora RTC 负责多人实时音频房间,让所有参与者听到同一段节目;听众开口后,语音通过 Gemini 3.5 Transcribe Live 实时转写并进入交互流程。
Gemini 3.8 Flash TTS 直接生成双主持回应: 用户提问后,两位 AI 主持会立即确认插话,再生成双人语音回答;回答播放结束后,原播客继续从此前位置播放。Gemini 3.8 Flash TTS 支持双说话人场景、逐行表演控制和流式语音输出,适合这种动态插入式节目。
基于 Agora RTC + RTM 实现多人实时参与: 同一房间中的参与者收听相同节目,并可以直接通过语音加入对话,zico 表示后续会将项目开源。
https://x.com/zicojzc/status/2102815790542340233
2、开发者 Jay F 开源 Jev 语义 VAD:结合实时转写和对话上下文判断用户是否真的说完,还能区分附和与主动打断
开发者 Jay F 将 TypeSafe AI 的决策模型 Jev 接入 Agora ConvoAI,做了一套客户端语义 VAD。系统不再只根据「沉默了多久」结束用户轮次,而是持续读取实时转写、最近对话和麦克风静音时间,判断用户是在思考、话还没说完,还是已经真正交出话语权。
声学检测负责快速开始收音,Jev 决定什么时候结束: 客户端先通过约 110 ms 的声学门限快速开启用户轮次,随后由 Jev 根据实时转写判断是否结束;Agora 原有的自动轮次检测被关闭,开始说话、结束说话和打断均由客户端主动控制。
一次判断同时处理 4 类语义信号: Jev 会判断用户是否已经说完、是否仍想继续说、当前内容是不是在对 AI 说,以及 AI 正在讲话时用户是真正要打断还是只是说「嗯嗯」「对」等附和词。因此像犹豫、长停顿、未说完的句子和旁人对话不会仅因为出现静音就立即触发回复。
主动打断与附和可以走不同处理路径: AI 说话时,声学检测只先开启转写,不立即停掉 AI;当文字出现后,Jev 再判断用户是否真的要抢过话语权。仓库实测中,「uh-huh」会继续让 AI 说,而后续出现「wait」时才触发打断。
单次 Jev 判断约 275–300 ms: 当前实现会随着转写变化和静音状态重复判断,每个用户轮次通常调用 3–6 次 Jev。项目代码已经以 MIT 协议开源。
https://x.com/SoCalJayF/status/2103002322175668313
https://github.com/AgoraIO-Community/convoai-jev-vad
05 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、 社区活动推荐|2026 硬件黑客松「极客营」
如果你不满足于让 AI 只停留在屏幕和软件里,想真正把模型、芯片、传感器和执行器组装成一个「能感知、会行动」的实体,可以关注下今年的深圳科创学院 极客营。
本届硬件黑客松以 Negentropy「熵减」 为主题,计划招募 100 位 Builder,在 5 天时间里围绕硬件架构、资源控制与软硬件协同动手创造。从一堆元器件、芯片和代码出发,最终做出真正可以运行的硬件作品。
活动还开放了创业团队直通通道,面试通过后有机会加入深圳科创学院在孵团队;营期提供实验室、零部件、样机补贴、住宿及国内往返交通等支持。
 12 月 2 日–6 日
 深圳科创学院(南山总部)
正在做 AI 硬件、机器人、具身智能、端侧 AI,或者单纯想狠狠干几天硬件的朋友,可以报名试试。
当世界走向熵增,硬件黑客松要逆行创新 | 2026 极客营招募启动
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考