把 Voice Agent 真正推向生产环境,这些一线开发者踩过这些坑|iRTE 2026 大会「RTE 101 技术专场」回顾
和语音 AI 聊上几句的 demo,现在一个下午就能做出来。Coding agent 帮忙写代码,模型厂商在降价提速,接入步骤也有了现成的工具。可要把 demo 变成用户每天会用的产品,问题会一个接一个冒出来。弱网下用户的话能不能完整送到 AI,电话为什么接通了却没有声音,硬件上的麦克风为什么一直在响,几个 agent 同时干活时人怎么管得过来。
10 月 23 日,iRTE 2026 大会「101 技术专场」上,RTE 开发者社区布道师白宦成、声网 SDK 资深架构师章真、RustPBX 项目发起人沈金堤、灵析启智 AI 学伴台灯负责人庄鲁、软件工程师、AI 自媒体作者海拉鲁编程客、Agora 开发者产品体验经理焦智超,从行业复盘、音频传输、电话接入、语音硬件、Agent 编排到 demo 创作,分享了各自的实践。
圆桌环节,OceanBase 技术专家汤庆加入讨论,几位嘉宾聊了踩过的坑、模型进步后的技术选择,以及给新手开发者的建议。
白宦成|Voice Agent 生产落地:三年复盘、市场现实与未来新可能
2024 年 GPT-4o 发布,很多开发者第一次意识到,和大模型交互可以不只靠打字。RTE 开发者社区布道师白宦成从那时讲起。随后开放的 Realtime API 按分钟计费,开发者一算账就犯了难。ASR、TTS 按万字计费,大模型按百万 token 计费,都不算贵,换成按分钟算,什么样的业务才用得起?
他把这三年开发者对端到端模型的信心比作一条曲线。2024 年看完发布会,大家很快冲上「愚昧之巅」,觉得这就是未来。拿去找场景落地,才发现稍微复杂一点的业务就贵,工具也调不动,于是又回头把级联做好。到 2025 年,行业的共识仍是级联,成本好算,流程好控制,端到端被看作做 demo 可以、上生产账算不过来的方案。
这一年情况变了。各家端到端模型陆续支持了工具调用、并行调用、推理强度控制和音色复刻,价格也在下降,开发者吐槽过的问题解决得比预想快。白宦成拿出去年在同一个会场发布的《对话式 AI 好奇者手册》,逐项对照这一年的变化。ASR 开始结合语义判断打断,大模型能直接输出语音。噪音和回声不再是主要难点,他提到有团队反而会给回复加一点背景声,声音太干净,用户一听就知道是 AI。TTS 去年每万字要五到八元,今年商业服务也接近一元。人没变,对延迟的感知仍在 200 毫秒左右,打断、方言和小语种依然难。
分享最后,他提到两个值得关注的方向:
一类是 System 1 模型。人解决问题也不全靠高智能,还要靠反应神经,语音交互里大量对时延敏感的小决策,正适合交给这类模型。
另一类是 proactive agent。在文本世界,一台电脑上 7×24 小时替自己干活的 agent 已经是很多人的默认选项,语音里还没有出现同样的东西。
章真|AIQoS:让语音 AI 对话更流畅
2024 年 GPT-4o 推出后,章真所在的团队就一直在讨论一个问题,人和人之间的实时传输,与人和 AI 之间的传输,到底有什么不同。他们给出的答案是 AIQoS,一套专为人和 AI 对话设计的音频传输优化。
人和人打电话时,网络偶尔丢一小段声音,系统会顺着前后的声音猜着补上,人耳几乎听不出来。可听的一方换成 AI,猜出来的那一段很可能被听成杂音或错字。AI 又不像人那样等不起,所以 AIQoS 改成先等丢掉的那段补发回来,凑齐了再交给 AI;等待也有上限,实在等不到才退而求其次。章真的说法是,宁可让 AI 晚一点听到原话,也别让它及时听到一段被补过的声音。
反过来,AI 生成语音比人说话快好几倍。过去这些语音也要按说话的速度一点点发出去,网络一抖,用户就会听到卡顿。AIQoS 让生成好的语音尽早发到用户手机上先存着,手机里攒了一段,中间网络断一下也能接着播,用户听到的始终是正常语速,开口也更快。
提前送到也带来新问题。用户说一句“等一下,我想换个问题”,手机里还存着一大段旧回答,不处理的话,AI 会自顾自地继续说下去。因此打断时要把还没播的旧内容立刻清掉,收尾时再轻轻淡出,避免“啪”的一声。
此外,音频早早到了手机上,也不代表用户已经听完。AIQoS 在音频里打上结束标记,手机播到那里才算这一轮说完,业务再据此切回“听”的状态,对齐字幕。针对内存和电量有限的小设备,团队还控制了发送节奏,设备不说话时就停发数据,同时把刚开口的那一小段先存下来再发,保证一句话的开头不丢。
总而言之,AI 听可以等,AI 说可以早送。AIQoS 就是按这两点,把原本为人和人通话设计的传输改了一遍。
沈金堤|用 SIP 连接 Voice Agent 与电话
RustPBX 项目发起人沈金堤做电话系统二十多年了。这次他讲的是很多 voice agent 团队迟早会碰上的问题,怎么让 AI 接打真实的电话。App 和浏览器里的语音对话有很多技术可选,可一旦要接运营商线路和呼叫中心,就只剩 SIP 这一套老牌电话协议。他和团队用 Rust 把这套电话系统从头重写了一遍,下面这些坑都是实际项目里踩出来的。
最常见的情况是电话接通了,却没有声音。打电话前双方要先“打招呼”,商量好怎么传声音,很多开发者以为招呼打完就能说话,其实还差最后一步确认。AI 开口的时机也有讲究。接通前会先放彩铃,AI 要等真正接到人才开口,时机没掐准,用户开头的几个字就丢了。还有一些细节容易被忽视,比如消息里塞了太多自定义内容,内网测试好好的,一接运营商就发不出去。
电话线路本身的条件也和网络通话不一样。国内运营商线路基本只支持几种老式的窄带音质,前面在音质上下的功夫,到了电话这一段都要打折扣。很多来电接通时,用户会先听到一句“某某平台为您服务”,这段播报是运营商插进来的,插完之后声音换了一条新的通道。如果 AI 只认第一条,播报一结束就再也听不到用户了,看起来像是大面积丢包,其实声音都到了。
他最看重的指标之一是转人工。AI 处理不了时要把电话转给人工客服,而呼叫中心只认电话协议这一套。转接后,声音要按严格的节奏一帧帧发出去,所以他建议处理音频的服务尽量避开 Java、Go 这类会周期性停下来回收内存的语言,早高峰一卡,用户就会听到杂音。电话按分钟收费,一通电话因为卡顿丢了,损失的是一个潜在客户。转接时还要把之前的对话一起带过去,让坐席知道这个人刚才说了什么。
总而言之,让 AI 接电话,难点在电话本身。接通、彩铃、插播、转人工,这些老电话系统里的细节一个个处理到位,AI 才能好好打电话。
庄鲁|让台灯说个话:语音 AI 硬件踩坑记
灵析启智 AI 学伴台灯负责人庄鲁在教育领域做研究。他看到的问题很具体。孩子用手机和平板容易分心,用 AI 讲题还得拿起手机拍照,他形容这像把发动机装在马车上。他想做一盏懂教育、能陪孩子写作业的台灯,台灯本来就天天摆在书桌上。
硬件选型走了三步。树莓派上很快跑通了 demo,但一套成本太高,量产用不起。ESP32 便宜得多,团队在上面花了不少钱验证,可为了看清作业接上高清摄像头后,传输延迟很大,算上摄像头,成本优势也没剩多少。最后他们定了安卓主板。架构上,他体验过端到端模型能唱歌、能变语气的惊艳效果,最后还是选了级联,因为学伴要根据孩子卡在哪里决定启发、提问还是引导,需要自己编排回复策略。通信用 WebSocket,原因很现实,愿意接小订单的主板厂商只支持这一套。
联调时,识别不准、判停延迟、首字被吞、误打断一起冒了出来。团队换过 ASR 服务,调过 VAD,最后靠原始录音定位到原因,麦克风离主板上某个元器件太近,一直有低频的嗡嗡声。一个看似很小的问题,前后折腾了半个多月。第一代台灯只有一个麦克风,做全双工时回声消除搞不定,第二代改成了双麦。家里有人外放抖音时 VAD 一直不停,他们又加了防噪模式。
量产的教训更贵。一批上千台的台灯运到,有一小部分屏幕排线松脱。内存涨价让主板报价几乎翻倍,原定的售价也只能跟着往上提。他的建议是打样后别急着开模,拿样机在真实场景用一两个月。被投资人问到壁垒,他的回答是把需求挖深,在真实场景里一次次适配,壁垒就是这样做出来的。
海拉鲁编程客|给代码农场雇个语音 Agent 管家
软件工程师海拉鲁编程客平时会在终端里同时开好几个 coding agent,前端、后端和 bug 修复一起推进。写前端时要改文档,改后端时又要钻进某个很细的模块,上下文来回切,人得一直盯着。他想要一个管家替他管这些 agent,管家负责传球,他负责最后投篮。
他把这个想法做成了开源小游戏 VibeValley。每块地对应一张工单,庄稼长势就是进度。Agent 在干活时地里有帮工,等他验收时菜就熟了,出了意外,管家会直接打电话过来。管家的设定参照贾维斯和阿福,他不用盯着终端,开口就能问到农场里大部分的情况。
搭这个管家分三步,听得懂、派得动、记得住。他手搓过语音识别、大模型和语音合成这几个模块,原以为 POC 很快就能写完,结果光优化就拖了几个月,后来直接通过 Agora Skills 接入声网的对话式 AI 引擎。接通之后他对管家说,登录页一刷新就报错,让前端阿郑来看看,大模型反问他阿郑是谁。它有脑子,没有手,也不认识他的团队。他保留声网标准的输入输出协议,在大模型这一层加了一层 harness,给管家喂进项目现状、个人偏好和工单体系,让它能调度 Claude Code、Codex 和 Kimi Code 去干活。
记得住,解决的是反复介绍自己的问题。同一套偏好和项目约定,他不想跟 Claude Code 说一遍,再跟 Codex 说一遍。VibeValley 目前用本地 markdown 存记忆,再分发给各个 agent。
焦智超|从零到一构建一个爆款 Voice Agent Demo
有了搭 voice agent 的能力以后,怎样找到值得做的场景?客服、陪伴、教育、会议都已经有人做,Agora 开发者产品体验经理焦智超更想做点市面上没有的东西。他做过的 demo 视频里,有好几条在 X 上的播放都过了十万。团队从这些经验里总结了三种思路。
第一种是追热点。今年 Three.js 的 npm 下载量增长很快,不少没写过代码的人也在用 Vibe Coding 做 3D 项目。有一个人体器官 3D 模型在 X 上很火,却只能用鼠标拖拽。他给它接上 voice agent,用户问肝脏有哪些部分,agent 一边讲,一边通过 MCP 把视角转到对应的部位。这条 demo 视频在 X 上的播放量达到 15.3 万。他还用 Three.js 做了一个密室游戏,玩家拨动老式转盘电话打给 NPC,靠对话套出保险箱密码,每个人聊出来的走向都可能不一样。世界杯期间,他让视觉语言模型看懂比赛画面,配上足球解说的音色做 AI 解说。
第二种是用新模型的新特性。GPT-Live-1 支持全双工,他就把 AI 拉进会议,让它作为一名参会者参与讨论,会上直接把任务卡片挪到进行中。流式 TTS 模型发布后,他做了一个双人 AI 播客,基于声网 RTC 做成直播语音房,有点像 AI 版的 Clubhouse,听众可以举手打断提问,AI 答完再接回原来的话题。
第三种是改造已有的场景。小时候玩拳皇,大招都是固定的。在他做的格斗游戏里,能量蓄满后玩家说一句「召唤一只火龙」,视频模型就把火龙实时生成出来。他还做了「你画 AI 猜」,AI 猜对了还不算,得用视频把答案生成出来才行。他建议开发者先在 Agora Recipes 找场景相近的开源 demo,再用 Agora Skills 做二次开发。
圆桌|从 demo 到上线,开发者怎么做取舍?
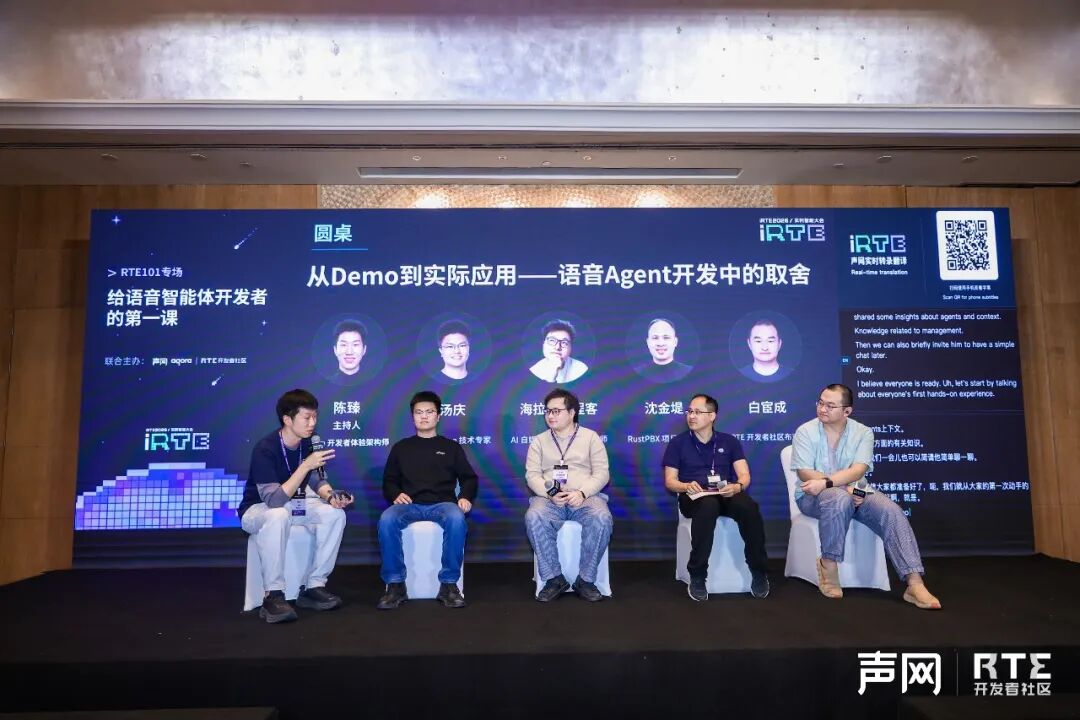
六场分享之后,专场主持人陈臻与白宦成、沈金堤、海拉鲁编程客、OceanBase 技术专家汤庆一起,聊了各自项目里的技术取舍、模型进步带来的变化,以及开发者该怎么选工具。
第一次动手做项目,踩过哪些坑?
白宦成两年前做过一个会议 copilot,要把 AI 嫁接到别人的会议系统里。只拿发言人的麦克风不够,还得拿到对方的音频流,才有完整的声音场景。最痛苦的是早期的声网的 Python SDK 能用,文档不全,调试一个功能只能一行行读代码。他觉得现在门槛低了很多,agent 能把代码和文档都读进去,skill 也把常见的坑提前收好了。陈臻补充,过去的开发工具常缺少场景说明,什么时候初始化、什么时候接降噪插件、什么时候开始推流,这些时序很少有人讲清楚。
沈金堤讲了一个外包原型项目。客户要求照着一个流行的开源框架搭架构,音频处理和大模型处理放在同一条 pipeline、同一个状态机里。他自己懂声学还能撑住,交给团队的工程师就是灾难,他们不理解音频为什么一点延迟都不能有。团队后来又花了几个月,才把两部分彻底拆开。那套架构是为三段式设计的,现在客户希望改成面向 realtime 模型,他承认当时眼光太保守了。
汤庆的团队做了很多年数据库。差不多两年前,他们尝试做 multi-agent,当时主流方案是 Dify 这类编排工具,用固定流程约束模型不跑偏。受限于当时的模型能力,multi-agent 的效果和编排流程差距不小。做了一段时间,他们发现最要紧的是上下文,后来才陆续做了 RAG、记忆和现在的 PowerContext。
模型进步以后,开发者的选择会怎么变?
汤庆觉得开发范式整个变了。以前说 show me your code,代码最值钱;现在代码大多是 AI 生成的,想法和产品感觉反倒更值钱。海拉鲁编程客形容,以前写代码像一步步往前走,现在像几个 agent 陪着你跳着走。过去验证一个 POC 要好几天,现在开三个 agent、三个 worktree 并行验证,不行就删,删掉也不心疼。
沈金堤说,客户大多还在用三段式,电话业务对可控性要求太高。有客户测试时让 agent 背九九乘法表,有的 realtime 模型真就背出来了。他认为端到端是未来,三段式拿不到语速和情绪,只能一层层打补丁。
眼下端到端最难的是确认类信息,手机号、身份证号、车牌号,用户报完要求复述一遍,端到端模型基本都处理不好。
白宦成提醒大家看看三年里没变的东西。对信息的管理一直都在,只是难度变了。从三段式迁到端到端时,如果当初没把原始业务数据留下来,就没法验证新方案能不能把业务做好。人对 agent 的期待也没变,记得我、反应快、理解我。他建议对模型公司保持期待,同时守住业务数据和行业理解。三百六十行,模型公司能搞明白两三行就很不错了。
工具和框架越来越多,应该怎么选?
白宦成建议长期项目选相对枯燥、老派的方案。新奇的技术适合做 demo,进了真实业务,出了问题人和 agent 都找不到资料。真要用新东西,至少要知道它适合什么、坑在哪里。
沈金堤自己更爱用新东西,但他把排障放在第一位。语音业务一通电话的日志就很多,每个步骤和状态变化都要记全。排查时也别把海量日志直接丢给大模型,先截一小段,让它照着写个分析工具,再用工具跑全量、出报表,又快又省 token。海拉鲁编程客则建议舍得用好一点的模型,并且先想清楚怎么验收。
汤庆挑开源项目时会看社区是否活跃,做 To B 时也看有没有大客户案例。说到上下文,他说提示词工程、上下文工程、harness 工程,名字一直在换,做的都是把合适的上下文交给模型。信息越堆越多,就得做熵减,从原子记忆提炼出经验,再从经验生成 skill。一个人离职了,他的经验还以 skill 的形式留在团队里。
给新手开发者一条建议
白宦成和沈金堤的建议都偏向先打基础。白宦成推荐读一读《对话式 AI 好奇者手册》,看不懂也不要紧,过一遍就知道做 voice agent 会碰到哪些技术关键词,遇到问题时能按图索骥。沈金堤建议花一两天补声学基础,弄清声音怎么采集、编码和传输,再用 skill 搭个 demo,抓包看看报文怎么流转。客户说卡顿时,懂这些的人会多问一句,是哪种卡顿。
海拉鲁编程客更相信边做边学,先把 skills 装上跑起来,再回头补概念。汤庆提醒多关注数据层,agent 框架会换来换去,数据会一直留下来。陈臻最后补了一条,项目一开始就把监控和指标建好。现在代码大多由 agent 写,出了问题,也得靠这些指标才能问清楚。
延伸阅读:
《对话式 AI 好奇者手册》:
https://www.rtecommunity.dev/conversational-ai-for-the-curious/
Agora 实时互动 AI 开发工具包:
https://docs.agora.io/en/introduction/start-with-ai#agora-ai-developer-toolkit
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么