模思智能完成超 10 亿元 Pre-A轮融资,将推出全模态实时交互系统 MOSS Live丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、世界模型公司 Odyssey 开放 14B 实时交互世界模型 Odyssey-3:支持实时探索生成场景,免费公众预览已上线
世界模型公司 Odyssey 开放 Odyssey-3 的免费公众研究预览。这是一款拥有 14B 参数的实时交互世界模型,可以根据文本提示生成可探索的虚拟环境,并在用户移动、切换视角或触发事件时,持续预测和生成后续画面。此次开放的是 Odyssey-3 Flash 在线体验版本,开发者可另外申请 API 接入。
实时生成可交互的虚拟世界: 用户可以通过文本描述创建场景,以第一人称或第三人称视角在生成环境中移动,也可以独立控制摄像机、触发事件。模型根据此前画面与当前操作持续更新环境,无需预先生成完整视频。Odyssey-3 基础版输出分辨率为 832×480,Pro 版本支持 1280×720。
采用自回归扩散 Transformer 架构: 模型结合互联网视频、带有键盘鼠标操作记录的游戏视频,以及模拟物理交互数据进行训练。通过自回归生成预测后续环境状态,并利用分布匹配与对抗蒸馏减少扩散生成步数,实现实时交互。
探索世界模型在机器人控制中的应用: Odyssey 展示了利用模型学习的环境表征,训练机械臂、人形机器人和自动驾驶车辆控制策略的实验。官方还公布了物理规律理解评测结果:Odyssey-3 Pro 在 Physics-IQ Verified 视频续生成测试中,采用每题 8 次生成选优的方式获得 66.1 分。相关机器人控制能力目前属于研究演示,尚未包含在公众预览中。
Odyssey-3 目前开放浏览器在线体验,模型权重尚未开源,面向机器人、自动驾驶等领域的开发者可联系官方申请接入。
https://odyssey.systems/meet-odyssey-3
2、全双工语音加速框架 DiffuPlex:滚动掩码扩散减少逐帧推理,运行速度提升最高 1.59 倍
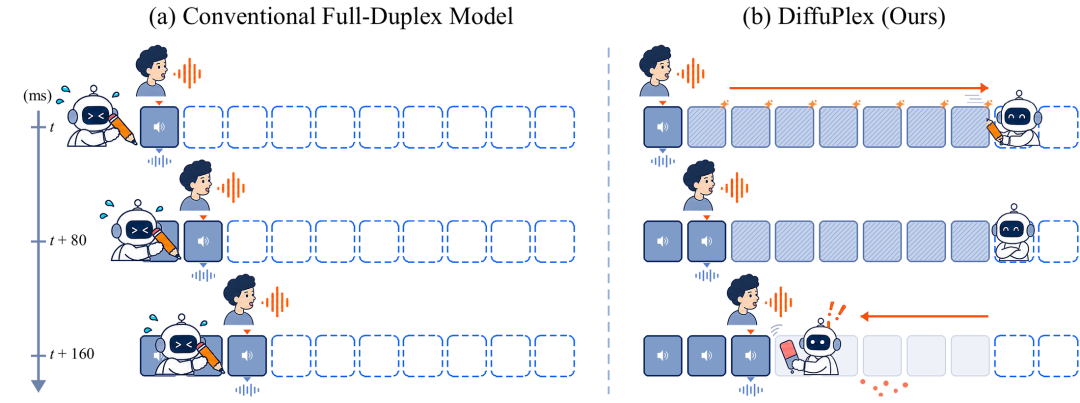
研究者 Heeseung Kim 提出全双工语音对话加速框架 DiffuPlex,通过滚动掩码扩散技术,在单次模型计算中同时预测多个未来的用户与 AI 语音帧,减少传统自回归模型逐帧推理带来的计算开销。在保持 80ms 语音交互帧间隔的条件下,DiffuPlex 实现最高 1.59 倍部署运行速度提升,同时保留实时打断、轮次切换等全双工交互能力。
一次预测多个未来语音帧: 传统全双工模型需要每隔 80ms 执行一次主干网络计算。DiffuPlex 使用掩码扩散同时预测未来多个用户和 AI 语音帧,只采用置信度足够高的连续预测结果。随着真实用户语音到达,系统会与预测内容进行比较,发生偏差时保留已经播放的 AI 语音,仅重新生成尚未播放的部分。
两种推理策略平衡速度与语音质量: DiffuPlex-LISTEN 主要跳过预测为 AI 静音的语音帧,部署运行速度提升 1.46 倍,核心语言模型计算提速 1.61 倍;DiffuPlex-SPEAK 进一步复用预测的 AI 语音帧,分别提升 1.59 倍和 1.80 倍。测试中所有主干网络调用均在 80ms 交互间隔内完成。
人类评测验证对话质量: LISTEN 模式的语音自然度和对话质量与原始模型基本持平;SPEAK 模式保持了接近原模型的对话质量,但语音自然度有所下降。实验表明,可以通过减少连续主干网络计算,在基本维持全双工交互行为的同时降低推理开销。
https://diffuplex.github.io/
3、研究团队 PhAI Labs 开源世界模型自我改进框架 RSI-Anything:代码修复成功率从 26.3% 提升至 31.2%,GUI 操作减少 39.4%
研究团队 PhAI Labs 发布并开源 RSI-Anything,一种基于 JEPA-Anything 的递归自我改进框架。它利用世界模型预测不同操作可能产生的结果,筛选值得实际执行的方案,再根据真实反馈更新智能体策略或工作流程,并在必要时调整世界模型。经过验证的改进会保留到下一轮任务中,使智能体能够持续利用此前积累的经验。
通过世界模型预测结果,筛选行动并改进策略: RSI-Anything 将候选方案生成、结果预测、行动选择、外部验证和学习更新整合为循环。系统优先测试世界模型预测效果较好的方案,再利用执行反馈改进策略;当世界模型的预测不再可靠时,也会对其进行更新。只有通过性能和兼容性检查的更新才会进入下一轮。
代码修复成功率从 26.3% 提升至 31.2%: 在保持 ReasonFlux-Coder-7B 编码模型不变的条件下,CodeContests 测试中,静态验证方案的成功率为 26.3%,引入世界模型预测筛选后提升至 29.2%,进一步利用执行反馈更新世界模型后达到 31.2%,在线测试调用次数基本相当。
GUI 智能体完成任务所需操作减少 39.4%: 在 MiniWoB++ 复选框操作任务中,经过多轮改进,任务成功率从 51% 提升至 99%,平均操作次数从 5.30 次降至 3.21 次。在 OSWorld 桌面任务评测中,成功率相较初始智能体提高 18.4%(相对增幅)。
扩展至实验室规划与化学反应优化: 在 LabHorizon 实验室规划评测中,经过五个连续策略版本的改进,规划得分从 21.80% 提升至 46.01%。在 Suzuki–Miyaura 化学反应优化实验中,使用相同的 40 次实验预算,RSI-Anything 获得的平均最佳反应产率为 96.15%,高于贝叶斯优化方法的 82.16%。
目前 RSI-Anything 已开放论文、代码及实验资源,涵盖代码修复、GUI 交互、实验室规划和反应优化等任务。
https://phai-labs.com/papers/rsi-anything/
4、香港科技大学、音频 AI 公司 Noiz 等开源世界模型音频生成框架 WorldSonus:100ms 流式生成立体声,支持实时调整音效与空间对齐
香港科技大学、Noiz AI、MetaX 和上海交通大学的研究者联合提出并开源 WorldSonus,一种面向世界模型的实时交互式视频转音频框架。它可以根据持续生成的视频画面同步合成空间立体声,并在生成过程中响应新的声音指令,让环境音效随场景变化和摄像机移动实时更新。在单张 NVIDIA H100 GPU 上,模型生成 100ms 音频片段平均耗时 41.2ms,实时因子(RTF)为 0.41。
100ms 分块流式生成,无需等待完整视频: WorldSonus 采用流式因果自回归扩散架构,每接收 30fps 视频中的 3 帧画面,即生成对应的 100ms、48kHz 立体声音频。模型通过循环缓存保留最近 5 秒的音视频上下文,使其能够持续生成音频,而无需重新处理完整历史序列。
支持在生成过程中动态修改声音指令: 框架引入以音频为中心的描述生成机制,将声音事件与时间片段建立对应关系,并通过按片段索引调度提示词。用户可以在视频播放过程中调整声音内容,新指令从下一个 100ms 音频片段开始生效,已经生成的音频无需重新计算。
生成音效随画面运动和摄像机视角变化: WorldSonus 利用视频帧特征、帧间运动信息和空间立体声监督,让声音事件与画面中的动作及空间位置保持一致。训练使用约 1465 小时音频数据,包括 999 小时立体声视频数据和 466 小时纯音频数据,并结合真实立体声录音与全景声素材构建空间音频训练数据。
音质与空间对齐效果达到双向生成模型水平: 研究在开放领域视频转音频基准上进行评估,结果显示,WorldSonus 在声音质量和空间对齐方面达到或超过部分先进双向生成模型,同时具备因果流式生成能力。训练中还引入音画同步约束,改善声音事件与画面动作的时间对齐。
目前 WorldSonus 已开放论文、推理代码和模型权重,支持开发者使用 CUDA GPU 在本地运行。项目采用 CC BY-NC 4.0 许可证,仅允许非商业用途;当前尚未集成至 Noiz Studio,公开代码的实际推理延迟也可能因硬件和运行环境而有所不同。
https://noizai.github.io/WorldSonus/
02 有亮点的产品
1、多模态大模型公司模思智能完成超 10 亿元 Pre-A 轮融资:即将推出全模态实时交互系统 MOSS Live
10 月 12 日,模思智能宣布完成超 10 亿元 Pre-A 轮融资,由华控基金领投,国开科创、上海科创基金、新微资本、徐汇资本等参投,元禾控股、上海科创集团等老股东继续投资。本轮资金将用于全模态实时交互智能的研发与全球商业化落地。公司同时披露即将发布的实时交互系统 MOSS Live,通过前端交互模型与后端任务执行模型协同,让 AI 在持续理解语音、视频和环境信息的同时,处理复杂推理与任务。
MOSS Live 采用前后台协同架构,支持实时交互与任务并行: 即将发布的系统由前端交互模型负责持续感知、理解和语音交流,后端能动性模型负责复杂推理、工具调用和任务执行。两者通过记忆、上下文和任务状态管理协同,使 AI 能够在执行任务期间继续与用户交流,并根据新的语音、画面和环境信息调整交互过程。目前 MOSS Live 尚未正式发布,具体延迟和部署方式仍待公布。
已有模型覆盖语音、视觉和音视频生成: 模思智能已发布 MOSS-Audio 音频理解模型、MOSS-Transcribe-Diarize 语音识别与说话人分离模型、MOSS-VL 视觉理解模型、MOSS-TTS 语音合成模型,以及 MOVA 音视频生成模型等。2026 年以来,团队已围绕语音、视觉和实时多模态连续发布 20 多个模型,为全模态实时交互系统提供感知与生成能力。
推进 AI for AI,实现模型间协同生产和筛选训练数据: 模思智能计划利用生成模型生产语音、图像、视频及场景数据,再由理解模型完成质量判断、筛选和反馈,并将结果用于下一轮训练。同时,随着交互系统进入 AI 眼镜、汽车、家庭终端和机器人等设备,公司希望利用真实场景中的连续交互数据,进一步改善模型对环境与用户意图的理解。
模思智能于 2024 年底孵化自复旦大学邱锡鹏教授带领的 OpenMOSS 团队。邱锡鹏担任公司创始人兼首席科学家,团队此前参与 MOSS、SpeechGPT、AnyGPT 等语言、语音及多模态模型研究。
(@模思智能)
2、xAI 开发者 Evan Bacon 演示 Grok Bot 自主开发 Apple Vision Pro 应用:可将语音交互机器人放置在真实空间中
10 月 12 日,xAI 开发者、Expo Router 作者 Evan Bacon 展示了一款由 Grok Bot 辅助开发的 Apple Vision Pro 空间交互应用。他要求 Grok Bot 为自己构建一款 visionOS 应用,最终实现将多个虚拟机器人放置在公寓的真实空间中,并直接通过语音与它们交流。Evan Bacon 随后公开了用于构建该应用的 Vision Pro Bot,供其他开发者尝试。
将 AI 机器人从聊天窗口带入空间环境: 演示中,多个不同颜色和形态的虚拟机器人可以放置在房间不同位置,用户通过 Apple Vision Pro 查看这些机器人,并与它们进行语音交流,实现结合空间显示与对话式 AI 的交互体验。
Grok Bot 可参与原生 visionOS 应用开发: Evan Bacon 分享的 Vision Pro Bot 配置支持使用 SwiftUI 和 RealityKit 开发空间应用,并通过连接的 Mac 调用 Xcode、visionOS 模拟器等工具完成构建与测试,还可将应用安装到 Apple Vision Pro 设备上。
https://x.com/Baconbrix/status/2109406594241060901
3、Google DeepMind 向全球公众开放 AI 内容检测工具 SynthID Detector:支持图片、视频和音频水印检测,覆盖 OpenAI、NVIDIA 等合作伙伴
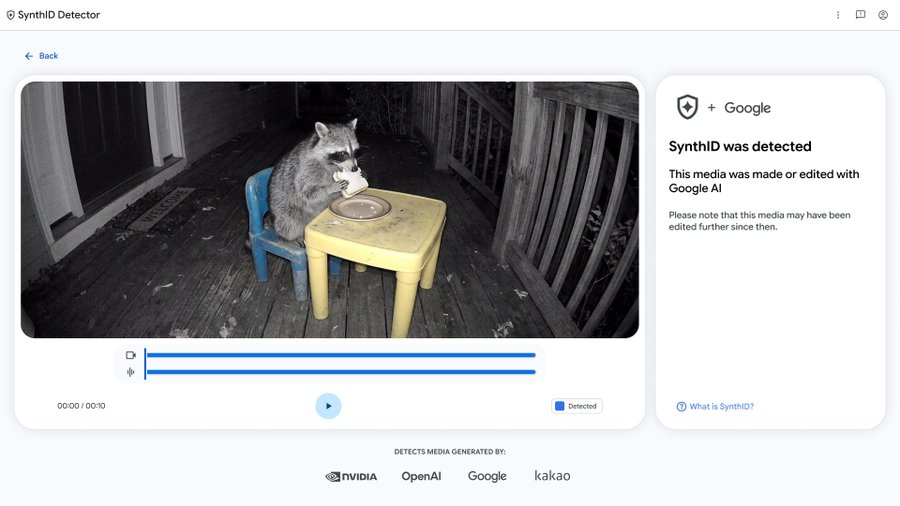
10 月 7 日,Google DeepMind 宣布将 AI 内容验证工具 SynthID Detector 从此前面向媒体专业人士的有限测试扩大至全球公众,用户可通过 synthid.com 免费上传图片、视频或音频文件,检测其中是否包含 SynthID 隐形数字水印。新版检测范围同时扩展至 OpenAI、NVIDIA、Kakao 等合作伙伴的 AI 生成内容,目前已在全球开放英文版本。
统一检测图片、视频和音频中的 AI 水印: 用户上传媒体文件后,SynthID Detector 会扫描其中嵌入的不可见水印,帮助判断内容是否由支持 SynthID 的 AI 系统生成或修改。水印直接嵌入图像像素、视频画面或音频信号中,经过常见的裁剪、压缩等处理后仍具有一定可检测性。
从 Google 自有模型扩展至跨厂商内容验证: SynthID 最初主要用于 Gemini、Imagen、Veo、Lyria 等 Google AI 产品。此次公开版本进一步支持 OpenAI、NVIDIA 和 Kakao 等合作伙伴的水印,苹果也计划加入。用户可以通过统一入口检查不同厂商生成的内容,无需分别使用各家的验证工具。
已覆盖超 1800 亿份视觉内容和 24 万年音频: Google 披露,自 2023 年推出 SynthID 以来,已为超过 1800 亿张图片及视频添加水印,音频水印覆盖的内容时长累计相当于 24 万年。此外,Google 搜索、Gemini 和 Chrome 内置的内容验证功能目前每天处理超过 100 万次检测请求。
SynthID Detector 仅能识别已嵌入相应水印的内容,未检测到水印不代表内容一定由人类创作,也无法覆盖所有 AI 生成模型。
https://synthid.com/
03 有态度的观点
1、PolyAI CTO Shawn Wen:语音 AI 尚未迎来自己的「ChatGPT 时刻」,全双工之后仍需突破推理速度瓶颈
企业语音 AI 平台 PolyAI 首席技术官 Shawn Wen 近日在 HumanX 大会上表示,尽管语音 AI 已经取得显著进展,甚至出现了能够同时听取用户讲话并生成语音回应的全双工模型,但整个行业仍未迎来类似 ChatGPT 发布时的突破性时刻。
Wen 认为,全双工模型的出现是一个重要技术里程碑,但下一阶段的核心挑战是让模型能够更快地完成推理、检索答案并作出回应,使实时对话真正接近人与人之间的自然交流。 当前的语音模型已经能够生成越来越逼真的声音,但语音自然度的提升并不意味着模型能够准确理解用户需求、及时给出有效答案。
他以企业客服场景为例指出,语音智能体需要在前两三轮对话中让用户感受到它具备解决问题的能力。当用户逐渐建立信任,并确认 AI 能够处理自己的需求时,才可能愿意继续与其交流,甚至不再要求转接人工客服。语音智能体能否获得广泛应用,取决于它在真实交互中解决问题的能力,以及由此建立的用户信任。
Wen 同时提到,自动语音识别(ASR)仍存在漏掉重要关键词的问题,这可能导致模型无法准确获取完整上下文,进而影响后续理解和回应。对于需要连续交流的语音智能体而言,前端识别错误、推理响应速度和最终解决问题的能力,都会影响用户对整个系统的信任。
( @Techcrunch)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考