NVIDIA 开源语音增强模型 NemotronLabs RE-USE,去除噪声、混响与失真丨日报
本期编辑:@三水 @鲍勃
01 有话题的技术
1、NVIDIA 开放多语言语音增强模型 NemotronLabs RE-USE:仅 960 万参数,去除背景噪声、混响与音频失真
NVIDIA 研究团队发布并开放多语言语音增强模型 NemotronLabs RE-USE,仅有 960 万参数,可处理背景噪声、混响、削波、编解码失真及丢包等多种音频质量问题,在改善语音清晰度的同时尽可能保留说话人身份、口音和语音内容。
960 万参数处理多种音频失真: 采用卷积编码器、解码器与 30 层双向 Mamba 架构,支持 8–48kHz 多种采样率和跨语言语音增强;多人重叠发言时优先保留主要说话人。
语音增强改善后续识别效果: NVIDIA 在 URGENT 2025 测试集上的评测显示,经模型处理后,下游 ASR 字符准确率从原始噪声音频的 81.29 提升至 89.17,语音质量和说话人相似度指标也有所改善。
开放模型权重与推理脚本: 模型已在 Hugging Face 发布,支持下载部署及分块处理长录音,采用 OpenMDW 1.1 许可证,允许符合条款的商业使用。
https://huggingface.co/nvidia/NVIDIA-NemotronLabs-RE-USE
2、Huggingface 产品负责人 Victor M 推出浏览器端实时语音数字人 Ava:LFM3-Omni 驱动语音对话,所有推理在本地完成
Huggingface 产品负责人 Victor M 展示浏览器端实时语音数字人 Ava,能够实时倾听用户、生成语音回复,并通过同步的虚拟形象动画做出反应。项目基于 LFM3-Omni、Hugging Face WebGPU 及 TalkingHead 等开源技术构建,模型推理全部在用户设备上执行,无需将对话内容发送至云端进行处理。
LFM3-Omni 实现语音理解与生成: 采用 Liquid AI 的多模态模型处理语音输入与回复生成,支持用户直接通过浏览器与数字人进行实时语音交流。
WebGPU 支持浏览器本地推理: 利用 Hugging Face WebGPU 内核在用户设备上执行模型推理,无需依赖远程推理 API,减少对云端服务的依赖。
数字人动画与语音同步: 结合 TalkingHead 和 HeadAudio 驱动虚拟形象表情、动画及口型同步,将实时语音回复与可视化角色交互整合在浏览器中。目前已开放 Hugging Face 在线体验。
https://huggingface.co/spaces/townbox/ava
3、语音合成研究团队 Empero 开源轻量级 TTS 模型 PiVo-1.4M:仅 140 万参数,5.8MB 模型可在 CPU 本地生成语音
Empero Research 发布并开源轻量级文本转语音模型 PiVo-1.4M,将声学模型与声码器整合在约 140 万参数内,提供 Pi 和 Vo 两种英语音色。模型大小约 5.8MB,基于 ONNX Runtime 和 NumPy 即可在 CPU 上本地运行,无需 GPU、PyTorch 或联网推理。
140 万参数包含完整语音生成链路: 声学模型约 58.5 万参数,负责预测语音特征;基于 FARGAN 的声码器约 81.7 万参数,生成 16kHz 音频,无需额外加载声码器。
支持 CPU 本地推理与分帧播放: 模型先编码完整输入文本,再以 10ms 音频帧逐步生成,支持边生成边播放,无需依赖云端服务。
测试集词错误率为 0.532%: 团队使用 Whisper small.en 评估合成语音的可辨识度,在 152 条测试语句上取得 0.532% WER。目前仅支持两种英语音色,部分语句仍存在金属感或机械感。
https://huggingface.co/empero-ai/PiVo-1.4M
4、墨尔本大学语音 AI 研究者开源音频取证模型 VeriSpoof-Base:支持生成来源追踪、伪造片段定位与可解释检测
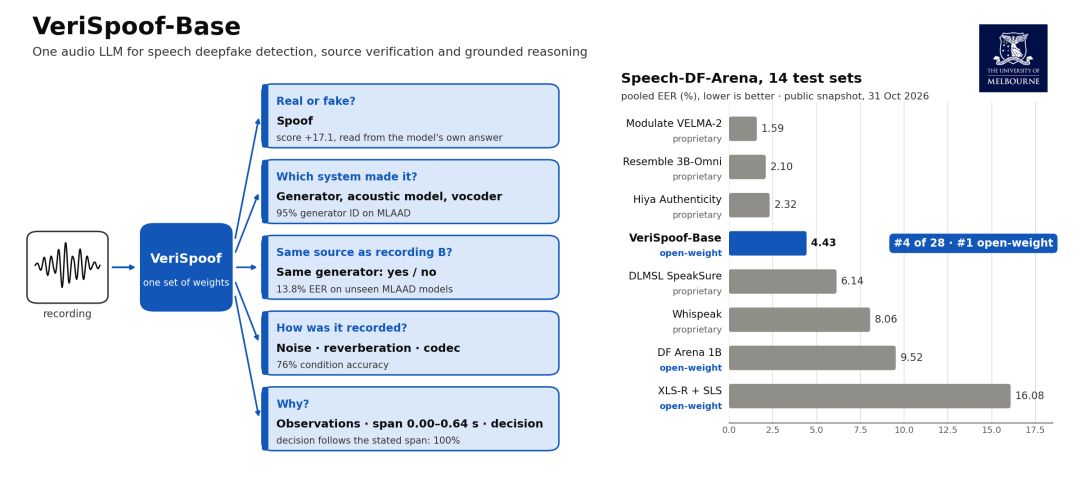
开发者 Austin Xiao 发布并开放音频大模型 VeriSpoof-Base,将语音真假检测、合成来源追踪与可解释分析整合在同一模型中。模型不仅能判断录音是否由 AI 生成,还能分析声学模型、声码器及录音处理痕迹,并指出疑似伪造的时间片段。
单模型支持多项语音取证任务: 可识别语音生成系统、判断两段录音是否来自同一生成器,并分析噪声、混响和音频编码等处理痕迹。
输出可核查的判断依据: 模型结合带宽、信噪比等音频特征与合成片段定位结果生成解释,真假检测分数直接来自模型回答,无需额外的真假分类头。
Speech-DF-Arena 综合排名第四: 在覆盖 14 个测试集的评测中,VeriSpoof-Base 的汇总等错误率(EER)为 4.43%。按团队引用的 10 月 31 日榜单快照,在 28 个系统中排名第四、开放权重系统中排名第一。模型已提供权重、推理代码和在线演示,采用 CC BY-NC 4.0 非商业许可。
https://huggingface.co/AustinXiao/VeriSpoof-Base
02 有亮点的产品
1、Withings 创始人旗下 Invoxia 为宠物智能追踪器 Biotracker 加入 AI 对话:结合实时定位与健康数据,让宠物「开口说话」
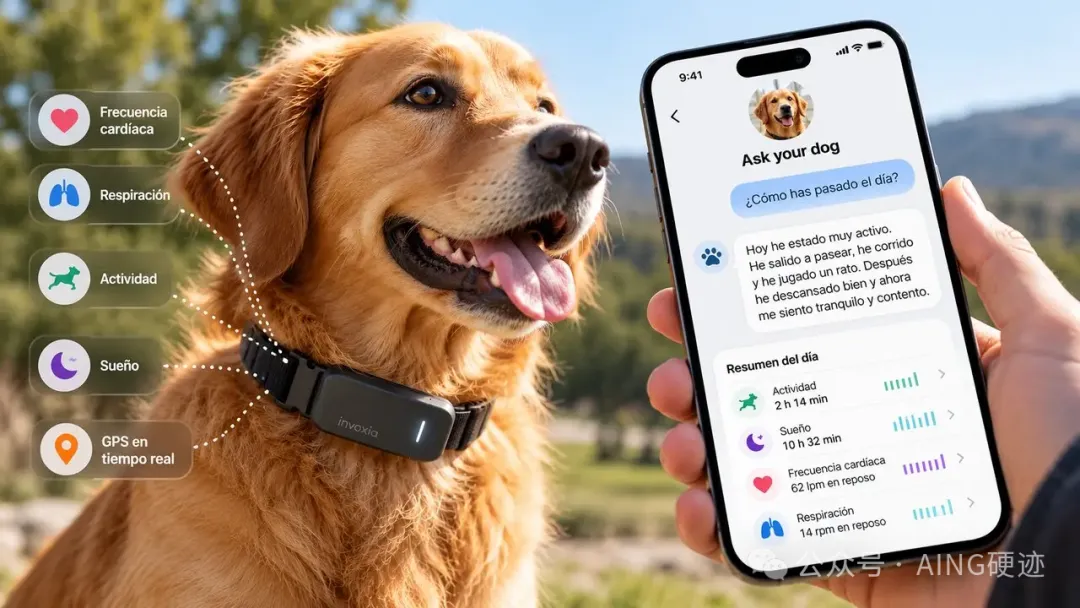
由 Withings 创始人 Eric Carreel 创办的法国物联网公司 Invoxia,为宠物可穿戴设备 Biotracker 推出 AI 对话功能。用户可通过自然语言询问宠物的位置、活动和健康状况,AI 根据项圈采集的数据,以宠物的口吻生成回答,将原本需要查看图表的信息转化为对话交互。
结合实时定位与健康数据生成回答: AI 可查询 GPS 轨迹、心率、呼吸频率、睡眠及活动记录,并结合天气、宠物档案等信息,回答「今天去了哪里」「昨晚睡得怎么样」等问题。
将持续监测数据转化为个性化对话: 支持查询历史活动、健康指标变化及同品种宠物的参考数据。回答以真实采集数据为依据,并非直接翻译宠物叫声或读取其想法。
智能项圈售价 119 美元起: Biotracker 2026 Edition 支持每秒更新的实时 GPS 定位、健康监测及活动识别,AI 对话功能通过配套应用提供,设备联网功能涉及订阅服务。
(@AING 硬迹)
2、西湖大学成立世界模型研究中心:计划三年内构建千亿参数通用世界模型,聚焦物理智能与交互决策
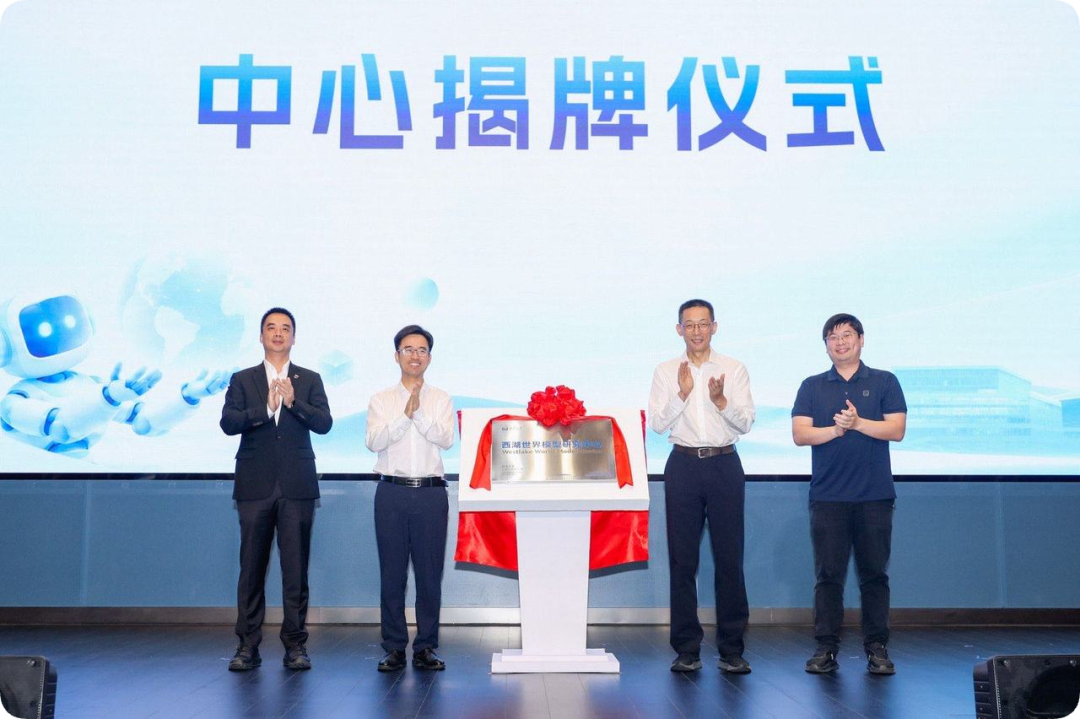
10 月 31 日,西湖大学正式成立西湖世界模型研究中心(Westlake World Model Center),由工学院助理教授于开丞担任主任、金耀初院士担任首席科学家。中心计划在三年内构建千亿参数规模的通用世界模型,重点研究物理规律理解、环境变化预测与自主交互决策,使 AI 能够在执行动作前推演可能的结果。
计划三年内构建千亿参数世界模型: 研究中心将整合感知、认知、预测与行动能力,研发能够理解物理规律、预测行动后果,并通过真实环境反馈持续学习的通用模型。
采用概念世界模型技术路线: 依托西湖大学自主智能实验室 AutoLab 的研究积累,在抽象隐空间中建模物体状态、空间关系、材质特性及因果规律,通过重组物理概念推演未知场景,减少对逐帧像素生成的依赖。
研究成果已延伸至机器人领域: 于开丞团队于 2024 年底转向概念世界模型研究,并在 2026 年初孵化物理世界基础大模型公司西湖数智 Awomo。相关模型已开展机器人精细操作、环境扰动和长时序任务评测,后续将进一步探索通用物理基座与下游任务适配。
(@西湖大学)
03 有态度的观点
1、奥特曼与三星约 50 名高管座谈,讨论 AI 未来十年的商业应用
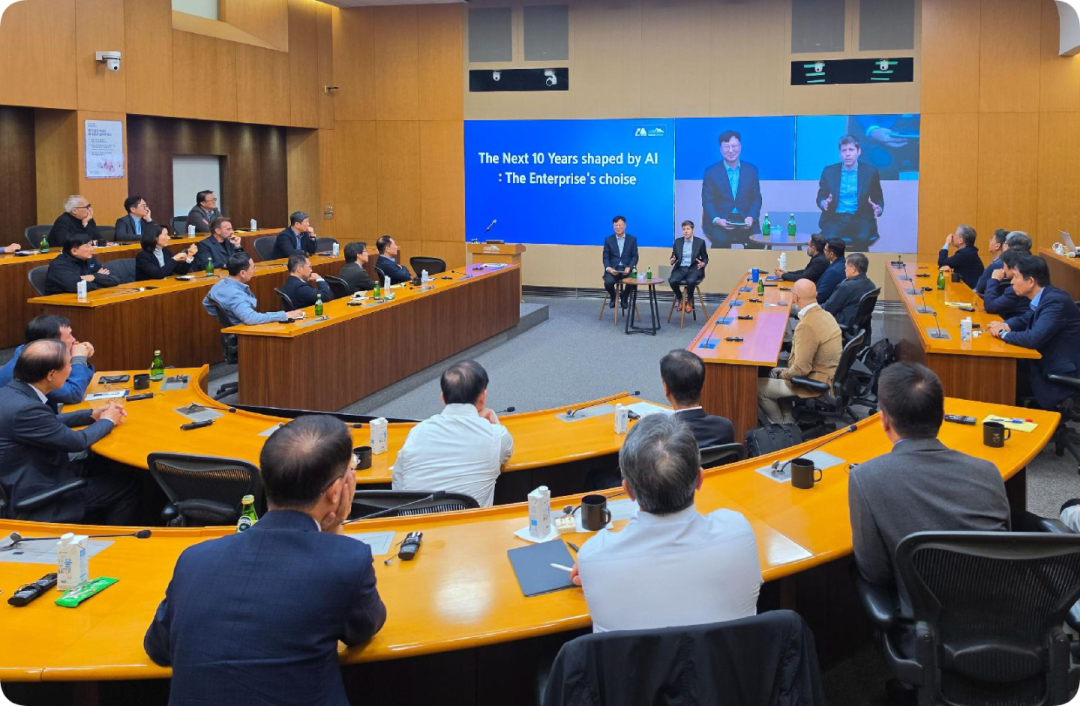
10 月 31 日,OpenAI CEO 萨姆·奥特曼受邀来到韩国龙仁的三星人力开发院,与三星电子、金融、生物医药等业务约 50 名高管举行座谈。三星向韩国媒体介绍,本次主题为「AI 将改变的未来十年:企业的选择」,讨论技术演进、产业应用和新市场机会。
据《每日经济新闻》报道,座谈前,高管还接受了生成式 AI 实操培训,学习整理分散的经营资料、建立个人知识库,并将其用于决策。三星自 6 月起推进覆盖研发、生产、营销和支持部门的 AI 转型,计划将高管培训扩展至普通员工,于 2027 年 2 月完成全员 AI 培训。
双方此前已在 AI 基础设施上展开合作:三星电子与 OpenAI 去年 10 月签署意向书,推进 Stargate 项目的存储芯片供应;三星 SDS 参与 AI 数据中心及企业 AI 服务合作,三星物产和三星重工则推进海上浮式数据中心的共同开发。
( @APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与「RTE 开发者日报」内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考